
الساعة 02:15 تبدأ المعالجة الليلية، وعند 02:40 تستغرق خدمة الوسطاء ست ثوانٍ للرد. لا أحد مستيقظ، ولم يتجاوز أي حد ثابت قيمته، لكن العملاء يشتكون في الصباح. هذه هي المشكلة التي تطرحها مراقبة مهام الدُفعات في Dynatrace: فالمهمة الدفعية (batch) ليست خدمة ولا مضيفًا، بل هي ببساطة تستهلك المعالج والذاكرة وعمليات الإدخال والإخراج في أسوأ لحظة ممكنة. يقترح هذا المقال طريقة لتحديد ما يستحق التنبيه، وما يُترك لـ Davis، وما يمكن أتمتته. تصف الشركة المزوّدة سيناريو قريبًا في مقالها المكوّن من جزأين، وأنطلق هنا من قرار التشغيل لا من تسلسلها.
توضيح منهجي: قرأت المقال وصفحات الوثائق المذكورة بتاريخ 11 نوفمبر 2026، لكنني لم أعد تنفيذ السيناريو في بيئة فعلية. وما لم أستطع تأكيده وسمته «لم يُتحقق منه». المنطق صالح لـ Dynatrace SaaS؛ ولم أتحقق مما يقابله في Managed، لذا لا أَعِد به.
مراقبة مهام الدُفعات في Dynatrace: لماذا تفلت من التنبيهات التقليدية
تطرح المهام الدفعية ثلاث صعوبات. فهي عابرة: يعيش الـ pod ساعة ثم يختفي. وهي دورية: حملها طبيعي عند 02:15 وغير طبيعي عند 14:00. والأهم أنها في الغالب سبب المشكلة لا ضحيتها: فالخدمة المجاورة هي التي تتضرر. لذلك لا يقول التنبيه على معالج المهمة شيئًا؛ المطلوب ربط المهمة بأعراض الخدمة المتأثرة.
السؤال التشغيلي الأول: ماذا تريد أن تعرف؟ تكفي ثلاث إجابات. هل فشلت المهمة؟ هل استغرقت وقتًا غير معتاد؟ هل أضرّت بشيء آخر؟ الأولان يُعالَجان بفحص دوري، والثالث من اختصاص Davis. يوضح مقال الشركة الجزء الأول بـ workflow يقرأ حالة المهام كل 15 دقيقة؛ ولا يحدد المقال حد «الطول المفرط»، وعليك أنت تحديده.
إعطاء Davis سياقًا بحدث بداية وحدث نهاية
يرى Davis المقاييس والتتبعات، لا جدول معالجاتك. ولكي يربط بطئًا ما بمهمة دفعية، أعلن عن المهمة بحدث. تشترط واجهة استيعاب الأحداث (POST /api/v2/events/ingest) الحقلين eventType وtitle فقط؛ ويربط entitySelector الحدث بالخدمة المعنية، وبدونه يلتصق الحدث بالبيئة كلها. ويحتاج رمز الواجهة إلى نطاق الصلاحية events.ingest.
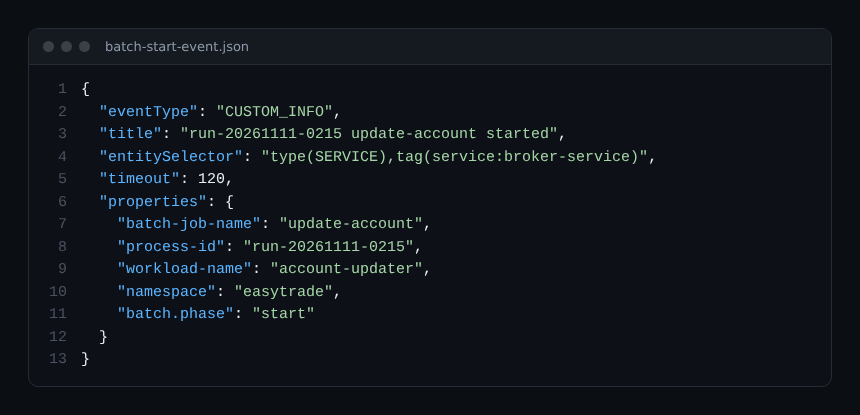
ثلاث نقاط تهم في هذه الحمولة. النوع CUSTOM_INFO إعلامي: لا يفتح مشكلة بمفرده. والمهلة timeout (بالدقائق، القيمة الافتراضية 15 والحد الأقصى 360) تحدد عمر الحدث؛ اضبطها على المدة المعتادة للمهمة. وأخيرًا فالخصائص التي لا تبدأ بـ dt.* حرة، حتى 100 مدخل: ضع فيها اسم المهمة ومعرّف التشغيل وحمل العمل ومساحة الأسماء. وأرسل حدثًا ثانيًا عند الانتهاء بالمعرّف نفسه، لتتمكن من قياس المدد.
ترك Davis يربط البطء بالمهمة الدفعية
بعد وضع الحدث، لم يعد الكشف من شأنك. ففي سيناريو الشركة يلتقط Davis ارتفاع زمن الاستجابة والأخطاء في الخدمة قبل أي بلاغ، وينسب السبب إلى مهمة دفعية أرهقت المعالج والذاكرة وعمليات الإدخال والإخراج في الخدمة المجاورة. والخلاصة التشغيلية: لا تضع حدودًا على المهمة، بل اضبط الكشف على الخدمة التجارية ودع الحدث يقدّم التفسير. بهذا تقلّ الضوضاء، وهو موضوع تناولناه في مقالنا عن ضوضاء تنبيهات Davis.
حدّ ينبغي معرفته: الحدث يُثري السياق ولا يضمن أن يعتمد Davis المهمة سببًا جذريًا. تحقق من ذلك في حادثة حقيقية أو اختبار حمل قبل بناء أتمتة عليه.
تحديد ما يحق لـ workflow فعله بمفرده
هذا هو القرار المحوري، ويسبق أي إعداد. يستطيع الـ workflow أن يبدأ عند مشكلة من Davis، ويفتح بلاغًا، ويختبر شرطًا، ثم يتصرف. اعتمد جدولًا بسيطًا:
- بلا مخاطرة: فتح بلاغ أو التعليق عليه، وإشعار قناة. أتمته من اليوم الأول؛ راجع workflow الربط مع Jira وServiceNow.
- قابل للتراجع: تعليق CronJob أو تأجيل التنفيذ. يمكن أتمتته إن تحقق شرط يؤكد أن المهمة ليست حرجة لإقفال الحسابات.
- غير قابل للتراجع: حذف مهمة قيد التشغيل، أو إعادة تشغيل قاعدة بيانات. اتركه لإنسان.
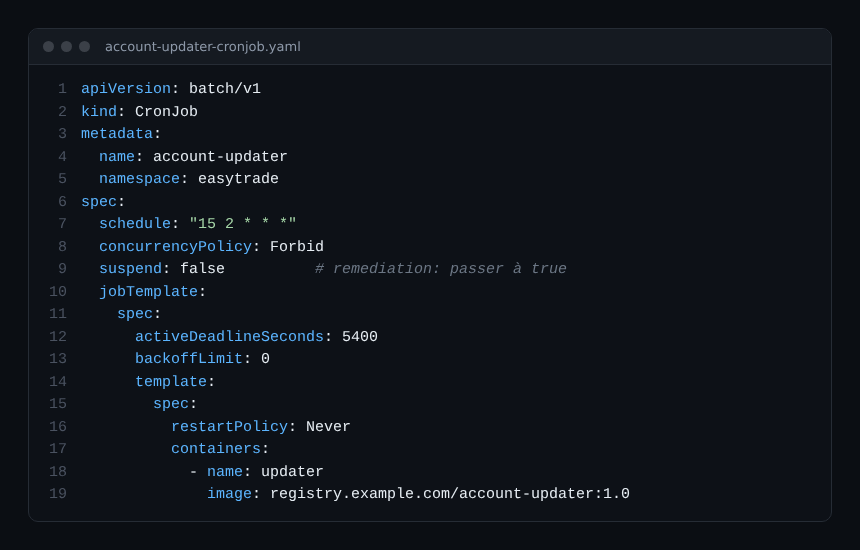
في حالة المهام الدفعية، لتعليق CronJob ميزة: فهو يمس الجدولة القادمة فقط. أما المهمة التي بدأت فتكمل عملها، وإيقاف التنفيذ الجاري إجراء ثانٍ يُقرَّر على حدة. وفي ملف المانيفست ضمانتان موجودتان قبل Dynatrace نفسه: concurrencyPolicy: Forbid يمنع التداخل، وactiveDeadlineSeconds يحدّ المدة.
الوصول إلى العنقود الخاص دون فتح أي منفذ
يعمل الـ workflow من جهة Dynatrace، بينما يجب ألا تُكشف واجهة Kubernetes في عنقود خاص. هنا يأتي دور EdgeConnect: يفتح اتصال WebSocket صادرًا نحو Dynatrace AppEngine ولا يطلب أي اتصال وارد. وتُنفَّذ طلبات HTTP التي يطابق مضيفها نمطًا مُعدًّا داخل شبكتك. وبحسب الوثائق يُعلَن هذا النمط في Settings > General > External Requests > EdgeConnect وليس في ملف YAML.
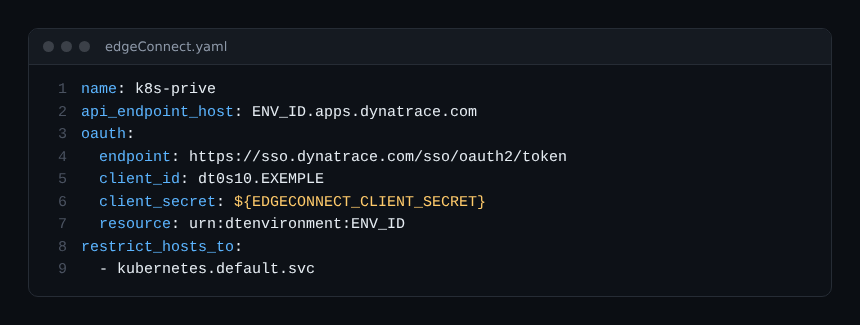
ينبغي أن يملك حساب الخدمة المستخدم مع واجهة Kubernetes الحد الأدنى فقط: صلاحية تعديل (patch) مهام CronJob في مساحة أسماء واحدة. لم أقرأ الصفحة التي تصف الإجراء الدقيق لاستدعاء واجهة Kubernetes من workflow: تفصيل لم يُتحقق منه، فراجعه في محرر الـ workflows.
كيف تتأكد من أن كل شيء يعمل
- أرسل حدث البداية يدويًا على خدمة اختبارية وتأكد من ظهوره على خطها الزمني. يسرد الرد 201 حقل
statusلكل حدث: ابحث عنOKلا عنINVALID_ENTITY_TYPE. - أحدث حملًا حقيقيًا في بيئة ما قبل الإنتاج، لا في الإنتاج.
- تأكد من أن مشكلة Davis تذكر المهمة الدفعية وأن الـ workflow يبدأ.
- تحقق من أن الحقل
suspendفي CronJob صارtrue، وأن البلاغ جرى التعليق عليه لا تكراره. - أعد الاختبار في الاتجاه المعاكس: مشكلة لا علاقة لها بالمهمة الدفعية يجب ألا تُحدث أي تعليق.
ممارسات جيدة
- معرّف تشغيل فريد لكل تنفيذ، يظهر في حدث البداية وحدث النهاية والبلاغ.
- وضع «محاكاة»: يكتب الـ workflow في البلاغ ما كان سيفعله خلال أول أسبوعين.
- استثناء صريح لمهام الإقفال، فلا تُعلَّق تلقائيًا أبدًا.
- حصر صلاحيات Workflows (
automation:workflows:readوadmin) بفريق المنصة؛ وللبدء راجع وحدة Workflows في دورة SaaS. - حفظ سر OAuth الخاص بـ EdgeConnect في خزنة أسرار، وليس في المستودع أبدًا.
الأسئلة الشائعة
هل أحتاج إلى حدث لكل مهمة دفعية؟
نعم، إن أردت أن يتمكن Davis من تفسيرها. فبدون حدث يبقى البطء ظاهرًا لكن سببه لا يرتبط بالمعالجة المجدولة.
هل يستطيع Dynatrace إيقاف مهمة من تلقاء نفسه؟
يستطيع تشغيل workflow يستدعي واجهة Kubernetes عبر EdgeConnect، بشرط أن تكون قد بنيته وأذنت به. ودون هذه السلسلة لا يتوقف شيء.
هل يعمل ذلك على Managed؟
تصف الصفحات التي قرأتها Workflows وEdgeConnect في SaaS. ولم أتحقق من مقابل لهما في Managed، فاعتبر السيناريو خاصًا بـ SaaS.
خلاصة
أعلن عن مهامك الدفعية بحدث، وراقب الخدمة التجارية بدل المهمة، ثم أتمت الإجراءات القابلة للتراجع فقط. ابدأ بالمحاكاة قبل أن تدع workflow يعلّق أي شيء في الإنتاج.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace علامة تجارية لشركة Dynatrace LLC. تحقق دائمًا من القيم (المنافذ والإصدارات والأحجام) في الوثائق الرسمية الخاصة بإصدارك.