يستخدم فريقك حزمة Elastic للسجلات ويتردد في إسناد APM إليها أيضًا، أو ينوي استبدالها: Elastic APM vs Dynatrace هو السؤال الذي يتكرر في كل مراجعة معمارية. يجمع المنتجان التتبعات والمقاييس والسجلات، لكنهما يقومان على خيارات مختلفة جدًا. تضع هذه المقالة جدول معايير يمكنك التحقق منه بنفسك، دون حكم نهائي.
كل معلومة تقنية أدناه مصدرها صفحة رسمية (وثائق Elastic أو docs.dynatrace.com)، قُرئت لهذا الغرض. لا نذكر أي سعر: فالأسعار تتبع العقد وتُقرأ في الصفحات الرسمية. هذا هو النهج نفسه في مقارنتينا Dynatrace vs Datadog وDynatrace vs New Relic. من جهة Dynatrace، المقصود منصة SaaS؛ ويُشار إلى Managed عندما يكون ذلك مهمًا.
Elastic APM vs Dynatrace: الفروق الجوهرية
تصف Elastic منتج APM لديها بأنه نظام «مبني على Elastic Stack»: يقيس أزمنة استجابة الطلبات واستدعاءات قواعد البيانات واستدعاءات HTTP الخارجية، ويجمّع الأخطاء حسب تتبع المكدس (stack trace). أما Dynatrace فتقوم على OneAgent، وهو وكيل واحد لكل مضيف يكتشف العمليات ويفعّل أدوات القياس في مكدس التطبيقات. يلخص الجدول النقاط الموثّقة.
| المعيار | Elastic APM | Dynatrace |
|---|---|---|
| الجمع | وكلاء حسب اللغة، أو SDK وCollector من EDOT (توزيعات OpenTelemetry من Elastic) | OneAgent (قياس تلقائي) أو OTLP، بحسب الخدمة |
| OpenTelemetry | نقطة دخول OTLP مُدارة (Serverless وElastic Cloud Hosted)، وتُخزَّن البيانات بصيغة OTel؛ أما مدخل OTLP في APM Server فيحوّل إلى ECS ولم يعد موصى به للمشاريع الجديدة | واجهة OTLP مباشرة عبر OTLP/HTTP، أو عبر Collector (قياسي أو Dynatrace أو Bindplane)؛ تتبعات ومقاييس وسجلات |
| لغة الاستعلام | ES|QL، لغة قائمة على pipes؛ وQuery DSL | DQL فوق تخزين Grail |
| تحليل السبب | تجميع الأخطاء حسب تتبع المكدس؛ وبقية الوظائف يجب التحقق منها في إصدارك | تحليل السبب الجذري بذكاء اصطناعي سببي فوق طوبولوجيا سببية؛ ويجمع الشذوذات المترابطة في مشكلة واحدة |
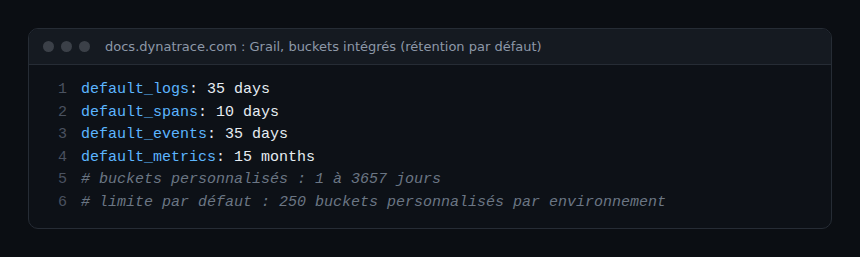
| الاحتفاظ بالبيانات | سياسات ILM (مراحل hot وwarm وcold وfrozen وdelete)؛ ودورة حياة تدفقات البيانات في Serverless | Buckets في Grail: 35 يومًا (السجلات)، 10 أيام (spans)، 15 شهرًا (المقاييس) افتراضيًا؛ وbuckets مخصصة من 1 إلى 3657 يومًا |
| الاستضافة | Serverless أو Cloud Hosted أو ECK أو ECE أو إدارة ذاتية | SaaS، أو Managed على بنيتك التحتية |
| نموذج الفوترة | Observability Serverless: غيغابايت مُستوعَبة وبيانات مخزّنة، تُحتسب كل على حدة | Dynatrace Platform Subscription: قدرات معيارية، مع فوترة الاستيعاب والاحتفاظ والاستعلام كل على حدة للسجلات والتتبعات والأحداث والمقاييس |
بخصوص الاحتفاظ بالبيانات، مدد Dynatrace المذكورة أعلاه هي الواردة في وثائق Grail؛ والـ buckets المدمجة غير قابلة للتعديل.
القياس: وكيل خاص أم OpenTelemetry
بالنسبة لفريق المنصة، السؤال الأول هو جهد البدء. مع OneAgent، تذكر وثائق Dynatrace أن نسخة واحدة لكل مضيف تكتشف جميع العمليات وتقيس المكوّنات الجديدة تلقائيًا. وهو يعمل على كبرى السحابات وKubernetes وDocker وعدة أنظمة منها Linux وWindows.
من جهة Elastic، توصي صفحة APM الآن باستخدام Elastic OpenTelemetry لجمع قياس التطبيقات عن بُعد. تتضمن EDOT مكوّن Collector مخصصًا وSDK (.NET وJava وNode.js وPHP وPython وAndroid وiOS؛ وBrowser في معاينة تقنية). ابتداءً من الإصدار 9.5، أصبحت قدرة Collector في EDOT مدمجة في Elastic Agent. نشرح هذا المسار في المقالة عن Elastic Agent وCollector الخاص بـ OpenTelemetry وفي المقالة عن OTLP وAPM Server.
نقطة تصح في الاتجاهين. توضح Elastic أن أدوات contrib في Collector الأصلي (upstream) يدعمها المجتمع: فلا يستطيع المزوّد تقديم دعم للتنفيذ، ولا يحدث التثبيت التلقائي لمحتوى OpenTelemetry. وتوضح Dynatrace من جهتها أن SDK الخاصة بـ OpenTelemetry لا توفر الوظائف الخاصة بـ RUM (الجلسات وإجراءات المستخدم وCore Web Vitals وSession Replay)؛ وللويب والجوال توصي بـ JavaScript RUM وOneAgent for Mobile. في الحالتين يبقى OpenTelemetry أساسًا قابلًا للنقل، لكن الوظائف الأغنى تمر عبر المسار الخاص بالمزوّد.
الاستعلام واستكشاف البيانات
تقدم المنصتان لغة قائمة على pipes. توصف ES|QL بأنها «لغة قائمة على pipes لتصفية البيانات وتحويلها وتحليلها» في Elasticsearch، بأوامر مثل FROM وSORT وLIMIT. وتستكشف DQL البيانات المخزّنة في Grail (السجلات والمقاييس والتتبعات والأحداث) دون مخطط معرّف مسبقًا، بحسب الوثائق. لسؤال واحد، قارن وضوح القراءة وزمن الكتابة.
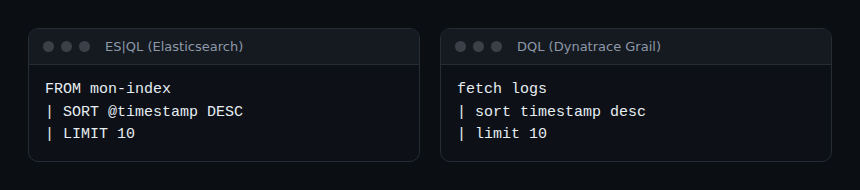
هذان المثالان من إعدادنا، كُتبا بالأوامر المذكورة في الوثائق؛ كيّف اسم الفهرس أو المصدر مع بيئتك.
الاحتفاظ بالبيانات والتشغيل
غالبًا هنا تشعر الفرق بالفرق في العمل اليومي. مع Elasticsearch، يُدار الاحتفاظ بسياسات ILM: تختار متى ينتقل الفهرس من hot إلى warm أو cold أو frozen، ومتى تحذفه مرحلة delete. توضح الوثائق أن ILM غير متاح في Elasticsearch Serverless، حيث تتولى دورة حياة تدفقات البيانات هذا الدور. حرية كبيرة، يصحبها عبء الضبط؛ ولكلفة المستويات الباردة راجع مقالتنا عن مستوى frozen.
مع Dynatrace SaaS، يُضبط الاحتفاظ لكل bucket في Grail. تقليص مدة bucket يحذف نهائيًا البيانات الأقدم، وقد يستغرق الحذف حتى بضعة أيام. للـ buckets المدمجة مدة ثابتة؛ ولاختيار مدة يجب إنشاء bucket مخصص.
أما الاستضافة، فتسرد Elastic خمسة خيارات، من Serverless (تشغّله Elastic) إلى الإدارة الذاتية التي يكون لك فيها «التحكم الكامل والمسؤولية» عن النشر. ويُثبَّت Dynatrace Managed على بنيتك التحتية: تثبّت المجموعة (cluster) وتضبطها، مع توافر عالٍ ومراقبة ذاتية موثّقين. إذا فرضت السيادة الاستضافة الذاتية فكلتا العائلتين تتيحانها؛ وجهد التشغيل يجب تقديره.
كلفة الملكية: ما تقوله الوثائق
لا نقارن الأسعار: فالوحدات مختلفة وأي رقم بلا حجمك سيكون مضللًا. قدّر بحجومك أنت واطلب عرضًا مكتوبًا ومؤرخًا.
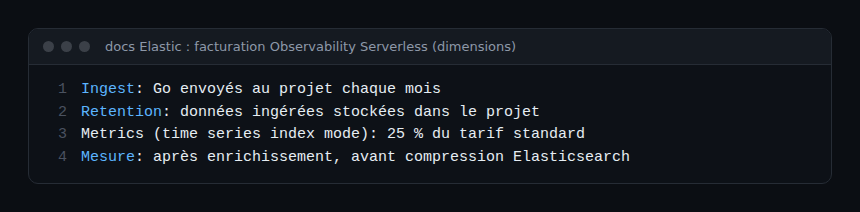
في Elastic Observability Serverless، يُفوتر الاستيعاب على الغيغابايت المرسلة كل شهر، والاحتفاظ على البيانات المخزّنة، وتُحتسب المقاييس بنمط time series بنسبة 25% من التعرفة القياسية. تُقاس الحجوم بعد الإثراء وقبل الضغط، لذلك قد تتجاوز حجم الفهرس الذي يعرضه Elasticsearch. أما Dynatrace فتصوغ عرضها في شكل قدرات؛ وللسجلات والتتبعات والأحداث والمقاييس، الاستيعاب والاحتفاظ والاستعلام ثلاثة بنود منفصلة.
كيف تجري المقارنة عمليًا
- اختر ثلاث خدمات ممثِّلة (تطبيق متكامل، وواجهة API، ومهمة غير متزامنة) وثبّت الجدول قبل البدء.
- أرسل بيانات OTLP نفسها إلى المنصتين بواسطة Collector يضاعف التدفقات، كما في نشر Collector على Kubernetes.
- قِس زمن ثلاثة أعطال مفتعلة (بطء تبعية، وOOMKilled، وخطأ 500 بعد نشر) حتى معرفة السبب.
- اكتب الاستعلام نفسه في ES|QL وفي DQL ودوّن وضوح القراءة.
- احسب ساعات التشغيل: ترقيات الإصدارات، وضبط الاحتفاظ، والدعم.
- أسقِط الفاتورة على ثلاث سنوات انطلاقًا من عروض مكتوبة.
كيف تتحقق من عدالة المقارنة
- حجوم spans المستلمة قابلة للمقارنة على الجانبين في الفترة نفسها؛ وإلا فتحقق من أخذ العينات (انظر tail sampling).
- الاحتفاظ المختبَر متكافئ: bucket للـ spans مدته 10 أيام لا يقارن بفهرس محفوظ 30 يومًا.
- الأشخاص أنفسهم المناوبون يختبرون الأداتين، دون معرفة السيناريو.
أفضل الممارسات
- أبقِ OpenTelemetry أساسًا للقياس: فاختيار المنصة يظل قابلًا للتراجع. وللسياق اقرأ قابلية الملاحظة والمراقبة.
- وثّق كل معيار من الوثائق وأرّخ تاريخ القراءة.
- اكتب تقريرًا blameless: ما نجح وما تعثّر، دون تسمية خاسر.
الأسئلة الشائعة
هل يقبل Elastic APM بيانات OpenTelemetry أصليًا؟
بحسب وثائق Elastic، توجد نقطة دخول OTLP مُدارة على Serverless وElastic Cloud Hosted، مع تخزين بصيغة OTel. أما مدخل OTLP في APM Server، وهو الأقدم، فيحوّل البيانات إلى ECS. تحقق من المسار المناسب لنشرك.
هل يحتفظ Dynatrace بالتتبعات طوال المدة التي يحتفظ بها Elasticsearch؟
افتراضيًا يحتفظ الـ bucket المدمج للـ spans بمدة 10 أيام، بحسب وثائق Grail؛ ويمكن لـ bucket مخصص أن يمتد من 1 إلى 3657 يومًا. أما في Elastic فتتوقف المدة على سياسة ILM أو دورة الحياة لديك. قارن بمدة متساوية.
هل يمكن الإبقاء على الأداتين؟
تقنيًا نعم، مع Collector يضاعف التدفقات. لكن ذلك يضاعف جهد التشغيل؛ وهو أنسب لمرحلة انتقالية منه لهدف نهائي.
الخلاصة
يلبي Elastic APM وDynatrace حاجات متقاربة بفلسفتين مختلفتين: حزمة معيارية تضبطها بنفسك، أو منصة تؤتمت أكثر. الاختيار الصحيح يتوقف على سياقك وحجومك وقيود الاستضافة لديك، لا على ترتيب. جدول يُثبَّت مسبقًا، وبيانات OTLP نفسها، وعروض مكتوبة، تعطي قرارًا يمكن الدفاع عنه.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة Elastic N.V. Dynatrace وElastic علامتان تجاريتان لمالكيهما. الوظائف تتطور: تحقق منها في الوثائق الرسمية (Dynatrace، Elastic APM). تحقق دائمًا من القيم (المنافذ والإصدارات والأحجام) في الوثائق الرسمية الخاصة بإصدارك.