
Son las 02:15, arranca el proceso nocturno, y a las 02:40 el servicio de corredores tarda seis segundos en responder. Nadie se despierta, ningún umbral estático salta, pero por la mañana llegan las quejas de los clientes. Ese es el problema de la supervisión de procesos batch en Dynatrace: un batch no es un servicio ni un host, simplemente consume CPU, memoria y E/S en el peor momento. Aquí propongo un criterio para decidir qué alertar, qué dejar en manos de Davis y qué automatizar. El fabricante describe un escenario parecido en su entrada en dos partes; yo parto de la decisión operativa, no de su guion.
Método: leí la entrada y las páginas de documentación citadas el 11 de noviembre de 2026, pero no reproduje el escenario en un entorno. Lo que no pude confirmar queda marcado como «sin verificar». El razonamiento vale para Dynatrace SaaS; no comprobé el equivalente en Managed, así que no lo prometo.
Supervisión de procesos batch en Dynatrace: por qué escapan a las alertas clásicas
Un batch plantea tres dificultades. Es efímero: el pod vive una hora y desaparece. Es periódico: su carga es normal a las 02:15 y anómala a las 14:00. Y, sobre todo, suele ser la causa y rara vez la víctima: quien sufre es el servicio vecino. Una alerta sobre la CPU del batch no dice nada; hay que enlazar el batch con los síntomas del servicio afectado.
La primera pregunta operativa es qué quieres saber. Bastan tres respuestas. ¿Ha fallado el batch? ¿Ha tardado más de lo normal? ¿Ha degradado algo más? Las dos primeras se resuelven con una comprobación periódica; la tercera es cosa de Davis. En la entrada del fabricante, lo primero se ilustra con un workflow que lee el estado de los jobs cada 15 minutos; allí no se da el umbral de «demasiado largo», y te toca fijarlo a ti.
Darle contexto a Davis con un evento de inicio y otro de fin
Davis ve métricas y trazas, no tu calendario de procesos. Para que relacione una lentitud con un batch, anúncialo con un evento. La API de ingesta de eventos (POST /api/v2/events/ingest) solo exige eventType y title; el entitySelector asocia el evento al servicio afectado, y sin él se queda pegado al entorno. El token de API necesita el scope events.ingest.
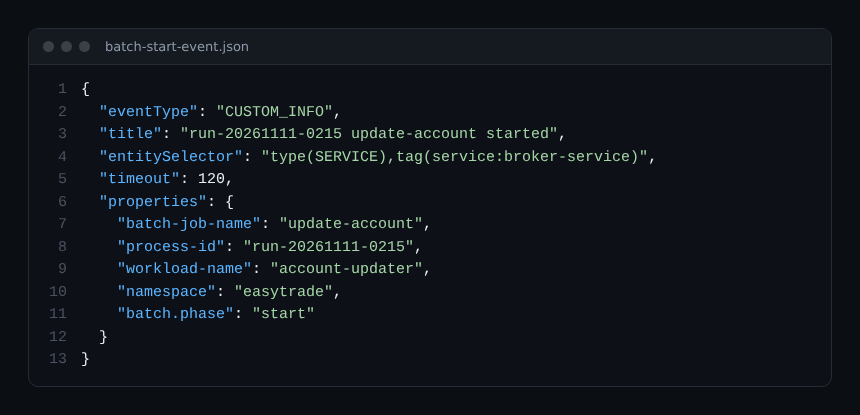
Tres detalles importan en esta carga útil. El tipo CUSTOM_INFO es informativo: por sí mismo no abre ningún problema. El timeout (en minutos, 15 por defecto, 360 como máximo) acota la vida del evento; ajústalo a la duración habitual del batch. Por último, las propiedades que no empiezan por dt.* son libres, hasta 100 entradas: incluye el nombre del job, el identificador de ejecución, la carga de trabajo y el espacio de nombres. Envía un segundo evento al terminar, con el mismo identificador, para poder medir duraciones.
Dejar que Davis conecte la lentitud con el batch
Una vez colocado el evento, la detección ya no es cosa tuya. En el escenario del fabricante, Davis detecta el aumento de latencia y de errores del servicio antes de que llegue ningún ticket, y atribuye la causa a un batch que saturó la CPU, la memoria y la E/S del servicio vecino. Lo que me llevo para operar: no pongas umbrales sobre el batch; configura la detección sobre el servicio de negocio y deja que el evento aporte la explicación. Así baja el ruido, un tema que ya tratamos en nuestro artículo sobre el ruido de las alertas de Davis.
Un límite que conviene conocer: el evento enriquece el contexto, pero no garantiza que Davis elija el batch como causa raíz. Compruébalo con un incidente real o una prueba de carga antes de construir una automatización encima.
Decidir qué puede hacer un workflow por su cuenta
Es la decisión central y va antes de cualquier configuración. Un workflow puede arrancar con un problema de Davis, abrir un ticket, evaluar una condición y actuar. Aplica una rejilla sencilla:
- Sin riesgo: abrir o comentar un ticket, avisar a un canal. Se automatiza desde el primer día; mira el workflow con Jira y ServiceNow.
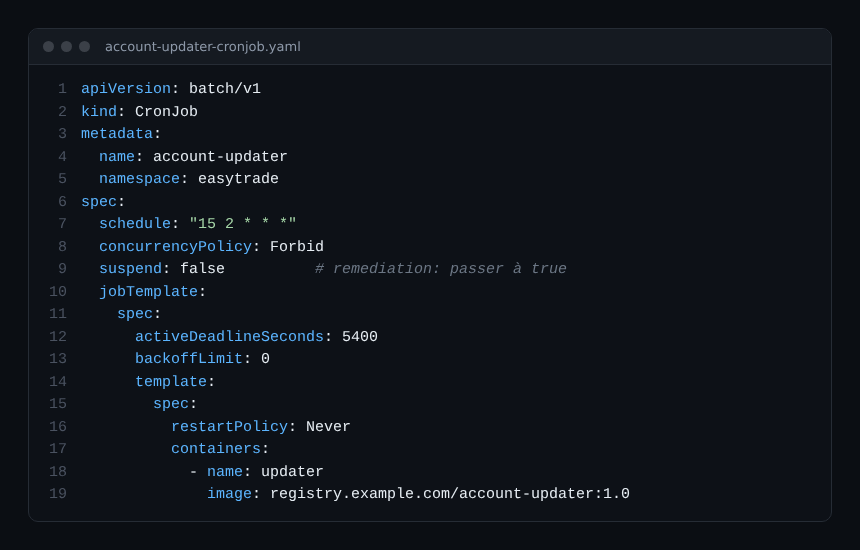
- Reversible: suspender un CronJob, aplazar la ejecución. Automatizable si una condición confirma que el job no es crítico para el cierre contable.
- Irreversible: eliminar un job en curso, reiniciar una base de datos. Resérvalo para una persona.
Para el caso del batch, suspender un CronJob tiene una ventaja: solo afecta a la próxima planificación. Un job que ya arrancó sigue su curso, así que detener la ejecución en marcha es un segundo gesto que hay que decidir aparte. En un manifiesto existen dos salvaguardas incluso antes de Dynatrace: concurrencyPolicy: Forbid evita solapamientos y activeDeadlineSeconds limita la duración.
Llegar al clúster privado sin abrir ningún puerto
Un workflow se ejecuta en el lado de Dynatrace, mientras que la API de Kubernetes de un clúster privado no debe quedar expuesta. EdgeConnect resuelve esto: abre una conexión WebSocket saliente hacia Dynatrace AppEngine y no requiere ninguna conexión entrante. Las peticiones HTTP cuyo host coincide con un patrón configurado se ejecutan entonces dentro de tu red. Según la documentación, ese patrón se declara en Settings > General > External Requests > EdgeConnect, no en el archivo YAML.
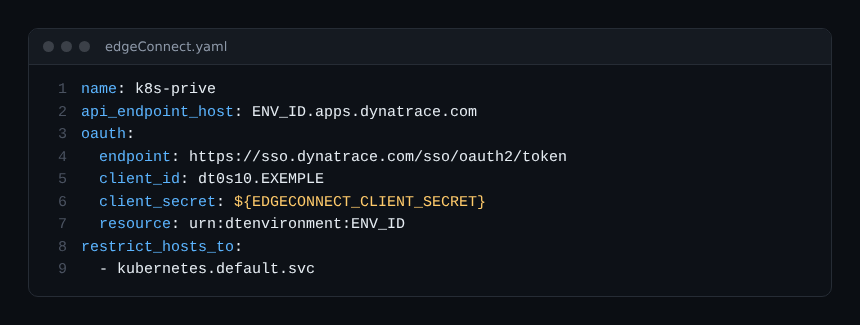
La cuenta de servicio que usa la API de Kubernetes debe tener lo mínimo imprescindible: permiso para modificar (patch) los CronJobs de un único espacio de nombres. No leí la página que describe la acción exacta para llamar a la API de Kubernetes desde un workflow: es un detalle sin verificar, que hay que comprobar en el editor de workflows.
Cómo comprobar que funciona
- Envía a mano el evento de inicio sobre un servicio de prueba y comprueba que aparece en su línea de tiempo. La respuesta 201 lista un
statuspor evento: buscaOK, noINVALID_ENTITY_TYPE. - Provoca una carga real en preproducción, nunca en producción.
- Confirma que el problema de Davis menciona el batch y que el workflow arranca.
- Verifica que el campo
suspenddel CronJob pasa atruey que el ticket se comenta en lugar de duplicarse. - Repite la prueba a la inversa: un problema sin relación con el batch no debe provocar ninguna suspensión.
Buenas prácticas
- Un identificador de ejecución único por run, presente en el evento de inicio, en el de fin y en el ticket.
- Un modo «simulación»: durante las dos primeras semanas el workflow escribe en el ticket lo que haría.
- Una excepción explícita para los batches de cierre, que nunca se suspenden automáticamente.
- Los permisos de Workflows (
automation:workflows:readyadmin) limitados al equipo de plataforma; para empezar, consulta el módulo de Workflows de la formación SaaS. - El secreto OAuth de EdgeConnect guardado en un gestor de secretos, nunca en el repositorio.
Preguntas frecuentes
¿Hace falta un evento por cada batch?
Sí, si quieres que Davis pueda explicarlo. Sin evento, la lentitud sigue siendo visible, pero su causa no queda ligada al proceso planificado.
¿Puede Dynatrace detener un job por sí solo?
Puede disparar un workflow que llame a la API de Kubernetes a través de EdgeConnect, siempre que tú lo hayas construido y autorizado. Sin esa cadena, nada se detiene.
¿Funciona en Managed?
Las páginas que leí describen Workflows y EdgeConnect del lado SaaS. No comprobé ningún equivalente para Managed: considera el escenario válido solo para SaaS.
Conclusión
Anuncia tus batches con un evento, vigila el servicio de negocio en lugar del job y automatiza únicamente los gestos reversibles. Empieza por la simulación antes de dejar que un workflow suspenda nada en producción.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.