صباح يوم الاثنين تعرض قائمة Problems أربعين إدخالًا فُتحت خلال عطلة نهاية الأسبوع. ثلاثة منها فقط تخص حادثة حقيقية، والباقي مصدره مهمة دفعية ليلية، وخدمة اختبار تتلقى طلبين في الدقيقة، وإعادة تشغيل مجدولة. هذه التنبيهات الكاذبة في Dynatrace Managed ليست أخطاء في Davis: إنها إعدادات افتراضية طُبقت على سياق لا تعرفه.
يفصّل هذا الدليل، رافعةً رافعة، موضع ضبط كل مصدر ضجيج في الواجهة، ومتى يُستخدم كل إعداد، وكيف يُؤتمت بواسطة Settings API. وينتهي بطريقة لقياس عدد المشكلات قبل التغييرات وبعدها، لإثبات المكسب لفريق المناوبة.
المحتوى موجه إلى Dynatrace Managed (الواجهة الكلاسيكية وSettings API v2 وProblems API v2). توجد مخططات settings المذكورة في SaaS أيضًا، لكن اكتشاف الشذوذ على Grail (كاشفات Davis anomaly detectors وDQL) لا يُعالج هنا. وللمقاربة الموجهة إلى إرهاق المناوبة وملفات الإشعار انظر المقال تقليل الضجيج والتنبيهات وإرهاق المناوبة: أما هذا فيركز على مصدر المشكلات نفسه.
لماذا يفتح Davis مشكلات لا فائدة منها
يقارن Davis كل إشارة بمرجع. وعندما يكون المرجع سيئًا أو السياق غائبًا يفتح مشكلة مشروعة إحصائيًا لكنها بلا نفع للفريق. وأشيع الأسباب:
- حركة قليلة: في خدمة تتلقى بضعة طلبات في الدقيقة يزيح طلب بطيء واحد الوسيط. وتقول الوثائق ذلك بنفسها: إن بناء خط مرجعي (baseline) والتنبيه على تطبيقات قليلة الحركة ينتج غالبًا تنبيهات لا فائدة منها.
- baseline قديم: فترة المرجع الافتراضية 7 أيام. وبعد إصدار يغيّر ملف الأداء يقارن Davis الإصدار الجديد بالقديم.
- أحداث مخطط لها: صيانة واختبارات حمل وإيقافات مجدولة. وبدون Maintenance window تشبه حوادث وتلوّث الـ baseline.
- عتبات سيئة الاختيار: عتبة ثابتة على مقياس متقلب، أو عتبة تكيفية على مقياس يجب أن يبقى تحت حد مطلق.
- metric events شديدة الحساسية: نافذة منزلقة قصيرة جدًا، أو تفعيل التنبيه عند البيانات المفقودة على سلسلة متفرقة.
ميّز بين عائلتين من الروافع: ما يمنع اكتشاف المشكلة (Anomaly detection وMaintenance windows وFrequent issue detection وmetric events)، وما يمنع الإشعار فقط (Alerting profiles وProblem notifications). تقلل الأولى التنبيهات الكاذبة؛ وتقلل الثانية الضجيج المحسوس.
الخطوة 1: قِس الضجيج قبل لمس الإعدادات
دون قياس أولي يستحيل معرفة هل أفاد إعداد ما. اجلب مشكلات آخر 30 يومًا بواسطة Problems API v2 (نقطة النهاية GET /api/v2/problems، ورمز بالنطاق problems.read) وعُدّها حسب العنوان:
# Problèmes fermés des 30 derniers jours, regroupés par titre
curl -s -H "Authorization: Api-Token $DT_TOKEN" \
  "https://<votre-domaine>/e/<environment-id>/api/v2/problems?from=now-30d&pageSize=500&problemSelector=status(%22closed%22)" \
  | jq -r '.problems[] | [.severityLevel, .title] | @tsv' \
  | sort | uniq -c | sort -rn | head -20
يأخذ الحقل severityLevel خصوصًا القيم AVAILABILITY وERROR وCUSTOM_ALERT وMONITORING_UNAVAILABLE؛ وتُقدَّر startTime وendTime بالميلي ثانية UTC، مما يتيح حساب مدة كل مشكلة. وما فوق 500 نتيجة اتبع nextPageKey. دوّن ثلاثة مؤشرات: عدد المشكلات في الأسبوع، ونسبة المشكلات الأقصر من 10 دقائق (وهي غالبًا تذبذبات)، وأعلى 5 عناوين متكررة. وهذه الخمسة هي التي تحدد ترتيب الإعدادات.
الخطوة 2: ضبط Anomaly detection لكل خدمة وتطبيق ومضيف
الخدمات: تكيفي أم عتبة ثابتة
المسار العام: Settings > Anomaly detection > Services. يكتشف Dynatrace هنا أربعة أنواع مستقلة من الشذوذ: تدهور زمن الاستجابة، وارتفاع معدل الفشل، وانخفاض الحمل، وذروة الحمل. ولزمن الاستجابة ومعدل الفشل اختر بين automatically (baseline) وusing fixed thresholds.
- تلقائي: ينطلق التنبيه إذا تجاوز وسيط كل الطلبات (أو أبطأ 10% منها) العتبة المطلقة (ms) والنسبية (%) معًا. ارفع العتبة المطلقة لتجاهل انحرافات بضعة ميلي ثوانٍ في الخدمات السريعة.
- ثابت: يفضَّل لطلب خاضع لـ SLA أو لمهلة (timeout) معروفة. يضبط الحقل Sensitivity (Low وMedium وHigh) الثقة الإحصائية: يتجاهل Low الانتهاكات القصيرة الناجمة عن ذروة حمل، وينبّه High عند كل انتهاك.
خياران اختياريان يزيلان معظم ضجيج الحركة القليلة: عتبة الإجراءات في الدقيقة التي لا تُقيَّم الخدمة دونها، والحد الأدنى لمدة الحالة الشاذة قبل التنبيه. وفي المخطط builtin:anomaly-detection.services يقابلهما الكائن overAlertingProtection (requestsPerMinute وminutesAbnormalState).
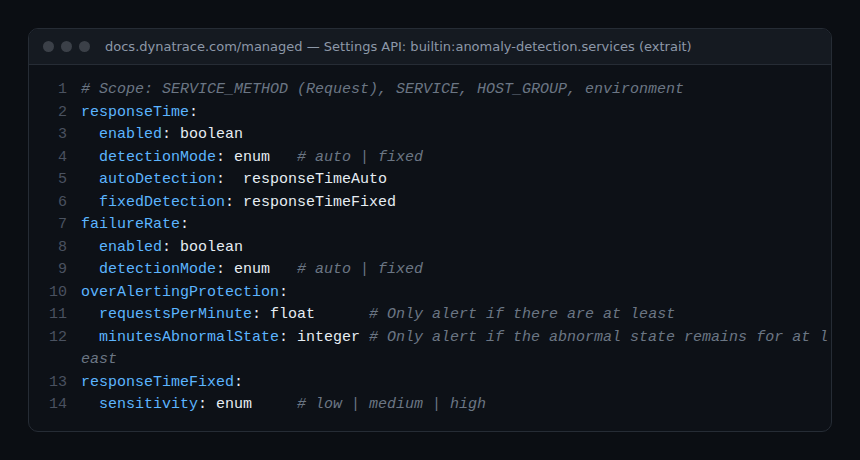
لخدمة واحدة افتح Services، واختر الخدمة، ثم القائمة … > Settings > Anomaly detection وعطّل Use global anomaly detection settings. يحل إعداد الخدمة محل العام لهذه الخدمة وحدها.
الطلبات: تعطيل التنبيه على طلب غير حرج
قد يُضعف طلب فحص صحة أو تصدير ليلي وسيط خدمة دون أي أهمية تجارية. صنّفه key request، ثم في القسم Set thresholds on key requests عطّل Use service or global settings: يمكنك حينئذ خفض التنبيه أو رفعه أو تعطيله لهذا الطلب وحده. ويقبل المخطط النطاق SERVICE_METHOD.
التطبيقات والبنية التحتية
في التطبيقات يسري المنطق نفسه بحد أدنى من الإجراءات في الدقيقة (10 في مثال الوثائق) لاستبعاد التطبيقات قليلة الحركة. وفي المضيفين (Settings > Anomaly detection، قسم Infrastructure) إعدادان يتجنبان تنبيهات كاذبة كلاسيكية: إبقاء التنبيهات على الإيقاف النظيف معطلة (افتراضيًا لا تنبّه إلا الانقطاعات غير المتوقعة)، وإنشاء Custom disk-detection rules لعدم التنبيه على مساحة قرص إقلاع ثابت الحجم. وتتغلب القاعدة الأكثر تحديدًا (مضيف أو host group أو بيئة).
إعادة ضبط baseline بعد إصدار
بعد تغيير كبير يمحو الزر Reset الخاص بفترة المرجع الأيام السبعة السابقة ويعيد التعلم. وتذكّر أن الاكتشاف التلقائي للشذوذ لا يتاح إلا للخدمات والتطبيقات التي اشتغلت 20% على الأقل من أسبوع.
الخطوة 3: Maintenance windows وFrequent issue detection
المسار: Settings > Maintenance windows > Monitoring, alerting, and availability، ثم Create maintenance window. الخيار الحاسم هو Problem detection and alerting:
- Detect problems and alert: لا شيء يتغير، وتعلّم أيقونة المشكلة؛
- Detect problems but don’t alert: تبقى المشكلة ظاهرة في Problems دون إشعار. وهو الخيار الأنسب لنشر إنتاجي مراقَب؛
- Disable problem detection: لا مشكلة ولا تنبيه. احتفظ به للإيقافات الكاملة.
تُستبعد الفترات المشمولة من حساب خطوط baseline، مخططةً كانت أو لا: عرّف نافذة قبل كل اختبار حمل، ونافذة Unplanned بأثر رجعي لعطل مضى. قيّد النطاق دائمًا بالمرشحات (نوع الكيان والوسوم ومناطق الإدارة): بدون مرشح تشمل النافذة البيئة كلها. والحد 2000 نافذة لكل بيئة. وفي API يأخذ الحقل suppression القيم DETECT_PROBLEMS_AND_ALERT وDETECT_PROBLEMS_DONT_ALERT وDONT_DETECT_PROBLEMS.
تحوّل Frequent issue detection (المخطط builtin:anomaly-detection.frequent-issues) إلى frequent issue كل مشكلة تُكتشف عدة مرات في اليوم خلال أسبوع ولا تتفاقم؛ ويُقطع التنبيه عندئذ، ثم يُعاد تفعيله إذا ساء الوضع. أبقها مفعّلة: تعطيلها (حسب المستوى: التطبيقات والخدمات والبنية التحتية والبيئة) يُعيد كل حدوث تنبيهًا جديدًا. لكن لا تعدّها حلًا: الـ frequent issue خلل مزمن يجب إصلاحه أو عتبة يجب مراجعتها.
الخطوة 4: ضبط metric events لتفادي التنبيهات الكاذبة في Dynatrace Managed
المسار: Settings > Anomaly detection > Metric events. يجمع كل إعداد مصدرًا (metric key أو metric selector) واستراتيجية (static threshold أو auto-adaptive threshold أو seasonal baseline؛ والأخيرتان في metric selector فقط) ونافذة منزلقة، تُضبط في Advanced properties:
violatingSamples: عدد العيّنات (الدقيقة الواحدة) التي يجب أن تنتهك العتبة (3 افتراضيًا)؛samples: حجم النافذة (5 افتراضيًا، حتى 60 دقيقة)؛dealertingSamples: عيّنات عادت إلى الطبيعي لإغلاق الحدث (5 افتراضيًا).
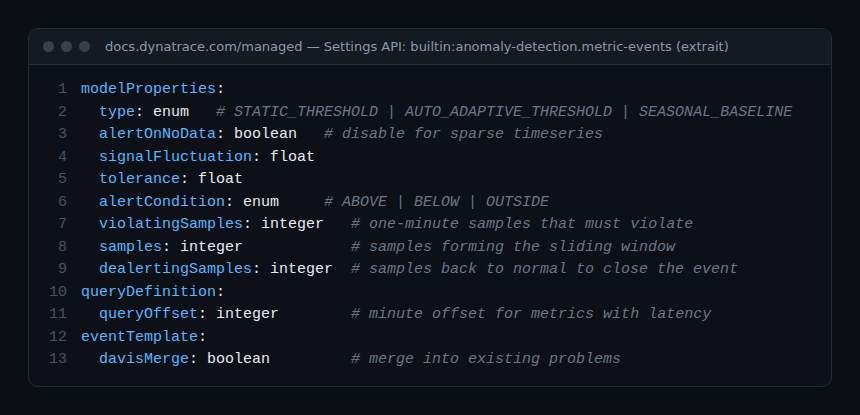
لمقياس مضطرب انتقل مثلًا إلى 10 انتهاكات من 15 عيّنة: لا يطلق شيئًا ذروة معزولة. وارفع dealertingSamples إذا كانت مشكلة تُفتح وتُغلق في حلقة. وعطّل alertOnNoData على السلاسل المتفرقة (تحذر الوثائق من أنه يسبب عواصف تنبيهات)، ولمقاييس تصل متأخرة 5 دقائق استخدم queryOffset أو نافذة لا تقل عن 10 دقائق. وفي النمط التكيفي ارفع signalFluctuation؛ وفي seasonal baseline ارفع tolerance. أبقِ davisMerge مفعّلًا ليربط Davis الحدث بمشكلة قائمة بدل فتح مشكلة جديدة. واستخدم المعاينة (preview) قبل الحفظ: تُظهر كم حدثًا كان الإعداد سيطلق. ولصيغة المحددات انظر وحدة metric selector والتنبيهات.
اختر عتبة ثابتة لحد مطلق (ذاكرة عملية معروفة: العتبة التكيفية ستتبع تسربًا بطيئًا دون أن تنبّه أبدًا) واختر عتبة تكيفية لمقياس متقلب يتغير مستواه، كزمن الكتابة على القرص. انتبه: إعدادات النمط التكيفي محدودة بـ 100 لكل بيئة.
الخطوة 5: Alerting profiles وProblem notifications
لا تزيل هذه الروافع أي مشكلة: إنها تقرر من يُنبَّه. المسار: Settings > Alerting > Problem alerting profiles، ثم Add alerting profile. يجمع النطاق بالمنطق AND منطقة إدارة وقواعد severity (مجمّعة بالمنطق OR، 100 كحد أقصى) ومرشحات أحداث.
- المهلة: لا يرسل
delayInMinutesالإشعار إلا إذا بقيت المشكلة مفتوحة أكثر من X دقيقة. مهلة من 10 إلى 15 دقيقة علىPERFORMANCEتزيل التذبذبات القصيرة المقيسة في الخطوة 1، مع إبقاءAVAILABILITYعند 0. - الوسوم:
tagFilterIncludeMode(NONEوINCLUDE_ANYوINCLUDE_ALL). المطابقة تامة: المفتاح وحده لا يطابق إلا وسمًا بلا قيمة. وتوصي الوثائق بوسوم يدوية لا آلية. - منطقة الإدارة: اختزل كل ملف إلى نطاق الفريق (انظر مناطق الإدارة والوسوم).
تعتمد Problem notifications (Slack وPagerDuty وOpsgenie…) بعد ذلك على ملف. التكامل الموصول بالملف Default يتلقى كل شيء: وهذا أول ما يجب فحصه. وتفصيل التكاملات في ملفات التنبيه والتكاملات.
الخطوة 6: الأتمتة باستخدام Settings API
كل إعداد مما سبق كائن في Settings API v2. صدّر الحالة الحالية قبل أي تعديل (رمز بالنطاق settings.read):
curl -s -H "Authorization: Api-Token $DT_TOKEN" \
  "https://<votre-domaine>/e/<environment-id>/api/v2/settings/objects?schemaIds=builtin:anomaly-detection.services&scopes=environment" \
  | jq '.items[].value' > services-avant.json
المخططات المفيدة: builtin:anomaly-detection.services وbuiltin:anomaly-detection.metric-events وbuiltin:anomaly-detection.frequent-issues وbuiltin:alerting.maintenance-window وbuiltin:alerting.profile. تمر الكتابات عبر POST /api/v2/settings/objects (النطاق settings.write)؛ ويتحقق المعامل validateOnly=true دون حفظ، وهو مفيد في CI. ولإدارة إصدارات المجموعة كلها يتولى Monaco هذه المخططات نفسها في ملفات.
سيناريوهات عملية
- خدمة داخلية بـ 3 طلبات/د تنبّه كل ليلة:
requestsPerMinuteعند 10 على مستوى الخدمة، وminutesAbnormalStateعند 5. - نشر أسبوعي كل ثلاثاء: Maintenance window من نوع Weekly، ونطاق بوسم التطبيق، والنمط Detect problems but don’t alert.
- metric event للـ CPU يُفتح ويُغلق كل 10 دقائق: 5 انتهاكات من 10، و
dealertingSamplesعند 10. - بيئة قبول في العنقود نفسه: حساسية Low على منطقة إدارتها، وملف تنبيه بمهلة 30 دقيقة.
كيف تتحقق من أن النتيجة صحيحة
بعد أسبوعين أعد تشغيل استعلام الخطوة 1 على المدة نفسها وقارن المؤشرات الثلاثة. في Problems يسرد المرشح Under maintenance المشكلات التي وقعت أثناء نافذة. أما metric event فتبيّن النظرة العامة خلال 24 ساعة الإعدادات التي حالتها THROTTLED أو QUERY_FAILED أو CONFIG_BLOCKED. وتحقق أخيرًا من أن الحوادث الحقيقية المعروفة في الفترة ما زالت تُكتشف: انخفاض الضجيج بإخفاء حادثة حقيقية تراجع لا مكسب.
أفضل الممارسات
- إعداد واحد في كل مرة، مقيس وموثق في تحليل ما بعد الحادثة (post-mortem) أو سجل التغييرات.
- اضبط على أدق مستوى (خدمة أو طلب أو host group) قبل لمس العام.
- لا تعطّل أبدًا اكتشاف AVAILABILITY لخفض عدّاد.
- صدّر الإعدادات قبل كل تعديل لتتمكن من الرجوع.
الأسئلة الشائعة
هل يجب تحويل كل الخدمات إلى عتبات ثابتة؟
لا. تلائم العتبات الثابتة الطلبات ذات SLA أو المهلة المعروفة. وفي الباقي، يعطي الـ baseline التلقائي مع عتبة مطلقة مرتفعة وحماية من الحركة القليلة تنبيهات كاذبة أقل من عتبات ثابتة سيئة الصيانة.
هل تقلل المهلة في ملف التنبيه عدد المشكلات؟
لا، تقلل الإشعارات فقط. تبقى المشكلة في Problems وفي الإحصاءات. ولإزالة الاكتشاف اضبط Anomaly detection أو metric events أو Maintenance window.
هل تصلح هذه الإعدادات لـ Dynatrace SaaS؟
توجد مخططات settings المذكورة في SaaS أيضًا. لكن في بيئة SaaS حديثة مع Grail تقوم كاشفات الشذوذ الجديدة على DQL: منطق النافذة المنزلقة قريب، لكن الإعداد يختلف.
الخلاصة
خفض التنبيهات الكاذبة يعني إعادة السياق الناقص إلى Davis: حد أدنى للحركة، وفترات مخطط لها، وعتبات تلائم كل مقياس، ونوافذ انتهاك واقعية. قِس، واضبط رافعة واحدة، ثم قِس من جديد. المناوبة التي تثق في Problems تتفاعل أسرع، وMTTR هو المستفيد.
للتوسع: Anomaly detection configuration وAdjust the sensitivity of anomaly detection for services (وثائق Dynatrace Managed).
span.observer مدوّنة مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace وDavis علامتان تجاريتان لشركة Dynatrace LLC. المعلومات مأخوذة من الوثائق العامة؛ تحقق منها في إصدارك قبل أي تعديل في الإنتاج.