خدمة تستجيب في 4 ثوانٍ بدل 300 ms، ويرتفع معدل الأخطاء، وتتقاذف ثلاثة فرق المسؤولية. تقول المقاييس إن هناك مشكلة لا أين تقع. وتجيب Distributed traces Dynatrace Managed عن هذا السؤال: فهي تتبع الطلب من أوله إلى آخره خدمة بعد خدمة حتى الدالة التي تستهلك الوقت.
يبيّن هذا الدليل العملي كيف تستخدم عرض Distributed traces (Distributed Traces Classic) يوميًا: ترشيح آلاف الطلبات للإبقاء على ثلاثة فقط، وقراءة الـ waterfall، والنزول إلى الكود، والوصول إلى السجلات، ومعرفة حدود الاحتفاظ الخاصة بـ Managed. ويفصّل قسمان عمليان تشخيص طلب بطيء في خمس خطوات والمزالق الواجب معرفتها: أخذ العينات والتتبعات الناقصة وrequest attributes المفقودة. كل سيناريو (البطء والأخطاء واستدعاء طرف ثالث وقاعدة البيانات والتراجع بعد النشر) مرتبط بتحسين في MTTR.
النطاق: المحتوى صالح لـ Dynatrace Managed. يقدم Dynatrace SaaS العرض الكلاسيكي نفسه، لكن أيضًا تطبيق Distributed Tracing القائم على Grail وDQL، وهو غير موجود في Managed.
PurePath والتتبع وspan: المفردات المفيدة
تعرّف وثائق Managed التتبع الموزّع (distributed trace) بأنه سلسلة من الـ spans (وحدات العمل داخل التتبع) يميّزها trace ID فريد، وتتبع مسار طلب عبر الخدمات. يمثل الـ span عملية واحدة؛ والـ span الذي لا أصل له هو trace root span. تدل PurePath على التتبعات التي يلتقطها OneAgent؛ أما التتبعات المجهَّزة بمكتبات أخرى (OpenTelemetry مثلًا) فتظهر باسم Ingested traces.
ينتقل السياق من خدمة إلى أخرى عبر الترويسات: x-dynatrace (صيغة خاصة) وtraceparent وtracestate (W3C، يشترك فيها OneAgent وOpenTelemetry)، وdtdTraceTagInfo لبعض أنظمة المراسلة. وإذا حذف وكيل (proxy) أو بوابة هذه الترويسات انقطع التتبع إلى نصفين: وهذا السبب الأول لـ «التتبع الناقص». وبشأن قوائم الرسائل انظر نشر السياق مع Kafka.
المتطلبات
- بيئة Dynatrace Managed مع OneAgent بنمط full-stack على العمليات المراد تتبعها (يتطلب مستوى الكود OneAgent).
- مناطق إدارة جاهزة: تقتصر قائمة التتبعات على المنطقة المحددة (انظر مناطق الإدارة والوسوم).
- لواجهة request attributes البرمجية: رمز (token) بالنطاق
ReadConfig(قراءة) وCaptureRequestData(إنشاء). - لبيئة مختلطة من OneAgent وOpenTelemetry: تفعيل W3C Trace Context في Settings > Preferences > OneAgent features (Send W3C Trace Context HTTP headers وSend W3C Trace Context gRPC headers).
استخدام Distributed traces Dynatrace Managed خطوة بخطوة
- افتح العرض. القائمة Distributed traces، أو من خدمة: Services > More (…) > Distributed traces التي ترشّح مسبقًا على هذه الخدمة.
- اضبط الفترة ومنطقة الإدارة. يعرض الرسم Overview عدد الطلبات وزمن الاستجابة. وما بعد 10 أيام فعّل Show data retention لترى أي البيانات ما زالت متاحة.
- اختر المصدر. PurePaths لـ OneAgent، وIngested traces لتتبعات OpenTelemetry أو المكتبات الأخرى.
- رشِّح بـ Filter requests (التفاصيل أدناه)، ثم رتّب القائمة حسب Start time أو Name أو Response time أو Processing time أو HTTP method أو Response code.
- وسّع سطرًا للحصول على نظرة سريعة (الطوبولوجيا والسمات وHTTP والتوقيتات)، ثم اختر اسم التتبع.
- اقرأ التتبع: Execution breakdown لتوزيع الوقت، وwaterfall لترتيب الخدمات، ثم مقطعًا لفتح تبويبات التفاصيل.
المرشحات والتركيبات المفيدة
تعرض القائمة 3 000 تتبع هي الأحدث على الأكثر ضمن الفترة ومنطقة الإدارة. وعلى خدمة مزدحمة تغرق النافذة الواسعة جدًا الطلب المهم: رشِّح قبل أن تقرأ.
| المرشح | الاستخدام |
|---|---|
| الفترة | حصر الحادثة أو النشر بأضيق نطاق |
| منطقة الإدارة | عدم رؤية سوى التطبيق أو الفريق المعني |
| طريقة الاستيعاب | PurePaths (OneAgent) أو Ingested traces |
| Service name | الانطلاق من الخدمة المتضررة |
| Response time (≥، ≤) | عزل الطلبات البطيئة فوق عتبة |
| Request attributes | استهداف عميل أو بلد أو سلة أو إصدار |
| البحث (trace ID) | العثور على التتبع المذكور في سجل أو تذكرة |
تركيبات كثيرة الفائدة:
- الخدمة + Response time ≥ عتبة SLO: الطلبات التي تستهلك ميزانية أخطاء زمن الاستجابة وحدها. في مثال الوثائق يختزل هذا المرشح 249 000 طلب إلى 3.
- الخدمة + الترتيب حسب Response code: تظهر أخطاء 5xx في الأعلى، جاهزة لتبويب Errors.
- Request attribute + Response time: «هل هذا العميل المميز أبطأ من غيره؟».
- مرشح service flow: في View service flow، اختر خدمة مستدعاة ثم Apply filter، وأضف خدمة ثانية، وافتح Distributed traces على المستدعي. تحصل على الطلبات التي تمر عبر سلسلة الاستدعاءات هذه فقط.
تحليل تتبع: waterfall والتوقيتات ومستوى الكود والسجلات
يُظهر الـ waterfall أي الخدمات يعبرها التتبع وبأي ترتيب. وتدل مواضع الأشرطة وألوانها على التسلسل وزمن استجابة كل طلب: شريطان متداخلان ينفَّذان بالتوازي. اختر مقطعًا لفتح التبويبات:
- Summary: البيانات الوصفية والترويسات والمعاملات والوكيل. خمس نجوم (
*****) تخفي بيانة سرية، ويمكن كشفها بالصلاحيات المناسبة؛ وثلاث نجوم أو أقل تُستخدم للتجميع ولا يمكن كشفها. - Timings: View method hotspots يفصّل CPU وwait وsync وlock ووقت التنفيذ.
- Code level: شجرة الدوال المنفَّذة ومددها بترتيبها الفعلي. يختلف حجم التفاصيل بحسب الأهمية والكلفة: الأجزاء البطيئة من الطلب تحوي عادة تفاصيل أكثر. وتُرى مدد الاستدعاءات البعيدة من جهة العميل.
- Logs: سجلات ضمن سياق المعاملة، إذا كان إثراء السجلات مفعَّلًا. يقصر Strict span filter العرض على العقدة المحددة؛ ويعرض View logs for this trace كل شيء.
- Errors وThreads وIntegrations بحسب التقنية.
والمسار العكسي ممكن أيضًا: في سجل مُثرى، الخاصية trace_id قابلة للنقر وتفتح التتبع. ولما يقابل ذلك في OpenTelemetry انظر ربط السجلات والتتبعات عبر trace ID.
تشخيص طلب بطيء في 5 خطوات
تبقى الحالة الأكثر شيوعًا هي الطلب البطيء الذي يبلّغ عنه مستخدم أو يكشفه SLO لزمن الاستجابة. هذا هو التسلسل الذي يوفر أكبر قدر من الوقت.
- رشِّح. افتح Distributed traces من خدمة الدخول (Services > More (…) > Distributed traces)، واحصر فترة الحادثة، ثم Filter requests > Response time بالمعامل ≥ وعتبتك (80 ms في مثال الوثائق). وإذا مرّ المرور عبر عدة سلاسل استدعاء فضع المرشح أولًا في service flow (Apply filter على الخدمة المستدعاة): فلا تعرض القائمة عندئذ سوى الطلبات التي تسلك هذه السلسلة.
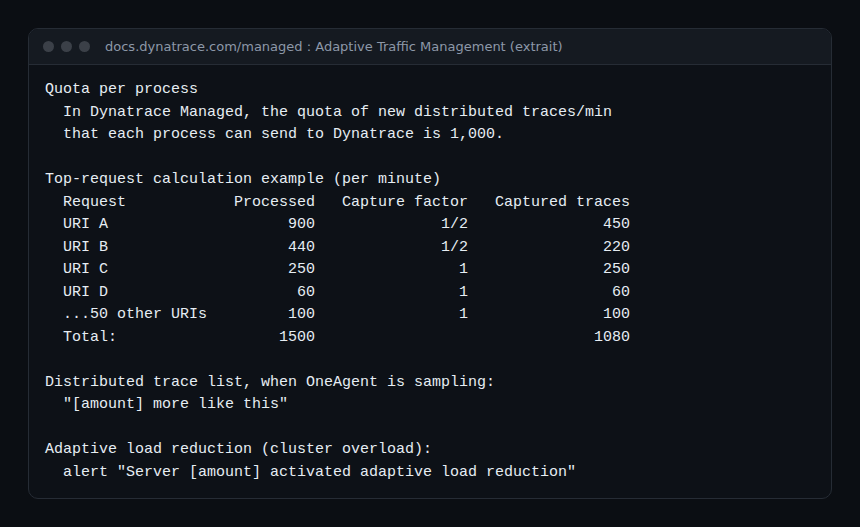
- رتّب حسب المدة. رتّب قائمة Most recent traces حسب Response time تنازليًا. وقارنه بـ Processing time: إذا تجاوز الأول الثاني بوضوح فالوقت يضيع في انتظار استدعاء بعيد لا في كود الخدمة. وإذا حمل السطر عبارة [n] more like this فإن OneAgent يأخذ عينات: التتبع المعروض يمثل طلبات مشابهة لم تُلتقط.
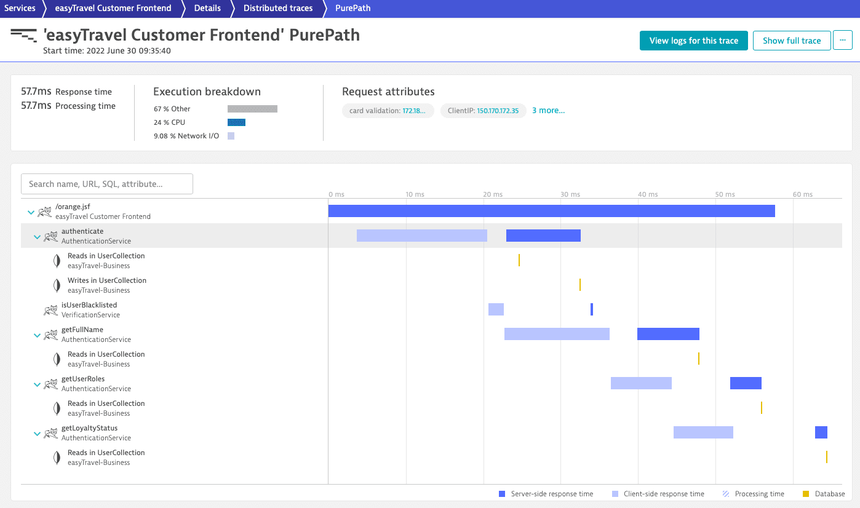
- افتح الـ PurePath. اختر اسم التتبع. يعطي الترويس Response time وProcessing time وExecution breakdown (حصة CPU وNetwork I/O و«Other») وrequest attributes الملتقطة. حصة عالية من Network I/O توجّه نحو الاستدعاءات الصادرة؛ وCPU عالية نحو كود الخدمة.
- اقرأ الشلال واستدعاءات قاعدة البيانات. في الـ waterfall، كل شريط استدعاء خدمة موضوع على محور الزمن الفعلي: الأشرطة الزرقاء الداكنة وقت الخادم، والفاتحة وقت العميل، والخطوط الصفراء استدعاءات قاعدة البيانات. ابحث عن أطول شريط ليس له ابن طويل: هناك يُستهلك الوقت. استدعاء قاعدة بيانات واحد يتكرر عشرات المرات متتاليًا يدل على N+1؛ وشريط عميل طويل بلا نظير على الخادم يدل على استدعاء خارجي أو خدمة بلا OneAgent.
- اصعد إلى الكود. اختر المقطع المسؤول، تبويب Code level: شجرة الدوال المنفَّذة فعلًا بمددها وبترتيب التنفيذ. وللحصول على نظرة إحصائية (CPU وwait وsync وlock والتنفيذ) مرّ بـ Timings > View method hotspots. وإذا كان مستوى الكود فارغًا فتحقق من عمر التتبع (10 أيام) ومن أن العملية مراقَبة فعلًا بـ OneAgent بنمط full-stack.
ولمعرفة مصدر هذه الطلبات البطيئة (أي تطبيق، وأي مستدعٍ، وأي إجراء مستخدم) انطلق من جديد من الخدمة المعنية بـ Analyze backtrace: يصعد service backtrace سلسلة الاستدعاءات في الاتجاه المعاكس، ولا يبقي خياره Filter service backtrace إلا على المعاملات التي تحوي السلسلة المحددة.
خمسة سيناريوهات عملية
بطء يشعر به المستخدمون
رشِّح خدمة الدخول على Response time ≥ هدفك، وافتح أبطأ تتبع، ثم Execution breakdown. إذا كان الوقت في الخدمة نفسها فمرّ بـ Timings > View method hotspots؛ وإذا كان في استدعاء لاحق فانزل في الـ waterfall.
ارتفاع معدل الأخطاء
من الخدمة، تبويب Failure rate، ثم Analyze backtrace لترى من أين تأتي الطلبات الفاشلة، ثم More (…) > Distributed traces. يعطيك تبويب Errors الاستثناء والمعاملات التي أفضت إليه: وغالبًا تتشارك التتبعات كلها السبب نفسه.
استدعاء خدمة طرف ثالث
يظهر الاستدعاء الخارجي شريطًا طويلًا لا يتوفر مستوى الكود فيه من جهة المستدعى. قارن زمن العميل بالزمن الكلي: إذا كان معظمه هناك فالمشكلة عند المزوّد، وتستحق مهلات الانتظار (timeouts) وإعادات المحاولة (retries) لديك مراجعة.
قاعدة البيانات
تظهر استدعاءات قاعدة البيانات في waterfall التتبع. ابحث عن استدعاء واحد يتكرر عشرات المرات في تتبع واحد: إنه نمط N+1 المعروف.
تراجع بعد النشر
قارن نافذتين بالمدة نفسها، قبل الإنتاج وبعده، على الخدمة نفسها وعتبة زمن الاستجابة نفسها. ثم يتيح request attribute يلتقط الإصدار (ترويسة أو معامل) ترشيح تتبعات الإصدار الجديد مباشرة. وتذكّر أن مستوى الكود غير المجمَّع يختفي بعد 10 أيام: حلّل بسرعة.
Request attributes: إثراء التتبعات عبر API
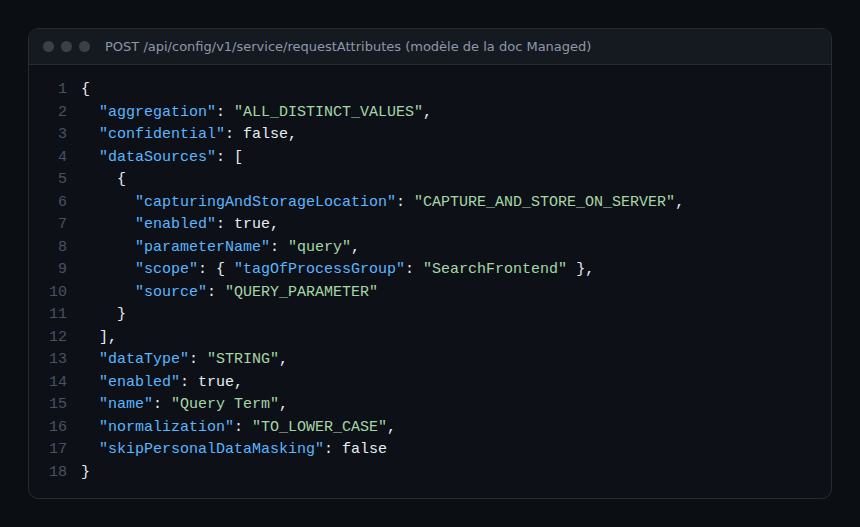
الـ request attributes أزواج مفتاح/قيمة ملحقة بطلب. تُستخدم للترشيح وتسمية الطلبات واكتشاف الأخطاء التجارية وإنشاء calculated metrics. أنشئها في Settings > Server-side service monitoring > Request attributes أو عبر Configuration API، مما يتيح إدارة إصداراتها. النموذج أدناه من وثائق Managed:
# list request attributes (scope ReadConfig)
curl -s -H "Authorization: Api-Token $DT_TOKEN" \
  "https://{your-domain}/e/{your-environment-id}/api/config/v1/service/requestAttributes"

# create a request attribute (scope CaptureRequestData)
curl -s -X POST -H "Authorization: Api-Token $DT_TOKEN" \
  -H "Content-Type: application/json" -d @request-attribute.json \
  "https://{your-domain}/e/{your-environment-id}/api/config/v1/service/requestAttributes"
لا تضع id في المتن: يُمنح تلقائيًا ويعيده الرد 201. يقبل الحقل source خصوصًا REQUEST_HEADER وQUERY_PARAMETER وMETHOD_PARAM وSPAN_ATTRIBUTE (مع spanAttributeKey) لتتبعات OpenTelemetry. فعّل confidential لكل بيانة شخصية.
الاحتفاظ والحدود الخاصة بـ Managed
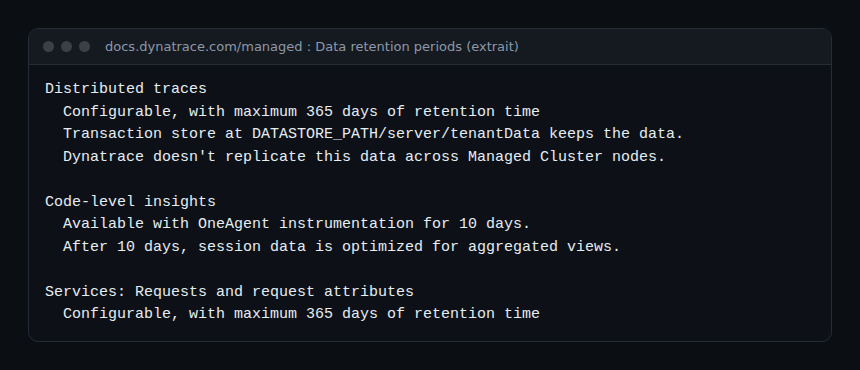
- التتبعات الموزعة (Distributed traces): احتفاظ قابل للضبط، 365 يومًا كحد أقصى. تُخزَّن في transaction store (
DATASTORE_PATH/server/tenantData)، ولا تُنسخ بين عقد العنقود: خسارة عقدة تعني خسارة تتبعاتها. التفاصيل في الاحتفاظ بالبيانات وتخزينها. - رؤى مستوى الكود (Code-level insights): 10 أيام بالتفصيل، ثم بيانات مجمَّعة.
- الطلبات وrequest attributes: قابل للضبط، 365 يومًا كحد أقصى.
- Request attributes: 100 لكل طلب، و10 قيم لكل سمة ولكل طلب، و1 000 سمة ملتقطة كحد أقصى لكل تتبع؛ وما زاد على ذلك لا يُلتقط شيء.
- تصدير CSV للقائمة: 50 تتبعًا عند «البيانات المعروضة»، وأحدث 3 000 عند «كل البيانات».
المزالق: أخذ العينات والتتبعات الناقصة وrequest attributes المفقودة
أخذ العينات (Adaptive Traffic Management)
لا يلتقط OneAgent كل الطلبات. ففي Managed يمكن لكل عملية أن تبدأ على الأكثر 1 000 تتبع موزّع جديد في الدقيقة افتراضيًا. وما زاد على ذلك يحتفظ Adaptive Traffic Management بمعظم الطلبات النادرة وبحصة مخفَّضة من الطلبات الكثيرة التكرار (عامل 1/2 في مثال الوثائق)؛ وتشير القائمة إلى الطلبات غير الملتقطة بعبارة [n] more like this. فالطلب البطيء النادر يُلتقط على الأرجح؛ أما الطلب البطيء وسط آلاف الاستدعاءات المتطابقة فقد يفوت. تُضبط الحصة في Settings > Server-side service monitoring > Deep monitoring > Adaptive capture control (عام أو لكل process group) ضمن الحد المضبوط في Cluster Management Console (حصة البيئة 1 000 افتراضيًا وحتى 100 000). وتتيح قواعد Trace sampling for HTTP requests (OneAgent 1.281+) وTrace sampling for RPC requests (OneAgent 1.307+) إعطاء أولوية لعناوين URL معينة أو تعطيل تتبع ضجيج معروف (فحوص الصحة والصور). وأخيرًا يطلق العنقود المشبع adaptive load reduction: فيتجاهل عشوائيًا تتبعات جديدة ويعرض التنبيه Server [n] activated adaptive load reduction؛ وبعد 15 دقيقة تتأثر دقة البيانات ويلزم إضافة عقدة أو تقليل المرور.
التتبعات الناقصة
ثلاثة أسباب تغطي كل الحالات تقريبًا. مستدعٍ غير مراقَب: يبدأ التتبع عند أول process group مراقَب بالكامل، ولا يعرض Show full trace إلا ما هو موجود. ترويسات محذوفة: وكيل أو WAF أو بوابة API تحذف x-dynatrace أو traceparent أو tracestate فتنتج تتبعين بدل واحد؛ وتطلب الوثائق أيضًا تمرير X-dynaTrace-RequestState الذي تستخدمه وحدات Apache وNGINX وIIS. بيئة مختلطة: من دون Send W3C Trace Context HTTP headers لا يتشارك OneAgent وOpenTelemetry الـ trace ID، ولا تظهر تتبعات OpenTelemetry إلا تحت Ingested traces مقطوعة عن أصلها. وإذا لم تصل spans الخاصة بـ OpenTelemetry إطلاقًا فاتبع قائمة التحقق لتتبعات OpenTelemetry الغائبة.
request attributes المفقودة
غياب request attribute عن تبويب Summary يعود في الغالب إلى سبب في الإعداد. القاعدة مقيَّدة بـ process group أو host group أو تقنية أو وسم ليس هو وسم الخدمة المرصودة. المصدر خاطئ: تُلتقط الترويسة بـ REQUEST_HEADER وparameterName، ومعامل URL بـ QUERY_PARAMETER، وسمة span في OpenTelemetry بـ SPAN_ATTRIBUTE وspanAttributeKey. جهة الالتقاط خاطئة: للترويسة يجب أن تكون capturingAndStorageLocation العميل أو الخادم، وليس أبدًا CAPTURE_AND_STORE_ON_BOTH. بلوغ الحدود: 100 سمة لكل طلب، و10 قيم لكل سمة، و1 000 سمة لكل تتبع، وما زاد لا يُلتقط. أو أن السمة موجودة لكن قيمها تظهر *****: فهي معلَّمة سرية وحسابك لا يملك حق رؤية البيانات المقنَّعة. وأخيرًا يلتقط OneAgent السمات لحظة الطلب: فالتتبعات السابقة للقاعدة لن تحملها أبدًا، فلا تبحث عن إصدار في تتبعات الأمس.
أفضل الممارسات
- رشِّح دائمًا حسب الخدمة وعتبة زمن الاستجابة قبل فتح تتبع.
- انسخ trace ID في تذكرة الحادثة: يبقى التتبع قابلًا للعثور عليه بالبحث.
- أنشئ request attributes (الإصدار والعميل والمستأجر) قبل الحادثة لا أثناءها.
- تحقق من أن الوكلاء (proxies) وموزعات الحمل تمرر
x-dynatraceوtraceparentوtracestate. - حلّل مستوى الكود خلال 10 أيام؛ وبعدها صدّر ما تحتاجه لتحليل ما بعد الحادثة (post-mortem).
كيف تتحقق من أن النتيجة صحيحة
افتح Distributed traces، ورشِّح على خدمة بنمط PurePaths: يجب أن تظهر تتبعات فيها عدة خدمات في الـ waterfall. وإذا توقف تتبع فجأة عند وكيل فتحقق من نشر الترويسات. بعد إنشاء request attribute يجب أن يسرده GET في الـ API، وأن تظهر السمة في تبويب Summary للتتبعات الجديدة. وللتوسع في الاستكشاف انظر أيضًا وحدة استكشاف بيانات Managed وMultidimensional analysis.
الأسئلة الشائعة
ماذا تعني [declared unavailable by agent] في تتبع؟
هي قيمة بديلة: لم يستطع OneAgent التقاط البيانة الوصفية، لنقص في الرؤية أو لأن التقنية غير مدعومة.
لماذا يبدأ تتبعي من منتصف السلسلة؟
يبدأ التتبع دائمًا عند أول process group مراقَب بالكامل. مستدعٍ بلا OneAgent أو ترويسات حُذفت في الطريق تقطع الجزء السابق. يعرض Show full trace التتبع الكامل عندما يكون موجودًا.
هل تظهر تتبعات OpenTelemetry في Managed؟
نعم، في العرض نفسه بمرشح Ingested traces. وفي البيئة المختلطة فعّل W3C Trace Context وتجنب تكرار الـ spans (انظر OneAgent وOpenTelemetry دون تكرار).
الخلاصة
تحوّل Distributed traces Dynatrace Managed عبارة «الخدمة بطيئة» إلى «هذه الدالة، في هذه الخدمة، لهذه الطلبات». رشِّح أولًا، ثم اقرأ الـ waterfall، ثم انزل إلى الكود والسجلات أخيرًا، وراعِ حد 10 أيام لمستوى الكود وكون transaction store غير منسوخ. المرجع الرسمي: Get started with Distributed Traces (Managed) وData retention periods وAdaptive Traffic Management.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace وPurePath علامتان تجاريتان لمالكهما. الأمثلة للاستئناس فقط: تحقق منها في الوثائق الرسمية الخاصة بإصدارك.