أمانة RAG (faithfulness) هي أول مقياس يُعتمد عند تقييم نظام RAG: فهي تتحقق من أن إجابة النموذج تستند إلى المقاطع المسترجعة لا إلى خياله. إنها كاشف ممتاز للهلوسة، لكنها ليست مقياسًا للحقيقة.
درجة الأمانة المرتفعة تُطمئن بسرعة، وأحيانًا دون وجه حق. فقد تكون الإجابة أمينة تمامًا لوثيقة قديمة أو لمقطع خارج الموضوع. وبالنسبة لفريق SRE يربط مساعدًا بأدلة التشغيل (runbooks) الخاصة به، فالفرق مهم: إجراء أمين لكنه قديم يبقى خطرًا أثناء الحادثة.
يشرح هذا المقال ما الذي تقيسه الأمانة، وكيف تُحسب باستخدام Ragas وLlamaIndex، وأين تتوقف خصوصًا. وهو يكمل الدرس التطبيقي عن LlamaIndex RAG على الوثائق الداخلية الذي يبني خط المعالجة؛ أما هنا فالتركيز على قراءة الدرجات.
أمانة RAG: ما الذي يقيسه المقياس
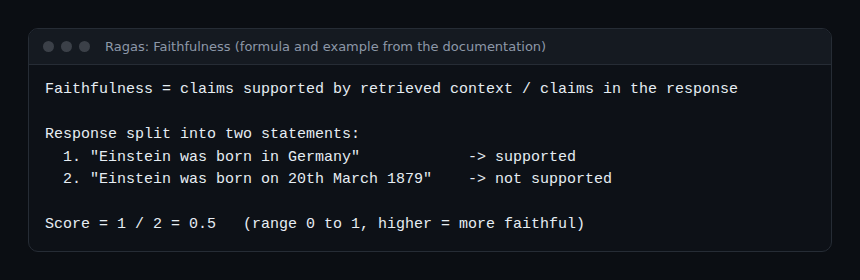
بحسب وثائق Ragas، تقيس الأمانة (faithfulness) الاتساق الواقعي للإجابة مع السياق المسترجع. تتراوح بين 0 و1؛ وكلما ارتفعت الدرجة زاد الاتساق. تكون الإجابة أمينة عندما يمكن دعم جميع ادعاءاتها بالسياق.
يتم الحساب في ثلاث خطوات، بحسب الصفحة نفسها:
- تحديد الادعاءات الواردة في الإجابة؛
- التحقق، لكل ادعاء، مما إذا كان السياق المسترجع يسمح باستنتاجه؛
- قسمة عدد الادعاءات المدعومة على العدد الإجمالي للادعاءات.
يقسّم مثال الوثائق إجابة إلى ادعاءين. أحدهما مدعوم والآخر غير مدعوم: الدرجة 1 من 2، أي 0.5.
تصف وثائق LlamaIndex الفكرة نفسها باختصار أكبر: تتحقق الأمانة من أن الإجابة مدعومة بالسياقات المسترجعة، مما يتيح كشف الهلوسة.
تقييم نظام RAG: الفصل بين الاسترجاع والتوليد
لنظام RAG مرحلتان، ودرجة واحدة لا تبيّن أيهما معطلة. تميّز الورقة البحثية التي تقدّم Ragas ثلاثة أبعاد: جودة الاسترجاع، واستخدام النموذج للسياق بأمانة، وجودة التوليد. ويتحدث المؤلفون عن تقييم بلا مرجع، أي بلا تعليق بشري مسبق.
يعتمد LlamaIndex الفصل نفسه. يرتّب تقييم الاسترجاع النتائج بمقاييس الترتيب مثل MRR وhit rate والدقة. ويضم تقييم الإجابة، من بين ما يضم، Correctness وSemantic Similarity وFaithfulness وContext Relevancy وAnswer Relevancy وGuideline Adherence. يتطلب كل من Correctness وSemantic Similarity تسميات، أي إجابة مرجعية.
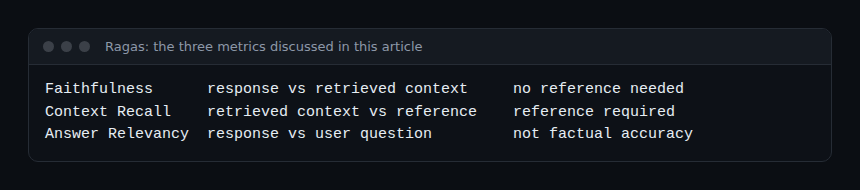
ثلاثة مقاييس تصلح شبكة قراءة جيدة:
- Faithfulness تقارن الإجابة بالسياق المسترجع. لا حاجة إلى إجابة مرجعية.
- Context Recall تتطلب، بحسب Ragas، مرجعًا «دائمًا»: تقيس ما إذا كان السياق المسترجع يغطي ما تحتويه الإجابة الصحيحة.
- Answer Relevancy تقيس ملاءمة الإجابة للسؤال دون تقييم الدقة الواقعية، كما توضح الوثائق.
عمليًا: حساب الأمانة
مع LlamaIndex
يتلقى FaithfulnessEvaluator نموذج LLM قاضيًا ويقيّم إجابة استعلام. تعرض النتيجة ثلاثة حقول: passing (نجاح أو فشل) وscore وfeedback. توضح الوثائق أنه بحسب المقيِّم قد تُملأ بعض الحقول فقط.
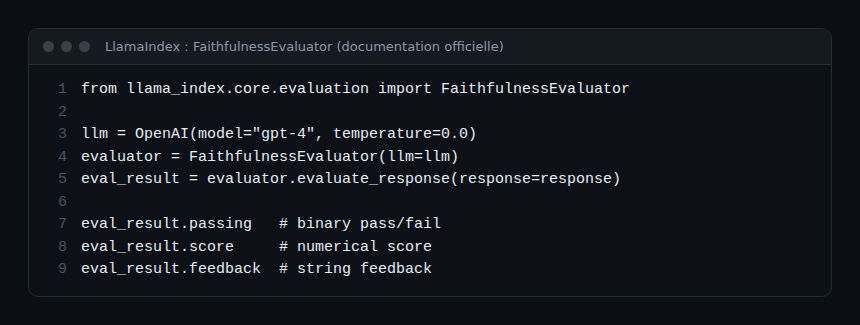
وهناك نمط استخدام ثانٍ موثّق: استدعاء evaluate مع الإجابة وقائمة من السياقات، عقدة مصدر واحدة في كل مرة. نحصل عندئذ على نتيجة لكل مصدر، مما يساعد على معرفة المقطع الذي لا يدعم الإجابة.
مع Ragas
في واجهة Ragas الحالية، يُنشأ الكائن Faithfulness من ragas.metrics.collections مع نموذج LLM، ثم يُستدعى ascore (أو score في الشيفرة المتزامنة) مع سؤال المستخدم والإجابة. أما الواجهة القديمة القائمة على SingleTurnSample فتُوصف بأنها متقادمة في الإصدار 0.4 وتُزال في 1.0. ينبغي قراءة المعاملات الدقيقة، ومنها تمرير السياقات، في صفحة Faithfulness في Ragas الخاصة بإصدارك.
يقدّم Ragas أيضًا نسخة بديلة هي FaithfulnesswithHHEM، تُسند التحقق من الادعاءات إلى مصنِّف مفتوح المصدر من Vectara. وهي تستبدل خطوة التحقق فقط، لا استخراج الادعاءات.
كيف تتحقق من أن الأمر يعمل
- خذ من 20 إلى 30 سؤالًا حقيقيًا من تذاكر المناوبة لديك.
- احسب أمانة كل إجابة واقرأ يدويًا الإجابات الخمس الأدنى درجة.
- لكل درجة منخفضة، تحقق مما إذا كان الادعاء غير المدعوم اختلاقًا حقيقيًا أم مقطعًا فاته الاسترجاع.
- أعد قراءة خمس إجابات ذات درجة قصوى أيضًا: يجب أن تكون دقيقة، لا أمينة فقط.
حدود الأمانة
تنبع هذه الحدود من تعريف المقياس نفسه؛ وليست عيوبًا في أداة بعينها.
- الأمين ليس دقيقًا. تقارن الأمانة الإجابة بالسياق المسترجع، لا بالواقع أبدًا. إذا كان دليل التشغيل المفهرس خاطئًا أو قديمًا، فإن إجابة تنسخه تنال درجة جيدة.
- تتجاهل ما لم يُسترجع. إذا لم يظهر المقطع الصحيح، فقد يبقى النموذج الذي يجيب «لا أعرف» أو يكرر مقطعًا مجاورًا أمينًا. الاسترجاع وحده (Context Recall وhit rate) يكشف ذلك، وContext Recall تتطلب مرجعًا.
- لا تقول شيئًا عن الملاءمة. قد تتهرب إجابة أمينة من السؤال. توجد Answer Relevancy لهذه الحالة، لكنها أيضًا، بحسب Ragas، لا تحكم على الدقة.
- القاضي نموذج. تعتمد مقيِّمات الإجابة في LlamaIndex على LLM يحكم؛ وتذكر الوثائق نموذج LLM «ذهبيًا» مثل GPT-4. النموذج المحلي الصغير يعطي أحكامًا أكثر ضجيجًا. هذه النقطة مستنتجة من مبدأ العمل: ولا يُعطى لها رقم هنا.
- تقسيم الادعاءات يؤثر في الدرجة. الدرجة نسبة بين ادعاءات: عدد الادعاءات التي يستخرجها القاضي ودقتها يغيّران القيمة.
قراءة حذرة: تعامل مع الأمانة بوصفها مؤشر انحراف. التراجع بين إصدارين من خط المعالجة يستحق التحقيق؛ أما القيمة المطلقة فلا تثبت شيئًا.
ربط التقييم بقابلية الرصد
التقييم دون اتصال لا يحل محل الإنتاج. فتسجيل السياقات المسترجعة ودرجات التشابه وزمن كل مرحلة في صورة تتبعات OpenTelemetry يتيح إعادة تشغيل حالة مشبوهة. يُوصف الإعداد في مقال Langfuse وOpenLLMetry، وتُوصف الضوابط الأوسع في ضوابط وكلاء الذكاء الاصطناعي في الإنتاج. لا شيء في هذا المقال يفترض تكاملًا أصليًا مع Dynatrace: تتبعات OpenTelemetry هي نقطة الالتقاء.
أفضل الممارسات
- قيّم الاسترجاع والتوليد كلًا على حدة، ثم معًا.
- احتفظ بمجموعة أسئلة مُصدَّرة بإصدارات وأثرِها بإخفاقات الإنتاج.
- اقرن الأمانة بمقياس واحد على الأقل ينظر إلى الحقيقة المرجعية (مرجع بشري).
- أرّخ الوثائق المفهرسة وأصدِرها بإصدارات: المصدر القديم غير مرئي للأمانة.
- قارن بين إعدادين بالقاضي نفسه؛ ولا تغيّر القاضي في منتصف الطريق.
- أعد قراءة عيّنة يدويًا عند كل تغيير في النموذج أو في التقسيم.
الأسئلة الشائعة
ما درجة الأمانة التي ينبغي استهدافها؟
لا تعطي الوثائق التي قُرئت أي عتبة شاملة. حدّدها انطلاقًا من مجموعة أسئلتك الخاصة، بمراجعة الإجابات الواقعة على جانبيها يدويًا.
هل تكشف الأمانة كل الهلوسات؟
لا. إنها تكشف الادعاءات التي لا يدعمها السياق المسترجع. أما خطأ موجود في السياق نفسه، أو إجابة تتجاهل السؤال، فيفلت منها.
Ragas أم LlamaIndex لقياس الأمانة؟
كلاهما يوفر مقياس أمانة قائمًا على LLM قاضٍ. LlamaIndex عملي إذا كان خط المعالجة يستخدمه أصلًا؛ وRagas إطار تقييم مخصص. يعتمد الاختيار خصوصًا على أدواتك الحالية.
الخلاصة
تجيب أمانة RAG عن سؤال واحد: هل تقع الإجابة ضمن السياق المسترجع؟ إنها مفيدة وقليلة الكلفة في الإعداد، لكنها غير كافية وحدها. ولتقييم نظام RAG بجدية، يجب تقاطعها مع جودة الاسترجاع والملاءمة ومراجعة بشرية منتظمة.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا للمشاريع المذكورة (Ragas وLlamaIndex). Dynatrace علامة تجارية لشركة Dynatrace LLC. العلامات تعود إلى مالكيها. الأدوات تتطور بسرعة: تحقق من أسماء الأصناف والمعاملات في الوثائق الرسمية الخاصة بإصدارك.