La fidelidad RAG es la primera métrica que se pone en marcha cuando se quiere evaluar un RAG: comprueba que la respuesta del modelo se apoya en los pasajes recuperados y no en su imaginación. Es un excelente detector de alucinaciones. Pero no es una medida de verdad.
Una puntuación de fidelidad alta tranquiliza rápido, a veces sin motivo. Una respuesta puede ser perfectamente fiel a un documento obsoleto o a un pasaje fuera de tema. Para un equipo SRE que conecta un asistente a sus runbooks, la diferencia importa: un procedimiento fiel pero antiguo sigue siendo peligroso durante un incidente.
Este artículo explica qué mide la fidelidad, cómo calcularla con Ragas y LlamaIndex y, sobre todo, dónde se detiene. Complementa nuestro tutorial de LlamaIndex RAG sobre la documentación interna, que monta el pipeline; aquí el foco está en la lectura de las puntuaciones.
Fidelidad RAG: qué mide la métrica
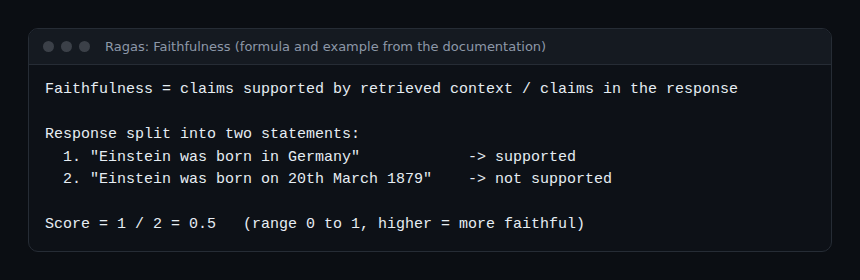
Según la documentación de Ragas, la fidelidad (faithfulness) mide la coherencia factual de una respuesta con el contexto recuperado. Va de 0 a 1; cuanto más alta es la puntuación, mayor es la coherencia. Una respuesta es fiel cuando todas sus afirmaciones pueden apoyarse en el contexto.
El cálculo sigue tres pasos, según la misma página:
- identificar las afirmaciones contenidas en la respuesta;
- comprobar, para cada una, si el contexto recuperado permite inferirla;
- dividir el número de afirmaciones respaldadas por el número total de afirmaciones.
El ejemplo de la documentación divide una respuesta en dos afirmaciones. Una está respaldada y la otra no: la puntuación es 1 sobre 2, es decir, 0,5.
La documentación de LlamaIndex describe la misma idea de forma más breve: la fidelidad comprueba que una respuesta está respaldada por los contextos recuperados, lo que permite detectar la alucinación.
Evaluar un RAG: separar recuperación y generación
Un RAG tiene dos etapas, y una sola puntuación no dice cuál falla. El artículo de investigación que presenta Ragas distingue tres dimensiones: la calidad de la recuperación, el uso fiel del contexto por parte del modelo y la calidad de la generación. Los autores hablan de una evaluación sin referencia, es decir, sin anotación humana previa.
LlamaIndex adopta la misma separación. La evaluación de la recuperación ordena los resultados con métricas de rango como MRR, hit rate y precisión. La evaluación de la respuesta agrupa, entre otras, Correctness, Semantic Similarity, Faithfulness, Context Relevancy, Answer Relevancy y Guideline Adherence. Correctness y Semantic Similarity exigen etiquetas, es decir, una respuesta de referencia.
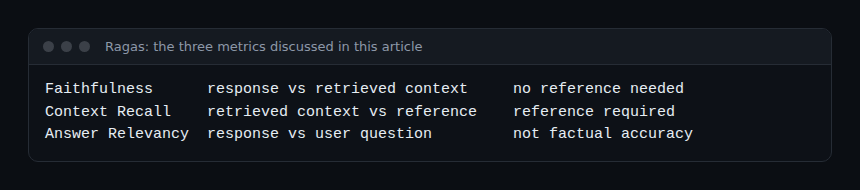
Tres métricas sirven bien como guía de lectura:
- Faithfulness compara la respuesta con el contexto recuperado. No necesita respuesta de referencia.
- Context Recall pide, según Ragas, «siempre» una referencia: mide si el contexto recuperado cubre lo que contiene la buena respuesta.
- Answer Relevancy mide la adecuación de la respuesta a la pregunta, sin evaluar la exactitud factual, precisa la documentación.
En la práctica: calcular la fidelidad
Con LlamaIndex
FaithfulnessEvaluator recibe un LLM juez y evalúa la respuesta a una consulta. El resultado expone tres campos: passing (éxito o fallo), score y feedback. La documentación precisa que, según el evaluador, solo algunos campos pueden venir rellenados.
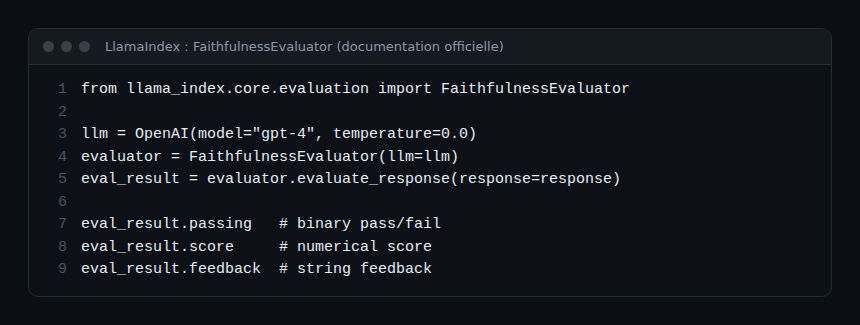
Se documenta un segundo esquema de uso: llamar a evaluate con la respuesta y una lista de contextos, un nodo fuente cada vez. Se obtiene entonces un resultado por fuente, lo que ayuda a ver qué pasaje no respalda la respuesta.
Con Ragas
En la API actual de Ragas se instancia Faithfulness desde ragas.metrics.collections con un LLM y se llama a ascore (o score en código síncrono) con la pregunta del usuario y la respuesta. La antigua API basada en SingleTurnSample se señala como obsoleta en la versión 0.4 y retirada en la 1.0. Los parámetros exactos, incluido el paso de los contextos, deben leerse en la página Faithfulness de Ragas para tu versión.
Ragas ofrece también una variante, FaithfulnesswithHHEM, que confía la verificación de las afirmaciones a un clasificador de código abierto de Vectara. Solo sustituye el paso de verificación, no la extracción de las afirmaciones.
Cómo comprobar que funciona
- Toma de 20 a 30 preguntas reales de tus tickets de guardia.
- Calcula la fidelidad de cada respuesta y lee a mano las cinco más bajas.
- Para cada puntuación baja, comprueba si la afirmación no respaldada es una invención real o un pasaje que la recuperación no encontró.
- Relee también cinco respuestas con puntuación máxima: deben ser exactas, no solo fieles.
Los límites de la fidelidad
Estos límites se derivan de la propia definición de la métrica; no son defectos de una herramienta concreta.
- Fiel no es exacto. La fidelidad compara la respuesta con el contexto recuperado, nunca con la realidad. Si el runbook indexado es falso u obsoleto, una respuesta que lo copia obtiene una buena puntuación.
- Ignora lo que no se recuperó. Si el pasaje correcto no aparece, un modelo que responde «no lo sé» o repite un pasaje vecino puede seguir siendo fiel. Solo la recuperación (Context Recall, hit rate) lo revela, y Context Recall exige una referencia.
- No dice nada de la pertinencia. Una respuesta fiel puede esquivar la pregunta. Answer Relevancy existe para ese caso pero, según Ragas, tampoco juzga la exactitud.
- El juez es un modelo. Los evaluadores de respuesta de LlamaIndex se basan en un LLM que juzga; la documentación cita un LLM «gold» como GPT-4. Un modelo local pequeño da veredictos con más ruido. Este punto se deduce del principio de funcionamiento: no se cuantifica aquí.
- La división en afirmaciones influye en la puntuación. La puntuación es una razón de afirmaciones: el número y la finura de las afirmaciones extraídas por el juez hacen variar el valor.
Una lectura prudente: tratar la fidelidad como un indicador de deriva. Un descenso entre dos versiones del pipeline merece una investigación; un valor absoluto no prueba nada.
Conectar la evaluación con la observabilidad
La evaluación offline no sustituye a la producción. Registrar los contextos recuperados, las puntuaciones de similitud y la latencia de cada etapa como trazas de OpenTelemetry permite reproducir un caso dudoso. La puesta en marcha se describe en el artículo Langfuse y OpenLLMetry, y las salvaguardas más amplias en salvaguardas de los agentes de IA en producción. Nada en este artículo supone una integración nativa con Dynatrace: las trazas de OpenTelemetry son el punto de encuentro.
Buenas prácticas
- Evalúa la recuperación y la generación por separado y luego juntas.
- Mantén un conjunto de preguntas versionado y enriquécelo con los fallos de producción.
- Combina la fidelidad con al menos una métrica que mire la verdad de referencia (referencia humana).
- Fecha y versiona los documentos indexados: una fuente obsoleta es invisible para la fidelidad.
- Compara dos configuraciones con el mismo juez; no cambies de juez a mitad de camino.
- Relee una muestra a mano en cada cambio de modelo o de división del texto.
Preguntas frecuentes
¿Qué puntuación de fidelidad conviene buscar?
Las documentaciones leídas no dan ningún umbral universal. Fíjalo a partir de tu propio conjunto de preguntas, revisando a mano las respuestas situadas a ambos lados.
¿La fidelidad detecta todas las alucinaciones?
No. Detecta las afirmaciones que el contexto recuperado no respalda. Un error presente en el propio contexto, o una respuesta que ignora la pregunta, se le escapa.
¿Ragas o LlamaIndex para medir la fidelidad?
Ambos ofrecen una métrica de fidelidad basada en un LLM juez. LlamaIndex es práctico si el pipeline ya lo usa; Ragas es un marco de evaluación dedicado. La elección depende sobre todo de tus herramientas actuales.
Conclusión
La fidelidad RAG responde a una sola pregunta: ¿cabe la respuesta en el contexto recuperado? Es útil y barata de implantar, pero insuficiente por sí sola. Para evaluar un RAG en serio hay que cruzarla con la calidad de la recuperación, la pertinencia y una verificación humana regular.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados (Ragas, LlamaIndex). Dynatrace es una marca de Dynatrace LLC. Las marcas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los nombres de clases y parámetros en la documentación oficial de tu versión.