


Browsing Tag
GPU
13 posts

نموذج MoE محلي: ما الذي يطلبه Colibri من قرصك
نموذج MoE محلي مع Colibri: الذاكرة العشوائية وقرص NVMe والسرعات المنشورة والمراقبة عبر /metrics. ما يقوله README قبل تنزيل 400 غيغابايت.

خادم vLLM لاستدلال LLM: التثبيت والمراقبة
خادم vLLM لاستدلال LLM مفتوح المصدر: التثبيت بحسب الوثائق، والمعمارية، ومقاييس الخدمة (الطابور وذاكرة KV وTTFT) وتتبعات OpenTelemetry.
الموشن غرافيك مفتوح المصدر مع EffectCraft: جولة وحدود
الموشن غرافيك مفتوح المصدر مع EffectCraft بلغة Rust: الترخيص واللقطات وخطوات التثبيت من README وحدود النسخة ألفا وما يمكن قياسه على الجهاز.
برنامج الرسم المتجهي VectorCraft مفتوح المصدر: جولة وحدود
برنامج الرسم المتجهي VectorCraft مفتوح المصدر بلغة Rust: الترخيص واللقطات وخطوات التثبيت من README وحدود النسخة ألفا وما يمكن قياسه على الجهاز.
التعديل غير المدمّر للصور مع LightCraft: الأساسيات
التعديل غير المدمّر للصور مع LightCraft بلغة Rust: الترخيص واللقطات وخطوات التثبيت من README وحدود النسخة ألفا وما يمكن قياسه على الجهاز.
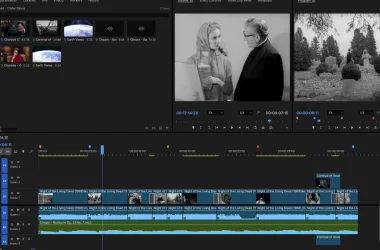
محرر الفيديو FilmCraft مفتوح المصدر: جولة وتثبيت وحدود
محرر الفيديو FilmCraft مفتوح المصدر بلغة Rust: الترخيص واللقطات وخطوات التثبيت من README وحدود النسخة ألفا وما يمكن قياسه على الجهاز.
مقارنة نماذج LLM مفتوحة المصدر: الترخيص والحجم وVRAM ومعدل المعالجة المقيس على vLLM وOllama
مقارنة نماذج LLM مفتوحة المصدر: الترخيص والمعاملات وذاكرة GPU ووسوم Ollama لثمانية نماذج موثقة، ومنهج قياس معدل المعالجة على vLLM.
Mistral Large 4 بالاستضافة الذاتية: ما نُشر فعلًا وتحديد الحجم والمراقبة
Mistral Large 4 بالاستضافة الذاتية: الأوزان لم تُنشر بعد، والذاكرة اللازمة لنموذج من 1000 مليار معامل، ومراقبة vLLM على عدة وحدات GPU.
مكدس الذكاء الاصطناعي المستضاف ذاتيًا: مقارنة بين مكونات البنية التحتية مفتوحة المصدر
مكدس الذكاء الاصطناعي المستضاف ذاتيًا: مقارنة Ollama وvLLM وOpen WebUI وLlamaIndex وCrewAI وDify وn8n وLangfuse وتركيبات نموذجية جاهزة.
llama.cpp: استدلال محلي على CPU وGPU ونماذج GGUF وخادم HTTP مدمج
ابنِ llama.cpp وشغّل نموذج GGUF على CPU أو GPU عبر llama-server المتوافق مع OpenAI، ثم راقبه: الصحة ومقاييس Prometheus والسجلات.