خادم vLLM لاستدلال (inference) النماذج اللغوية: مستودع vllm-project/vllm مكتبة Python وخادم لتشغيل النماذج اللغوية على معالجات GPU الخاصة بك، مع واجهة API متوافقة مع OpenAI. وكان يعرض نحو 95 100 نجمة في أكتوبر 2026، بترخيص Apache-2.0. ويلخّصه README بعبارة «Easy, fast, and cheap LLM serving for everyone».
بالنسبة إلى فريق التشغيل، السؤال ليس تشغيله فقط، بل معرفة ما يحدث حين يصل عشرة مستخدمين في وقت واحد: كم طلبًا ينتظر، وبأي سرعة يخرج أول رمز (token)، وأين تمتلئ ذاكرة التخزين المؤقت. يعرض هذا المقال المشروع والتثبيت بحسب الوثائق، وخصوصًا الإشارات الواجب مراقبتها. وللنشر الأساسي ولوحة معلومات أولى راجع مقالنا عن vLLM في الإنتاج: زاويتنا هنا هي الأداء الداخلي وقراءة مقاييس الخدمة.
المعلومات مأخوذة من README والوثائق الرسمية للمشروع. لم تثبّت span.observer برنامج vLLM: المخططات أدناه مأخوذة من وثائق المشروع.
خادم vLLM لاستدلال LLM: ما يقوله المستودع
- الأصل: بحسب README طُوّر vLLM أصلًا في مختبر Sky Computing Lab بجامعة كاليفورنيا في بيركلي، ويصونه اليوم مجتمع من «عشرات المؤسسات الأكاديمية والشركات»، بأكثر من 2 000 مساهم.
- الترخيص: Apache-2.0 (ملف LICENSE في المستودع).
- الإصدار: 0.32.0 على PyPI، نُشر في 18 أكتوبر 2026.
- التقنيات المبرزة: إدارة ذاكرة المفتاح والقيمة بواسطة PagedAttention، ومعالجة الطلبات المستمرة (continuous batching)، والتعبئة المسبقة (prefill) على قطع، وذاكرة تخزين مؤقت للبادئات، وكمّنات عديدة (FP8 وINT8 وINT4 وGPTQ وAWQ وGGUF…)، والفك التخميني (speculative decoding)، والتوازي الموتري وخط الأنابيب والبيانات والخبراء والسياق.
- الواجهات: خادم متوافق مع OpenAI، مع واجهة Anthropic Messages وgRPC إضافةً إلى ذلك بحسب README.
- العتاد: معالجات GPU من NVIDIA وAMD وIntel، ومعالجات x86 وARM وPowerPC، إضافة إلى إضافات عتادية (TPU وGaudi وAscend وApple Silicon…).
يعلن README «معدل معالجة خدمة في الطليعة»: هذا ادعاء من المشروع لا نضع له رقمًا. قِس على عتادك ونماذجك.
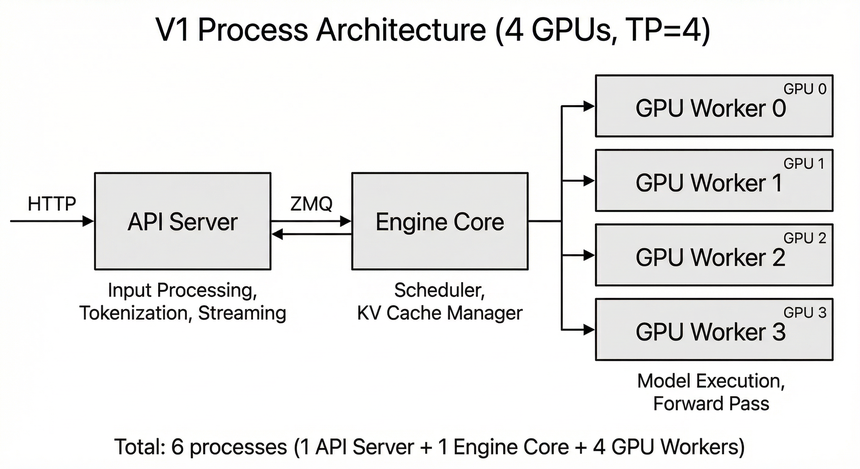
تصف وثائق المعمارية الإصدار V1 هكذا: خادم API (معالجة المدخلات والترميز إلى رموز وتدفق المخرجات)، ونواة محرك (المجدول ومدير ذاكرة KV) موصولة عبر ZMQ، وعملية عمل لكل GPU. وهذا مفيد للمراقبة: الطابور الذي يطول مصدره المجدول لا النموذج.
تثبيت خادم vLLM بحسب الوثائق
الخطوة 1 — المتطلبات
يذكر دليل البدء: نظام Linux وPython من 3.11 إلى 3.14. وعلى Mac بشريحة Apple يحيل الدليل نفسه إلى مشروع منفصل هو vLLM-Metal. ولا تصف الصفحات التي اطّلعنا عليها تثبيتًا أصليًا على Windows.
الخطوة 2 — التثبيت
uv venv --python 3.12 --seed
source .venv/bin/activate
uv pip install vllm --torch-backend=auto
vllm download-kernels
يعطي README الصيغة المختصرة uv pip install vllm تليها vllm download-kernels: يثبّت هذا الأمر نوى مترجمة مسبقًا تُنزَّل وتُترجَم وإلا عند البدء، وقد يضيف ذلك عدة دقائق على معالجات GPU من طراز Hopper وما بعدها. وللإصدارات الخاصة بـ AMD ROCm وIntel وTPU وAscend تعليماتها الخاصة في الوثائق.
الخطوة 3 — تشغيل الخادم
vllm serve Qwen/Qwen2.5-1.5B-Instructيستمع الخادم افتراضيًا على http://localhost:8000 (الخياران --host و--port) ويستضيف نموذجًا واحدًا في كل مرة، بحسب الدليل.
مراقبة vLLM: مقاييس الخدمة
يتيح الخادم مقاييس بصيغة Prometheus على النقطة /metrics. وتعرض الوثائق الاستعلام:
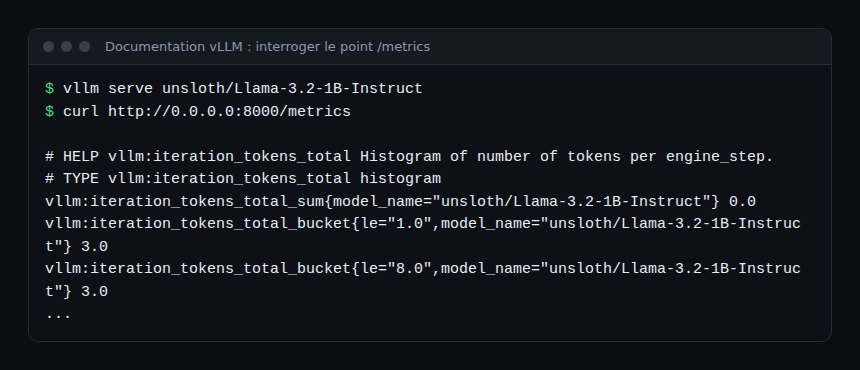
الأسماء أدناه واردة في صفحة «Production Metrics» من الوثائق قيد التطوير؛ تحقق منها بحسب الإصدار الذي تنشره، لأن المشروع يطبّق سياسة إهمال (مقياس مُهمَل في X.Y يُخفى في X.Y+1 ويُحذف في X.Y+2).
- الطابور والحمل:
vllm:num_requests_runningوvllm:num_requests_waiting. - الذاكرة:
vllm:kv_cache_usage_perc(إشغال ذاكرة المفتاح والقيمة) وvllm:num_preemptions. - زمن الاستجابة:
vllm:time_to_first_token_secondsوvllm:inter_token_latency_secondsوvllm:e2e_request_latency_seconds، إضافة إلى أزمنة الطابور والتعبئة المسبقة والفك لكل طلب. - الحجم:
vllm:prompt_tokensوvllm:generation_tokensوvllm:request_success.
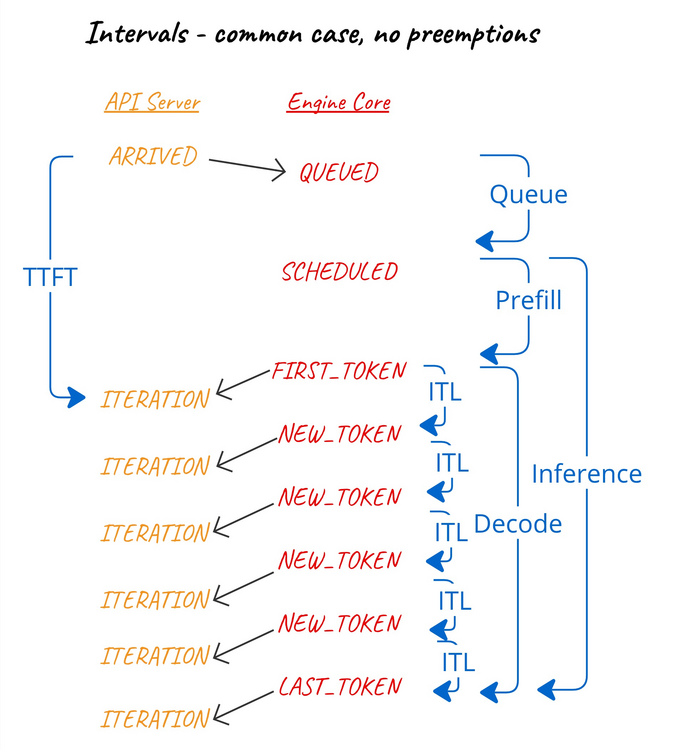
يساعد مخطط التصميم في المشروع على قراءة هذه المدرّجات: يغطي TTFT (الزمن حتى أول رمز) الانتظار في الطابور ثم التعبئة المسبقة؛ ويقيس ITL (الفاصل بين الرموز) إيقاع الفك. فارتفاع TTFT مع طابور يكبر يدل على تشبع؛ وارتفاع ITL مع ذاكرة KV ممتلئة يدل على ضغط في الذاكرة.
ضبط حاويات (buckets) هدف SLO
توضح الوثائق أن أصغر عتبة افتراضية في مدرّجات مراحل الطلب هي 0.3 ثانية. ولتتبع هدف زمن استجابة أدنى، يستبدل الخيار --custom-histogram-buckets عتبات عائلة ما:
vllm serve Qwen/Qwen3-0.6B \
    --custom-histogram-buckets '{"request_latency": [0.01, 0.05, 0.1, 0.25, 0.5, 1.0, 5.0, 30.0]}'
تضيف كل عتبة سلسلة زمنية لكل مقياس ولكل توليفة وسوم: أبقِ القوائم قصيرة. وتشير الوثائق أيضًا إلى الخيار --enable-mfu-metrics لمقاييس استخدام عمليات الفاصلة العائمة في النموذج.
تتبعات OpenTelemetry
لا تخلط بين المقاييس والتتبعات. يدعم vLLM تتبع OpenTelemetry عبر --otlp-traces-endpoint و--collect-detailed-traces. ويستخدم مثال الوثائق Jaeger والمتغيرين OTEL_SERVICE_NAME وOTEL_EXPORTER_OTLP_TRACES_ENDPOINT؛ والبروتوكول الافتراضي gRPC، ويحوّل OTEL_EXPORTER_OTLP_TRACES_PROTOCOL=http/protobuf إلى HTTP. ويتيح Collector موضوع أمامه التوجيه بعدها إلى أداتك؛ راجع Collector في OpenTelemetry نحو Dynatrace.
كيف تتحقق من أن كل شيء يعمل؟
- يعيد
curl http://localhost:8000/metricsأسطرًا بصيغةvllm:…. - أرسل بعض الطلبات إلى الـ API، ثم لاحظ ارتفاع
vllm:request_successوعدّادات الرموز. - مع تفعيل التتبع ينتج كل طلب تتبعًا ظاهرًا في خلفيتك تحت اسم الخدمة المختار.
الحدود والنقاط المفتوحة
- العتاد: يستهدف المشروع معالجات GPU أساسًا؛ ولمحطة بلا GPU تكون أدوات مثل llama.cpp أو Ollama أبسط.
- إحصاءات الاستخدام: تذكر الوثائق أن vLLM يجمع افتراضيًا بيانات استخدام مجهولة (العتاد ومعمارية النموذج والإعداد). والتعطيل بـ
VLLM_NO_USAGE_STATS=1أوDO_NOT_TRACK=1، أو بملف~/.config/vllm/do_not_track. قرّر ذلك قبل الإنتاج. - نموذج واحد لكل خادم؛ وقد تتغير أسماء المقاييس من إصدار إلى آخر (سياسة الإهمال في المشروع).
- الكاردينالية (cardinality): الحاويات وتوازي البيانات يضاعفان سلاسل Prometheus.
أفضل الممارسات
- ثبّت إصدار vLLM وأعد قراءة ملاحظات الإصدار قبل كل تحديث.
- نبّه على طابور الانتظار وTTFT لا على معدل المعالجة وحده.
- راقب إشغال ذاكرة KV وعمليات الاستباق قبل إضافة معالجات GPU.
- أبقِ قوائم الحاويات قصيرة ومتوافقة مع أهداف SLO لديك.
- لا تعرّض المنفذ 8000 على الإنترنت من دون مصادقة أو بروكسي.
الأسئلة الشائعة
هل vLLM مجاني؟
الشيفرة بترخيص Apache-2.0. أما عتاد GPU والتشغيل فعلى حسابك.
هل يحل vLLM محل Ollama؟
هما مقاربتان: يستهدف vLLM الخدمة لعدة مستخدمين على خادم، وOllama الراحة على محطة محلية. راجع حزمة الذكاء الاصطناعي مفتوحة المصدر المستضافة ذاتيًا.
أين أجد القائمة الدقيقة للمقاييس؟
في صفحة «Production Metrics» من الوثائق، أو مباشرة على النقطة /metrics في الإصدار الذي تشغّله.
الخلاصة
vLLM محرك استدلال نشط جدًا، يتيح ما يلزم لقياس الطابور والذاكرة وأزمنة الاستجابة. ثبّته بحسب الوثائق، وفعّل المقاييس من اليوم الأول، وأضف التتبعات إن احتجتها، وقرّر بشأن جمع الاستخدام قبل الانتقال إلى الإنتاج.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا للمشاريع المذكورة. العلامات التجارية المذكورة ملك لأصحابها. الأدوات تتطور بسرعة، لذا تحقق دائمًا من الأوامر والخيارات في وثائقها الرسمية (docs.vllm.ai).