استضافة Mistral Large 4 ذاتيًا هي السؤال الذي تطرحه فرق المنصات منذ إعلان 6 أكتوبر 2026. وقبل طلب وحدات GPU، يجب الفصل بين ما نُشر فعلًا وما وُعد به. في تاريخ هذا المقال (15 أكتوبر 2026) تقدّم Mistral نسخة تجريبية من النموذج عبر واجهة API ومنصتها Mistral Studio، وتعلن نشر الأوزان «قبل نهاية الشهر». ولا يوجد حتى الآن أي مستودع للأوزان تحت حساب mistralai على Hugging Face، والترخيص غير منشور.
لذلك لا يمكن بعد استضافة Mistral Large 4 ذاتيًا. لكن يمكن تمهيد الأرض: تقدير الذاكرة اللازمة انطلاقًا من الأرقام الرسمية، والاستناد إلى ما وثّقته Mistral لـ Mistral Large 3، وإعداد مراقبة خادم استدلال متعدد وحدات GPU. وهذا موضوع هذا الدليل الموجَّه إلى التشغيل.
هذا الموضوع لا يعتمد على Dynatrace: المقاييس المذكورة بصيغة Prometheus ويمكن جمعها بأي واجهة خلفية، ومنها Dynatrace SaaS وDynatrace Managed.
Mistral Large 4: ما نُشر حتى 15 أكتوبر 2026
يقدّم إعلان Mistral الرسمي العناصر التالية:
- نموذج بنحو 1000 مليار معامل، منها 52 مليارًا نشطة لكل رمز (token): أي بنية خليط الخبراء (MoE)؛
- نموذج متعدد الوسائط أصلًا (إدخال نصي وصوري)، يجمع التعليمات والاستدلال في نموذج واحد؛
- تدريب على 3800 وحدة NVIDIA Grace Blackwell GPU في مراكز بيانات Mistral؛
- نسخة تجريبية متاحة عبر API، وأوزان موعودة قبل نهاية الشهر، ومزيد من تفاصيل البنية في ذلك الحين.
ما ينقص لتحديد الحجم بجدية: الترخيص، وطول السياق، وصيغ الأوزان المنشورة (FP8 أو NVFP4 أو غيرها)، وإصدار vLLM المدعوم. وما دامت هذه النقاط غير منشورة، يبقى كل رقم للعتاد تقديرًا.
تقدير ذاكرة نموذج من 1000 مليار معامل
في نموذج MoE يجب أن تقيم كل الخبراء في ذاكرة GPU، ولو لم يعمل منهم إلا قليل لكل رمز. فالذاكرة تتبع العدد الإجمالي للمعاملات، أما الحساب لكل رمز فيتبع المعاملات النشطة. ويُحسب حجم الأوزان وحدها ببساطة:
poids (octets) = paramètres totaux × octets par paramètre

1 000 milliards × 2 octets   (BF16)      ≈ 2 To
1 000 milliards × 1 octet    (FP8)       ≈ 1 To
1 000 milliards × 0,5 octet  (4 bits)    ≈ 0,5 To
ويجب أن تضيف إليها ذاكرة المفتاح والقيمة المخبأة (KV cache) التي تكبر مع طول السياق وعدد الطلبات المتزامنة، وهامش محرك الاستدلال. هذه الأوامر من الحجم تكفي لاستنتاج أولي: حتى مكمَّمًا، يستهدف Mistral Large 4 عقدة GPU من فئة مراكز البيانات، أو عدة عقد، لا محطة عمل. وللاستخدام المحلي تبقى النماذج الأصغر التي يقدمها Ollama هي الخيار الواقعي.
النقطة المرجعية المنشورة: Mistral Large 3
تقدّم صفحة Mistral Large 3 على Hugging Face (675 مليار معامل إجمالًا، 41 مليارًا نشطة، ترخيص Apache 2.0، سياق 256k رمز) أرقام نشر رسمية:
- نسخة FP8 تعمل على عقدة واحدة من B200 أو H200، مع مثال على عقدة 8xH200؛
- نسخة NVFP4 تعمل على عقدة واحدة من H100 أو A100.
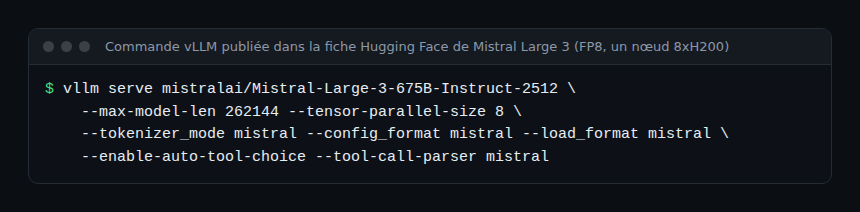
وبالدقة نفسها، يزيد عدد معاملات Large 4 نحو 1.5 مرة على Large 3. فانتظر الصفحة الرسمية قبل الجزم بأن عقدة واحدة تكفي: صيغة التكميم المنشورة ستغيّر كل شيء. وتذكّر صفحة Large 3 أيضًا بأن --max-model-len يمكن تخفيضه لتوفير الذاكرة، وهو أول رافعة إذا ضاق مكان KV cache.
عمليًا: التحضير للاستضافة الذاتية
الخطوة 1 — الاختبار على النسخة التجريبية عبر API
قِس منذ الآن حالات استخدامك الحقيقية على واجهة API: متوسط طول التعليمات (prompts) وطول الإجابات والحاجة إلى سياق طويل واستدعاءات الأدوات. تحدد هذه القياسات طول السياق الواجب ضبطه والتزامن المتوقع، وبالتالي حجم KV cache.
الخطوة 2 — التحقق من السلسلة على Mistral Large 3
يمكن ضبط خط النشر (تخزين الأوزان، والتنزيل، والتشغيل، وفحوص الصحة، والمراقبة) مع Large 3 الذي نُشرت أوزانه وترخيصه. وعلى عدة وحدات GPU، يقسّم vLLM النموذج بتوازي الموترات (--tensor-parallel-size) وعند الحاجة بتوازي خط الأنابيب (--pipeline-parallel-size). وعلى عقدة واحدة يعتمد على multiprocessing، وعلى عدة عقد يعتمد على Ray.
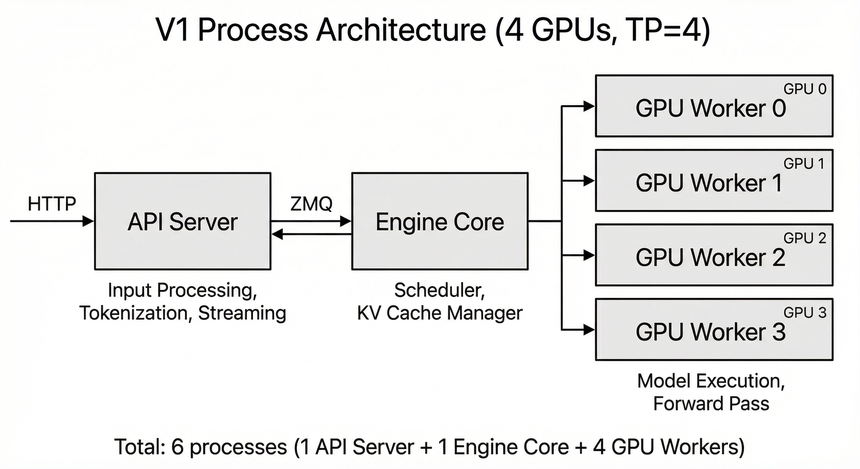
يبيّن هذا المخطط ما يجب مراقبته: خادم API (دخل HTTP والتحليل إلى رموز)، ونواة المحرك (المجدول وKV cache)، وعملية لكل GPU. وسقوط GPU واحدة يوقف الحالة كلها: مع توازي الموترات لا يوجد تدهور جزئي.
الخطوة 3 — ربط المراقبة
يعرض vLLM مقاييسه بصيغة Prometheus على المسار /metrics بالبادئة vllm:. وفي نموذج MoE كبير تابع بالأولوية:
vllm:kv_cache_usage_perc: حصة KV cache المستخدمة (من 0 إلى 1). وإذا اقتربت من 1 انتظرت الطلبات؛vllm:num_requests_running: الطلبات الجارية؛vllm:time_to_first_token_seconds: الزمن حتى أول رمز (TTFT)، وهو حساس لطول التعليمات؛vllm:inter_token_latency_seconds: التأخر بين رمزين، ويحسّه المستخدم مباشرة أثناء البث؛vllm:request_queue_time_secondsوvllm:e2e_request_latency_seconds: زمن الانتظار والمدة الكلية؛vllm:prompt_tokens_totalوvllm:generation_tokens_total: الحجم المعالَج، لحساب كلفة الرمز.
تفاصيل الجمع ولوحات المعلومات في دليلنا vLLM في الإنتاج. وأضف مقاييس وحدات GPU (الذاكرة والحرارة والاستخدام): في عقدة بثماني وحدات، يبطئ مكوّن واحد محترق الدفعة كلها.
كيف تتحقق من أن كل شيء يعمل
- الأمر
curl http://localhost:8000/v1/modelsيعيد اسم النموذج المقدَّم. - الأمر
curl -s http://localhost:8000/metrics | grep vllm:kv_cache_usage_percيعيد قيمة بين 0 و1. - تحت حمل اختبار، يبقى TTFT عند p95 دون هدفك، ولا تبقى
vllm:kv_cache_usage_percملتصقة بالقيمة 1.
أفضل الممارسات
- لا تثبّت أي ميزانية عتاد قبل نشر الصفحة الرسمية وترخيص Mistral Large 4.
- حدّد أهداف مستوى الخدمة (SLO) قبل النشر: TTFT وزمن الاستجابة بين الرموز والتوافر. فهي تحدد التزامن المقبول.
- احسب زمن البدء: تحميل نموذج بهذا الحجم يستغرق وقتًا، فيطول التعافي بعد الحوادث (MTTR).
- خزّن الأوزان أقرب ما يمكن من العقد: إعادة تنزيل 1 تيرابايت عند كل إعادة تشغيل ليست استراتيجية.
- قارن مع واجهة API: بحسب حجمك قد لا تُبرَّر كلفة عقدة مخصصة. يساعدك استعراضنا لمكدسات الذكاء الاصطناعي المستضافة ذاتيًا على الحسم.
الأسئلة الشائعة
هل يمكن تنزيل Mistral Large 4 اليوم؟
لا، ليس في 15 أكتوبر 2026. تعلن Mistral الأوزان لنهاية الشهر؛ والمتاح فقط هو النسخة التجريبية عبر API.
هل سيكون Mistral Large 4 بترخيص Apache 2.0؟
هذا غير منشور. Large 3 كذلك، لكن لا شيء يضمن أن يتبع Large 4 الترخيص نفسه. اقرأ صفحة النموذج عند صدوره.
لماذا لا تكفي 52 مليار معامل نشط لتقليل الذاكرة؟
لأن الموجِّه (router) قد يختار أي خبير عند كل رمز: يجب تحميلهم جميعًا. المعاملات النشطة تقلل الحساب لا ذاكرة الأوزان.
الخلاصة
Mistral Large 4 غير قابل للاستضافة الذاتية بعد، لكن حجمه التقريبي معروف: نحو 1000 مليار معامل، أي عقدة GPU واحدة على الأقل من فئة مراكز البيانات. اغتنم فترة الانتظار لقياس استخداماتك على API وضبط السلسلة مع Mistral Large 3 وربط المراقبة. وللتعمق في متطلبات هذا النوع من الأحمال، اقرأ ما تتطلبه أحمال الذكاء الاصطناعي من فرق SRE. المصادر: إعلان Mistral Large 4 وصفحة Mistral Large 3.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة Mistral AI. العلامات التجارية المذكورة ملك لأصحابها. الأدوات تتطور بسرعة، لذا تحقق دائمًا من الأوامر والخيارات في وثائقها الرسمية.