تجمع مقارنة نماذج LLM مفتوحة المصدر هذه، لثمانية نماذج بأوزان مفتوحة، الخصائص التي تحسم قرار النشر: الترخيص، وعدد المعاملات (parameters)، وذاكرة GPU التي تعلنها الجهة المصنِّعة، وحجم التنزيل في Ollama، وأمر التشغيل في vLLM. كل قيمة مأخوذة من الصفحة الرسمية للنموذج على Hugging Face أو من مكتبة Ollama أو من موقع الجهة المصنِّعة، التي رُجع إليها في أكتوبر 2026. وما لم يرد فيها لم نكتبه.
لا تتضمن المقارنة أرقام معدل المعالجة. فالمعدلات المنشورة تتوقف على GPU والتكميم وطول الطلبات والتزامن، ولا تنتقل من بيئة إلى أخرى. ويبيّن الجزء الثاني كيف تقيس بنفسك معدل المعالجة وزمن الاستجابة بواسطة vllm bench serve وواجهة Ollama البرمجية على عتادك.
لمنهج الاختيار وفق معايير التشغيل (زمن الاستجابة والامتثال للائحة GDPR وكلفة المهمة)، راجع اختيار النموذج اللغوي. وللبنية التي تحيط بالنموذج، راجع مكدس الذكاء الاصطناعي مفتوح المصدر المستضاف ذاتيًا.
مقارنة نماذج LLM مفتوحة المصدر: الجدول
| النموذج | الترخيص | المعاملات | الذاكرة التي تذكرها الجهة المصنِّعة | Ollama: الوسم والحجم والسياق |
|---|---|---|---|---|
| gpt-oss-20b (OpenAI) | Apache 2.0 | 21 مليارًا، منها 3.6 مليار نشطة | يتسع في 16 غيغابايت من الذاكرة (MXFP4) | gpt-oss:20b، 14 غيغابايت، 128K |
| gpt-oss-120b (OpenAI) | Apache 2.0 | 117 مليارًا، منها 5.1 مليار نشطة | وحدة GPU واحدة بسعة 80 غيغابايت (H100 أو MI300X) | gpt-oss:120b، 65 غيغابايت، 128K |
| Qwen3-8B (Alibaba Qwen) | Apache 2.0 | 8.2 مليار | غير مذكورة | qwen3:8b، 5.2 غيغابايت، 40K |
| Qwen3-30B-A3B (Alibaba Qwen) | Apache 2.0 | 30.5 مليارًا، منها 3.3 مليار منشَّطة | غير مذكورة | qwen3:30b، 19 غيغابايت، 256K |
| Mistral Small 3.2 24B (Mistral AI) | Apache 2.0 | 24 مليارًا | نحو 55 غيغابايت بصيغة bf16 أو fp16 | mistral-small3.2:24b، 15 غيغابايت، 128K |
| Ministral 3 8B (Mistral AI) | Apache 2.0 | 8.9 مليار (الأوزان المنشورة) | يتسع في 12 غيغابايت من VRAM بصيغة FP8 | ministral-3:8b، 6.0 غيغابايت، 256K |
| Gemma 3 27B (Google) | Gemma Terms of Use | 27.4 مليار (الأوزان المنشورة) | لم تُراجَع (صفحة بوصول مقيَّد) | gemma3:27b، 17 غيغابايت، 128K |
| Llama 3.3 70B (Meta) | Llama 3.3 Community License | 70.6 مليار (الأوزان المنشورة) | لم تُراجَع (صفحة بوصول مقيَّد) | llama3.3:70b، 43 غيغابايت، 128K |
قراءة الجدول:
- المعاملات: القيمة من صفحة النموذج؛ وحين لا تذكرها الصفحة فهي إجمالي الأوزان المنشورة كما يعرضه Hugging Face. و«النشطة» تخص نماذج خليط الخبراء (MoE) التي لا تستخدم إلا جزءًا من أوزانها لكل رمز (token).
- حجم Ollama: حجم تنزيل الوسم الافتراضي، وهو مكمَّم أصلًا. وفي Mistral Small 3.2 يطابق الوسم الافتراضي المتغير
q4_K_M. ويأخذ عمود السياق النافذة التي يعرضها Ollama لهذا الوسم. - الوصول المقيَّد: تشترط صفحتا Gemma 3 وLlama 3.3 قبول الترخيص على Hugging Face قبل التنزيل.
الترخيص: ما الذي يتغير في الإنتاج
ستة من النماذج الثمانية بترخيص Apache 2.0: الاستخدام التجاري والتعديل وإعادة التوزيع مسموح بها، بشرط الاحتفاظ بالترخيص والإشعارات. وتصف صفحة gpt-oss هذا الترخيص بأنه متساهل «دون قيود copyleft ولا مخاطر براءات». أما Gemma 3 وLlama 3.3 فلهما ترخيصان خاصان بالجهة المصنِّعة بشروط استخدام، فاعرضهما على الإدارة القانونية قبل أي نشر، خصوصًا لمنتج يُوزَّع على العملاء.
الحجم وذاكرة GPU: قدّر قبل أن تشتري
ثلاث صفحات فقط تذكر حاجة صريحة إلى الذاكرة: gpt-oss (16 غيغابايت لـ 20b، ووحدة GPU بسعة 80 غيغابايت لـ 120b، بفضل تكميم MXFP4 لأوزان MoE)، وMistral Small 3.2 (نحو 55 غيغابايت بصيغة bf16/fp16)، وMinistral 3 8B (12 غيغابايت من VRAM بصيغة FP8). وبالنسبة إلى الباقي يمكن حساب رتبة الحجم: في bf16 يشغل كل معامل بايتين، فنموذج من 8 مليارات معامل يزن نحو 16 غيغابايت للأوزان وحدها. ويبيّن رقم Mistral Small 3.2 (24 مليار معامل، نحو 55 غيغابايت) الهامش الواجب توقعه فوق الأوزان: KV cache والتنشيطات والسياق الطويل.
نماذج MoE كثيرًا ما تضلل: Qwen3-30B-A3B ينشّط 3.3 مليار معامل فقط لكل رمز، لكن الـ 30.5 مليارًا كلها يجب أن تتسع في الذاكرة. فالكسب في الحساب لا في VRAM.
ونافذة السياق مؤثرة أيضًا. تذكر صفحة Qwen3-8B أن السياق الأصلي 32768 رمزًا و131072 مع YaRN، وتوضح أن هذا الوضع غير مستحسن إذا بقيت سياقاتك دون 32768 رمزًا لأنه قد يخفض الأداء.
قياس معدل المعالجة على vLLM وOllama
الخطوة 1 — تشغيل النموذج
# vLLM : serveur compatible avec l'API OpenAI (commande des fiches gpt-oss)
vllm serve openai/gpt-oss-20b

# Ollama
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
تقدّم صفحات gpt-oss وQwen3 وMistral Small 3.2 أمر vllm serve الخاص بكل منها. وتفعّل صفحة Qwen3-8B الاستدلال بالمعاملين --enable-reasoning --reasoning-parser deepseek_r1: وهو معامل يغيّر عدد الرموز المنتَجة، وبالتالي معدل المعالجة الظاهر.
الخطوة 2 — القياس بواسطة vllm bench serve
يوفّر vLLM أداة قياس من جهة العميل. ويعرض دليله النتيجة المتوقعة:
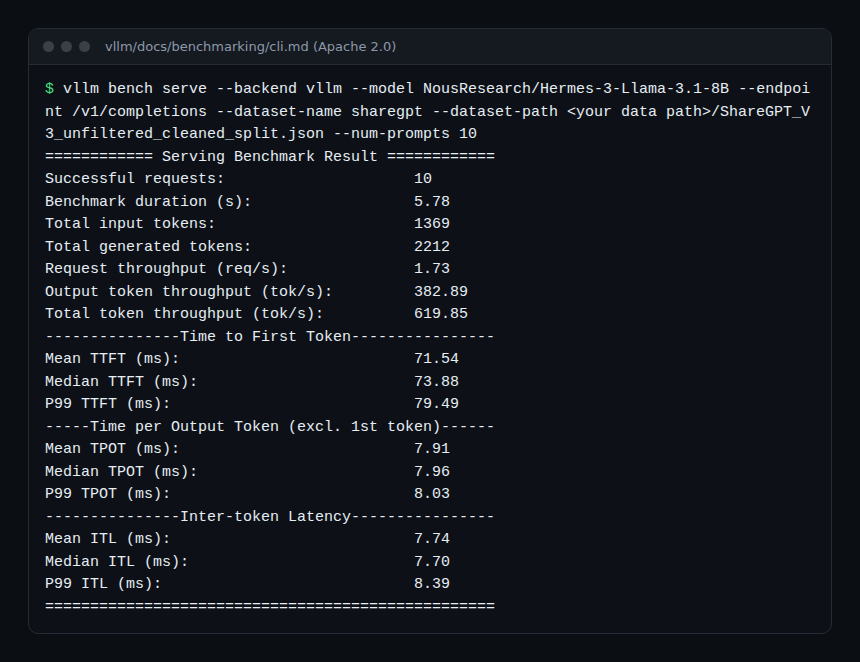
الأسطر الواجب مقارنتها بين النماذج هي Output token throughput (tok/s) وP99 TTFT (ms) وP99 ITL (ms). وقيم الصورة هي قيم مثال الوثائق مع نموذج آخر: فهي توضح الصيغة لا أداءً. وتحذّر الوثائق من أن تكرار القياس على الخادم نفسه قد يعيد استخدام ذاكرة البادئات المخبأة فيضخّم المعدل: غيّر --seed أو أعد تشغيل الخادم أو استخدم vllm bench sweep serve. وتوصي أيضًا بـ GuideLLM لخوادم الإنتاج.
الخطوة 3 — القياس بواسطة واجهة Ollama
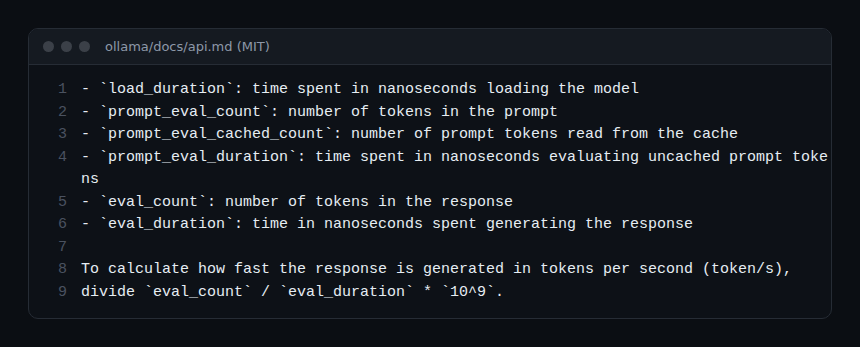
تحتوي الاستجابة النهائية لواجهة Ollama على مدد بالنانوثانية وعدّادات رموز:
curl -s http://localhost:11434/api/generate \
  -d '{"model": "gpt-oss:20b", "prompt": "Résume la RFC 9110 en trois lignes.", "stream": false}' \
  | jq '.eval_count / .eval_duration * 1e9'
الصيغة هي صيغة وثائق Ollama: القيمة eval_count / eval_duration × 10^9 تعطي الرموز المولَّدة في الثانية. قِس على البارد وعلى الساخن: يبيّن load_duration زمن تحميل النموذج الذي يثقل الطلب الأول.
كيف تتحقق من عدالة المقارنة
- وحدة GPU نفسها والتكميم نفسه وطول الإدخال والإخراج نفسه لجميع النماذج.
- عدة مستويات من التزامن (
--max-concurrency): نموذج سريع بمفرده قد ينهار عند 32 طلبًا متزامنًا. - وضع الاستدلال مفعّل أو معطّل بالطريقة نفسها للنماذج التي تقدمه.
- في الإنتاج تؤكد مقاييس Prometheus في vLLM القياسات: راجع vLLM في الإنتاج، ولـ Ollama راجع مراقبة Ollama.
أفضل الممارسات
- سجّل المراجعة الدقيقة للنموذج (التاريخ أو hash على Hugging Face، وdigest في Ollama): فوسم مثل
latestقد يتغير. - اختبر الجودة على طلباتك أنت: معدل المعالجة لا يقول شيئًا عن صحة الإجابات.
- خطط للذاكرة وفق السياق الفعلي لطلباتك، لا للأوزان فقط.
- أبقِ واجهة API متوافقة مع OpenAI أمام النموذج لتغييره دون إعادة كتابة التطبيق.
- فعّل OpenTelemetry على الاستدعاءات منذ النموذج التجريبي: يمكن بعد ذلك مقارنة زمن الاستجابة والرموز والأخطاء في Dynatrace SaaS بواسطة DQL، أو في حزمة Prometheus وGrafana إلى جانب Dynatrace Managed.
الأسئلة الشائعة
لماذا لا تذكر هذه المقارنة عدد الرموز في الثانية؟
لأن أي قيمة منشورة لا تنطبق على عتادك. فليست كل الجهات المصنِّعة تنشر معدلات، وما يوجد منها يتوقف على GPU والتكميم والحمل. وقياس لثلاثين دقيقة بـ vllm bench serve أفضل من رقم منسوخ.
Ollama أم vLLM للمقارنة؟
Ollama لجهاز عمل أو اختبار سريع بنماذج مكمَّمة؛ وvLLM لقياس سلوك خادم تحت حمل متزامن. وكلاهما يعرض واجهة API متوافقة مع OpenAI.
«مفتوح المصدر» أم «أوزان مفتوحة»؟
تنشر هذه النماذج أوزانها بترخيص معين؛ أما بيانات التدريب وشيفرته فلا تُنشر بالضرورة. وفي الإنتاج المهم هو ترخيص الأوزان، ومن هنا العمود الثاني في الجدول.
الخلاصة
تقتصر مقارنة نماذج LLM مفتوحة المصدر المفيدة على ما يمكن التحقق منه: الترخيص والمعاملات والذاكرة المعلنة والوسوم المتاحة. أما معدل المعالجة فيُقاس عندك، بالأدوات نفسها لجميع المرشحين. الجدول للاستبعاد، ومنصة القياس للحسم.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا للجهات المصنِّعة أو المشاريع المذكورة. العلامات التجارية المذكورة ملك لأصحابها. صفحات النماذج تتغير: تحقق من الترخيص والخصائص في الصفحة الرسمية قبل أي نشر.