

Browsing Tag
vLLM
8 posts
Ollama vLLM llama.cpp: أي محرك محلي تختار لنماذج LLM؟
Ollama vLLM llama.cpp: قارن بين محركات الاستدلال المحلية الثلاثة بحسب الاستخدام والعتاد والمراقبة (المقاييس والصحة والتتبعات).

خادم vLLM لاستدلال LLM: التثبيت والمراقبة
خادم vLLM لاستدلال LLM مفتوح المصدر: التثبيت بحسب الوثائق، والمعمارية، ومقاييس الخدمة (الطابور وذاكرة KV وTTFT) وتتبعات OpenTelemetry.
مقارنة نماذج LLM مفتوحة المصدر: الترخيص والحجم وVRAM ومعدل المعالجة المقيس على vLLM وOllama
مقارنة نماذج LLM مفتوحة المصدر: الترخيص والمعاملات وذاكرة GPU ووسوم Ollama لثمانية نماذج موثقة، ومنهج قياس معدل المعالجة على vLLM.
اختيار نموذج لغوي كبير في أكتوبر 2026: معايير التشغيل قبل الاختبارات المعيارية
اختيار نموذج لغوي كبير في 2026 بمعايير التشغيل: زمن الاستجابة والاستضافة وRGPD وقابلية الملاحظة بـ OpenTelemetry والتكلفة لكل مهمة، مع تجربة تجريبية.
الذكاء الاصطناعي المحلي في ONLYOFFICE مع Ollama أو vLLM: البنية والإعداد والمراقبة
الذكاء الاصطناعي المحلي في ONLYOFFICE: اربط Docs 10.0 بـ Ollama أو vLLM، واضبط aiSettings والوسيط /ai-proxy، وراقب TTFT وStatsD عبر OpenTelemetry.
Mistral Large 4 بالاستضافة الذاتية: ما نُشر فعلًا وتحديد الحجم والمراقبة
Mistral Large 4 بالاستضافة الذاتية: الأوزان لم تُنشر بعد، والذاكرة اللازمة لنموذج من 1000 مليار معامل، ومراقبة vLLM على عدة وحدات GPU.
مكدس الذكاء الاصطناعي المستضاف ذاتيًا: مقارنة بين مكونات البنية التحتية مفتوحة المصدر
مكدس الذكاء الاصطناعي المستضاف ذاتيًا: مقارنة Ollama وvLLM وOpen WebUI وLlamaIndex وCrewAI وDify وn8n وLangfuse وتركيبات نموذجية جاهزة.
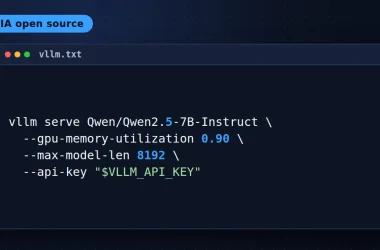
vLLM في الإنتاج: خادم متوافق مع OpenAI ومقاييس Prometheus ومراقبة وحدات GPU
vLLM في الإنتاج: انشر خادمًا متوافقًا مع OpenAI وتابع الطابور وKV cache وTTFT ووحدات GPU عبر Prometheus وOpenTelemetry وDynatrace.