إن اختيار نموذج لغوي كبير (LLM) في أكتوبر 2026 اعتمادًا على التصنيفات العامة يشبه اختيار خادم من نشرته التجارية. فالاختبارات المعيارية (benchmarks) تقيس نموذجًا معزولًا، على أسئلة ليست أسئلتك، بلا شبكة ولا حصص استخدام ولا قيود على مكان معالجة البيانات. أما ما يُسقط خدمة في الإنتاج فمكانه آخر: زمن استجابة أول رمز (token) يتضاعف في ساعات الذروة، أو مزوّد يعالج البيانات خارج الاتحاد الأوروبي، أو أداة قياس يستحيل ربطها بنظام المراقبة القائم.
يقترح هذا المقال شبكة اختيار تتمحور حول التشغيل: زمن الاستجابة والاستضافة وRGPD وقابلية الملاحظة والتكلفة. لا يقدّم تصنيفًا ولا يذكر أي سعر، لأن الأسعار تتغير كثيرًا ويجب قراءتها في صفحات المزوّدين يوم اتخاذ القرار. والخصائص المذكورة مستمدة من الوثائق الرسمية التي اطُّلع عليها في أكتوبر 2026.
تنتهي المنهجية المقترحة بتجربة تجريبية (pilot) مزوّدة بـ OpenTelemetry، تقارن النماذج المرشحة على طلباتك أنت. وللإطار العام راجع مقالنا المحوري عن قابلية ملاحظة الذكاء الاصطناعي.
لماذا لا تكفي الاختبارات المعيارية
يجيب الاختبار المعياري عن سؤال «هل يعرف هذا النموذج أن يؤدي المهمة؟». أما التشغيل فيطرح أسئلة أخرى: هل يستجيب بسرعة كافية عند المئين 95؟ وماذا يحدث حين يحدّ المزوّد من معدل الطلبات؟ وأين تُعالج البيانات؟ وهل يمكن رؤية كل استدعاء ضمن تتبّع؟ وكم تكلّف مهمة كاملة، لا مجرد مليون رمز؟ قد يختلف نموذجان متقاربان في التصنيف اختلافًا كبيرًا في ملف التشغيل. ومتطلبات SRE لأحمال الذكاء الاصطناعي تنطبق منذ لحظة اختيار النموذج.
اختيار نموذج لغوي كبير: شبكة معايير التشغيل
1. زمن الاستجابة: أول رمز، ومعدل المعالجة، وطابور الانتظار
في واجهة المحادثة، يهمّ الزمن حتى أول رمز (TTFT) أكثر من المدة الكلية. وبالنسبة إلى وكيل يسلسل عشرة استدعاءات، فالمهم هو المدة من طرف إلى طرف. قِس الاثنين عند المئين 95 في ساعة الذروة.
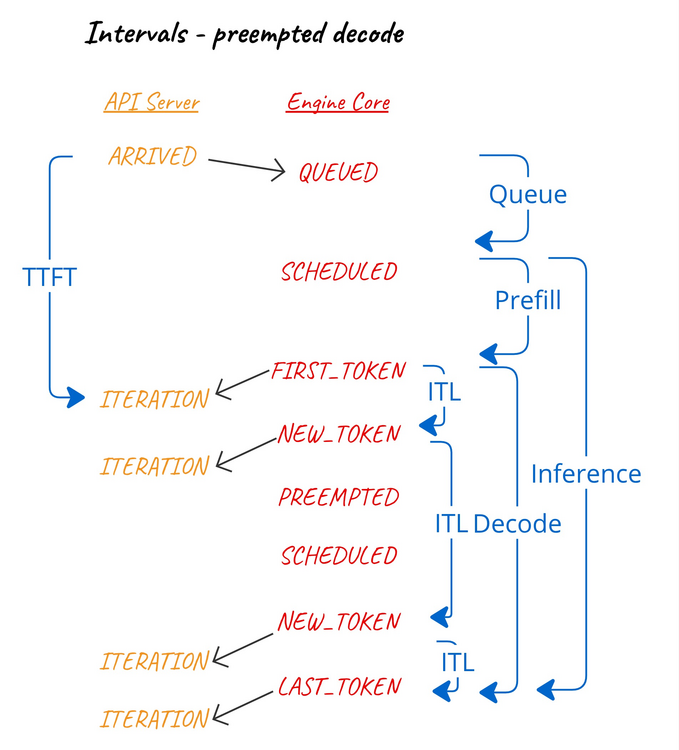
يوضح المخطط أعلاه، المأخوذ من وثائق التصميم في vLLM، ما يحتويه TTFT: طابور الانتظار ثم prefill ثم التوليد. وعلى نموذج مستضاف ذاتيًا، يعرض vLLM هذه الفترات في صورة مقاييس Prometheus (vllm:time_to_first_token_seconds وvllm:inter_token_latency_seconds وvllm:request_queue_time_seconds وvllm:e2e_request_latency_seconds). راجع vLLM في الإنتاج.
2. الاستضافة: واجهة API أم سحابة أم استضافة ذاتية
- واجهة API لدى المزوّد: لا شيء يُشغَّل من جهة وحدات GPU، لكن مع اعتماد خارجي له حصصه وأعطاله.
- نموذج عبر مزوّد سحابة كبير (hyperscaler): تُحدَّد المنطقة بنقطة النهاية. فوثائق Anthropic توضح مثلًا أن منطقة الاستدلال على Amazon Bedrock وGoogle Cloud تحددها عنوان URL لنقطة النهاية أو ملف الاستدلال (inference profile).
- الاستضافة الذاتية: تتطلب نموذجًا مفتوح الأوزان وترخيصًا متوافقًا. تنشر Mistral في قائمة نماذجها ترخيص كل نموذج: Mistral Small 4 وعائلة Ministral 3 (3B وَ8B وَ14B) بترخيص Apache 2.0، وMistral Medium 3.5 بترخيص MIT معدّل. يقدّم vLLM هذه النماذج خلف خادم متوافق مع واجهة OpenAI (
vllm serve)، ويغطي Ollama الاستخدامات الأخف.
3. RGPD وموقع البيانات
يوفّر المزوّدون الثلاثة الذين جرت مراجعتهم وسائل تحكم، بشروط مختلفة:
- Mistral AI: بحسب مركز المساعدة لديها، تُستضاف البيانات افتراضيًا في الاتحاد الأوروبي؛ واستخدام نقطة النهاية الأمريكية صراحةً يستضيفها في الولايات المتحدة. وقد تنقل بعض الميزات البيانات مؤقتًا خارج الاتحاد الأوروبي إلى المعالجين الفرعيين المدرجين في Trust Center.
- OpenAI: ضوابط إقامة البيانات خيار على مستوى المشروع، ويخضع لأهلية تُقرَّر مع الفريق التجاري. تستخدم منطقة أوروبا (المنطقة الاقتصادية الأوروبية + سويسرا) العنوان
eu.api.openai.com. وتذكر الوثائق زيادة بنسبة 10% على نقاط النهاية هذه للنماذج المؤهلة الصادرة اعتبارًا من 5 مارس 2026، وتستثني بيانات النظام (الحساب والفوترة وإحصاءات الاستخدام). - Anthropic: يحدد المعامل
inference_geoمكان تنفيذ الاستدلال (globalافتراضيًا أوus) على نماذج Claude 4.6 وما بعدها؛ أما الموقع الجغرافي لتخزين مساحة العمل فهو حاليًاusفقط.
تحقق من هذه الشروط في العقد واتفاقية معالجة البيانات (DPA): فصفحة وثائق لا تغني عن رأي مسؤول حماية البيانات (DPO) لديك.
4. قابلية الملاحظة
نموذج لا يمكن تتبّعه نموذج لا يمكن تشغيله. من الأسئلة التي تُطرح: هل توجد أداة قياس OpenTelemetry لحزمة SDK الخاصة به (OpenLLMetry أو OpenLIT أو أداة قياس الإطار)؟ وهل ترجع استجابة الواجهة استخدام الرموز؟ بل إن Anthropic تُرجع في الكائن usage حقلًا اسمه inference_geo يبيّن مكان تنفيذ الاستدلال، وهو مفيد لإثبات الموقع. وتتضمن اصطلاحات OpenTelemetry الخاصة بـ GenAI قيمًا معروفة للسمة gen_ai.provider.name، منها openai وanthropic وmistral وaws.bedrock وgcp.vertex_ai وazure.ai.openai. وفي جانب Dynatrace، يذكر تطبيق AI Observability بين المنصات المغطاة كلًا من OpenAI وAnthropic وGemini وAmazon Bedrock وAzure AI Foundry وVertex AI.
5. التكلفة لكل مهمة، لا لكل رمز
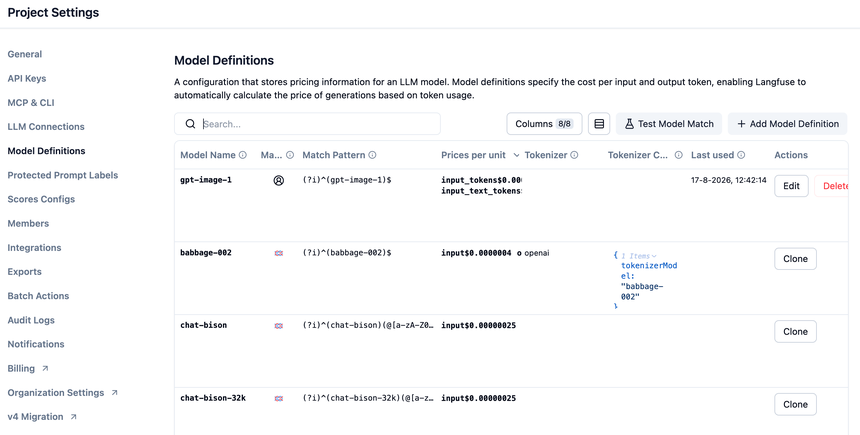
يُعبَّر عن السعر العام لكل مليون رمز؛ أما تكلفتك الفعلية فتتوقف على عدد الرموز التي يستهلكها النموذج لإنجاز مهمة، ورموز الاستدلال (reasoning)، والذاكرة المؤقتة (cache)، والزيادات الإقليمية. وأداة مثل Langfuse تخزّن أسعار كل نموذج في تعريفات وتحسب تكلفة كل عملية توليد من الاستخدام الفعلي.
عمليًا: تجربة تجريبية مزوّدة بأدوات القياس في خمس خطوات
الخطوة 1: كوّن مجموعة طلبات حقيقية
استخرج من 100 إلى 300 طلب ممثل لاستخدامك، بعد إخفاء هوية أصحابها. هذا هو اختبارك المعياري الخاص.
الخطوة 2: زوّد الشيفرة بالقياس مرة واحدة
مرّر الطلبات عبر الشيفرة نفسها، المزوّدة بـ OpenTelemetry، مع تغيير النموذج فقط. تحمل كل span القيم gen_ai.request.model وgen_ai.provider.name وgen_ai.usage.input_tokens / output_tokens.
الخطوة 3: قارن النماذج في Dynatrace SaaS
fetch spans
| filter gen_ai.operation.name == "chat"
| summarize requetes = count(),
            p95 = percentile(duration, 95),
            erreurs = countIf(span.status_code == "error"),
            entree_moy = avg(gen_ai.usage.input_tokens),
            sortie_moy = avg(gen_ai.usage.output_tokens),
            by:{gen_ai.request.model}
يصلح استعلام DQL هذا لـ Dynatrace SaaS (Grail). أما على Dynatrace Managed فلا يوجد DQL، لذا أجرِ المقارنة نفسها في أداة مفتوحة المصدر مثل Langfuse أو عبر مقاييس حزمة Prometheus لديك.
الخطوة 4: قيّم الجودة
اطلب من مستخدمي الأعمال مراجعة عيّنة من الإجابات، أو استخدم تقييمًا آليًا. نموذج سريع ورخيص لكن إجاباته خاطئة ليس اختيارًا جيدًا.
الخطوة 5: قرّر بشبكة موزونة
أعطِ كل معيار وزنًا بحسب الخدمة: الامتثال شرط إقصائي للبيانات الصحية، وTTFT أولوية للمساعد، والتكلفة لكل مهمة أولوية للمعالجة بالدفعات. دوّن النتيجة: فالاختيار سيُعاد بعد ستة أشهر.
كيف تتأكد من موثوقية التجربة
- تلقى كل نموذج العدد نفسه من الطلبات (العمود
requetes). - تتطابق مجاميع الرموز مع لوحة الاستخدام لدى كل مزوّد.
- أُخذت القياسات في أوقات متعددة، منها ساعة الذروة.
أفضل الممارسات
- احتفظ بطبقة تجريد (واجهة متوافقة مع OpenAI أو بوابة) لتتمكن من تغيير النموذج دون إعادة كتابة التطبيق.
- جهّز نموذجًا احتياطيًا واختبر عملية التحويل إليه.
- ثبّت الإصدار الدقيق للنموذج في الإنتاج، وراقب
gen_ai.response.model. - أعد قراءة سياسة دورة الحياة لدى المزوّد: سحب نموذج يفرض ترحيلًا.
- أعد تشغيل التجربة مع كل إصدار جديد مهم.
الأسئلة الشائعة
هل يلزم نموذج مستضاف ذاتيًا حتمًا للامتثال لـ RGPD؟
لا. يقدّم عدة مزوّدين معالجة داخل أوروبا بشروط. أما الاستضافة الذاتية فتمنح تحكمًا كاملًا لكنها تنقل تشغيل وحدات GPU إلى فريقك: راجع حزمة ذكاء اصطناعي مستضافة ذاتيًا.
لماذا لا تُذكر أسعار؟
لأنها تتغير كثيرًا وتتوقف على المنطقة والذاكرة المؤقتة والحجم. قِس التكلفة لكل مهمة أثناء التجربة، بأسعار اليوم.
كم نموذجًا تجب مقارنته؟
يكفي اثنان أو ثلاثة: نموذج متقدم، ونموذج أخف، وإن اقتضت البيانات ذلك، نموذج مفتوح الأوزان مستضاف ذاتيًا.
الخلاصة
اختيار نموذج لغوي كبير هو اختيار مكوّن إنتاجي. فزمن الاستجابة عند المئين 95، وموقع البيانات، والقدرة على تتبّع كل استدعاء، والتكلفة لكل مهمة، تحسم الأمر أكثر من الترتيب في أي تصنيف. وتجربة تجريبية مزوّدة بـ OpenTelemetry على طلباتك أنت تحوّل هذا الاختيار إلى قرار مقيس يسهل تكراره.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا للمشاريع أو المزوّدين المذكورين. العلامات التجارية المذكورة ملك لأصحابها. العروض تتطور بسرعة، لذا تحقق من الشروط والخيارات في وثائقها الرسمية.