الاختيار بين Ollama vLLM llama.cpp هو في الحقيقة اختيار محرك استدلال (inference) محلي: البرنامج الذي يحمّل نموذجًا في الذاكرة ويجيب عن الطلبات. الثلاثة مفتوحة المصدر، وكلها تعرض واجهة HTTP، ومع ذلك لا تخدم الحاجة نفسها. يقارن هذا المقال بين استخداماتها وما تقدمه للمراقبة وطريقة اتخاذ القرار.
الزاوية هنا هي زاوية فريق SRE أو فريق المنصة. السؤال ليس «أيها أسرع؟» فحسب، بل «أيها يمكن تشغيله ومراقبته وتأمينه؟». الادعاءات التالية مستمدة من الوثائق الرسمية لكل مشروع، كما اطُّلع عليها وقت الكتابة. لا نقدّم أي اختبار أداء (benchmark): فالأداء يعتمد كثيرًا على العتاد وعلى النموذج.
Ollama vLLM llama.cpp: ثلاث فلسفات
يستهدف Ollama البساطة. يعرض مستودعه واجهة REST لتشغيل النماذج وإدارتها، وأمر ollama run للتحاور مع نموذج. وهو منشور بترخيص MIT. نشرح تثبيته في دليلنا Ollama LLM محلي.
يقدّم vLLM نفسه بوصفه مكتبة استدلال وخدمة لنماذج LLM «سهلة وسريعة ورخيصة». تبرز وثائقه PagedAttention لذاكرة الانتباه، والتجميع المستمر (continuous batching)، والملء المسبق على شكل أجزاء (chunked prefill)، وذاكرة التخزين المؤقت للبادئات. ويوفّر خادمًا متوافقًا مع واجهة OpenAI. راجع أيضًا vLLM في الإنتاج.
أما llama.cpp فهو تنفيذ بلغة C/C++ بلا أي اعتماديات، مبني على مكتبة ggml. يعلن README الخاص به عن واجهات خلفية (backends) كثيرة: Metal على Apple Silicon وCUDA وHIP وVulkan وSYCL، إضافة إلى الاستدلال الهجين بين CPU وGPU للنماذج الأكبر من VRAM. ويذكر التكميم (quantization) من 1.5 إلى 8 بت. وخادمه llama-server موصوف في مقالنا llama.cpp والاستدلال المحلي.
مقارنة: ما الذي يقدّمه كل محرك
| المعيار | Ollama | vLLM | llama.cpp |
|---|---|---|---|
| سهولة البدء | أمر واحد لتشغيل نموذج | الأمر vllm serve |
الملف التنفيذي llama-server وملف النموذج |
| العتاد الذي تذكره الوثائق | غير مفصّل في الصفحات المقروءة | وحدات GPU من NVIDIA وAMD، ومعالجات x86 وARM وPowerPC، وإضافات (plugins) | واسع جدًا: Metal وCUDA وHIP وVulkan وSYCL وCPU |
| التزامن | توازٍ لكل نموذج وطابور انتظار قابلان للضبط | تجميع مستمر | الخانات (--parallel) وتجميع مستمر مفعّل افتراضيًا |
| مقاييس Prometheus | غير متحقق منه في الأسئلة الشائعة المقروءة | نقطة النهاية /metrics |
نقطة النهاية /metrics عند تفعيل الخيار --metrics |
| المصادقة | غير متحقق منها؛ يُوصى بوكيل عكسي (reverse proxy) | غير متحقق منها في الصفحات المقروءة | الخيار --api-key |
خانات «غير متحقق منه» تشير إلى معلومة غائبة عن الصفحات التي اطُّلع عليها، لا إلى غياب الميزة. أعد قراءة وثائق الإصدار الذي تنشره.
كيف تختار محركًا محليًا بحسب الاستخدام؟
جهاز مطوّر أو خدمة داخلية صغيرة
Ollama هو الخيار الأكثر مباشرة. تُنزَّل النماذج وتُشغَّل دون ترجمة أي شيء. توثّق الأسئلة الشائعة عنده ما يلزم للاستخدام المشترك: OLLAMA_NUM_PARALLEL يحدد عدد الطلبات المعالجة بالتوازي لكل نموذج (1 افتراضيًا)، وOLLAMA_MAX_QUEUE طابور الانتظار قبل الرفض (512 افتراضيًا)، وOLLAMA_MAX_LOADED_MODELS عدد النماذج المحمّلة في آن واحد.
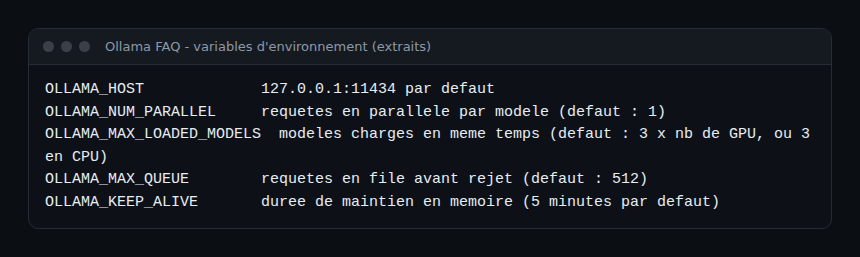
توضح الأسئلة الشائعة أن الخادم يستمع افتراضيًا على 127.0.0.1 والمنفذ 11434، وأن OLLAMA_HOST يغيّر العنوان. وتذكر أيضًا أن الطلبات المتوازية توسّع السياق الفعلي: سياق 2K مع 4 طلبات متوازية يصبح 8K، وبالتالي يحتاج إلى ذاكرة أكبر.
خدمة عالية الحركة على GPU
عندما يستدعي عملاء كثيرون النموذج نفسه، فإن vLLM مصمَّم لذلك: يجمع التجميع المستمر الطلبات الجارية. وميزته في التشغيل ثراء مقاييسه، كما نفصّل أدناه. أما الثمن فهو تثبيت أثقل وعتاد أكثر تطلبًا.
عتاد متنوع أو CPU أو Mac أو الأطراف
llama.cpp يغطي أكبر عدد من المنصات ويتيح تشغيل نموذج مكمَّم على جهاز متواضع. ويناسب أيضًا من يريد التحكم الدقيق في الخيارات، أو تضمين المحرك في برنامج آخر.
مراقبة المحرك المختار
المحرك المحلي خدمة كأي خدمة أخرى: له مؤشرات مستوى خدمة (SLI). أكثرها فائدة التوافر، والزمن حتى أول token، والزمن الكلي من البداية إلى النهاية، وطول طابور الانتظار، ونسبة الأخطاء. ويمنع SLO على زمن الاستجابة p95 أن يكتشف المستخدمون تشبّع GPU بأنفسهم.
vLLM: مقاييس غنية
تصف وثائق التصميم في vLLM المقاييس المعروضة على /metrics بصيغة Prometheus. ومنها على وجه الخصوص:
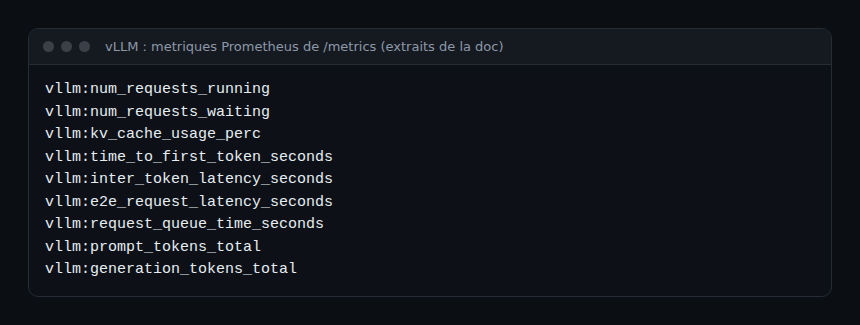
تكفي هذه الأسماء لبناء لوحة متابعة: التشبّع (الطلبات المنتظرة وذاكرة KV) والزمن (المدرّجات التكرارية) والإنتاجية (عدّادات tokens). وتنبّه الصفحة أيضًا إلى أن بعض المقاييس متقادمة أو غير منفّذة: تحقق من قائمة إصدارك قبل إنشاء التنبيهات.
llama.cpp: الصحة والخانات ومقاييس عند التفعيل
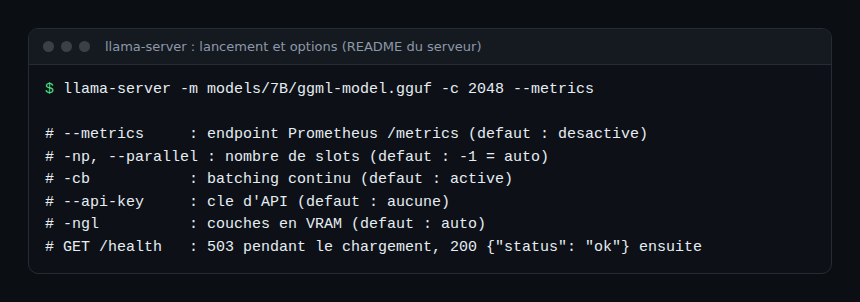
يصف README الخاص بالخادم نقطة /health، وهي عامة ومعفاة من مفتاح API: تردّ بالرمز 503 أثناء تحميل النموذج، ثم 200 مع {"status": "ok"}. أما نقطة /metrics المتوافقة مع Prometheus فلا توجد إلا إذا أُطلق الخادم بالخيار --metrics (معطّل افتراضيًا). وتصف نقطة /slots حالة معالجة الخانات؛ وهي مفعّلة افتراضيًا وتُعطَّل بالخيار --no-slots.
Ollama: مجسّات وتتبعات من جهة المستدعي
لا تصف الصفحات التي اطُّلع عليها نقطة Prometheus لـ Ollama: يبقى هذا الأمر غير متحقق منه، ويجب فحصه في ملاحظات الإصدار. عمليًا تُستخدم الواجهة (مجسّ توافر، وأزمنة تُعاد في الردود)، وسجلات الخدمة، والتتبعات من جهة التطبيق. ويمكن لـ OpenTelemetry Collector بعد ذلك توجيه هذه الإشارات إلى Dynatrace أو إلى أي backend آخر، كما في OpenTelemetry من البداية إلى النهاية. وللمتابعة على مستوى كل استدعاء، يكون القياس من جهة العميل غالبًا الحل الأكثر انسجامًا بين المحركات الثلاثة: فهو ينتج spans بالشكل نفسه أيًّا كان الخادم خلف واجهة متوافقة مع OpenAI.
أفضل الممارسات
- اختر بحسب الحركة المتوقعة والعتاد المتاح، لا بحسب ترتيب عام.
- أبقِ منفذ الاستماع المحلي الافتراضي، وضع أمام الخدمة وكيلًا عكسيًا مع التحكم في الوصول.
- فعّل
--metricsفي llama-server من البداية؛ فالمقياس الغائب لا يُستدرك بعد وقوع حادثة. - حدّد SLO لزمن الاستجابة ونبّه على طابور الانتظار قبل التشبّع.
- قِس بنماذجك وطلباتك قبل أن تحسم.
- تجنّب حفظ الـ prompts كاملة في التتبعات إذا كانت تحتوي على بيانات شخصية.
الأسئلة الشائعة
ما الفرق بين Ollama وllama.cpp؟
llama.cpp هو محرك الاستدلال وخادمه؛ أما Ollama فيضيف طبقة لإدارة النماذج وواجهة بسيطة. الأول يمنح تحكمًا أكبر، والثاني راحة أكبر.
هل يعمل vLLM بدون GPU؟
تذكر وثائقه معالجات x86 وARM وPowerPC إضافة إلى وحدات GPU من NVIDIA وAMD. ويُتحقق من الأداء ومن دعم نموذج معيّن إصدارًا بعد إصدار.
أي محرك هو الأسهل مراقبةً؟
بحسب الصفحات المقروءة، يعرض vLLM وllama.cpp نقطة Prometheus؛ أما مع Ollama فتمر المراقبة أساسًا عبر الواجهة والسجلات والتتبعات من جهة العميل.
الخلاصة
يناسب Ollama الاستخدامات البسيطة المشتركة على نطاق صغير، ويناسب vLLM الإنتاجية على GPU، ويناسب llama.cpp تنوّع العتاد والتحكم الدقيق. وفي كل الحالات، تجعل مؤشرات SLI للزمن وطابور الانتظار والتوافر، المغذّاة عبر Prometheus أو OpenTelemetry، الاختيار قابلًا للتراجع. ولوضع هذه المحركات في بنية متكاملة، راجع مقارنة حزم الذكاء الاصطناعي مفتوحة المصدر المستضافة ذاتيًا. المراجع: وثائق vLLM، ومستودع llama.cpp، ومستودع Ollama.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لمشاريع Ollama وvLLM وllama.cpp. Dynatrace علامة تجارية لشركة Dynatrace LLC؛ والعلامات الأخرى المذكورة تعود إلى مالكيها. تحقق دائمًا من الخيارات في الوثائق الرسمية الخاصة بإصدارك.