El panel está en verde, nadie ha visto una excepción y, aun así, el flujo de agentes tarda 45 segundos en contestar. ¿Por dónde se empieza? De esa pregunta de guardia parte AgentOps Center, un repositorio de GitHub pequeño, nacido en un hackathon alrededor de SigNoz. Lo he leído archivo por archivo sin desplegarlo, así que separo tres cosas: lo que hace el código, lo que afirma el README y lo que no he podido comprobar.
Su valor está menos en el producto que en el patrón. Enseña cómo nombrar spans en un sistema con varios agentes, adónde mandarlos y cómo hacer que un asistente responda con datos reales. Iremos por esas tres decisiones y cerraremos con los límites.
Un apunte de método: el último commit que leí es del 26 de julio de 2026. No cito número de estrellas porque no lo leí en la fuente. El README habla de licencia MIT, pero no encontré ningún archivo LICENSE en el árbol: confírmalo antes de reutilizar nada.
Qué aporta AgentOps Center a quien opera agentes
Un APM clásico cuenta peticiones y errores HTTP. Un flujo de agentes se estropea de otra manera: da vueltas, repite una herramienta, espera a un proveedor de modelos que aplica límite de tasa. No se rompe nada, todo se vuelve lento y el gasto en tokens sube sin avisar.
El README enumera lo que el equipo de operaciones quiere saber: qué nodo entró en bucle, qué herramienta devolvió un límite de tasa, cuánto costó cada subagente. Para contestarlo hacen falta spans por agente, por llamada al modelo y por herramienta, unidos en una sola traza. Eso es justo lo que construye el código.
Decisión 1: cómo nombrar los spans de varios agentes
El archivo backend/instrumentation/agent_spans.py declara constantes de atributos. Toma las claves gen_ai.* para las llamadas al modelo y añade claves propias para agentes y herramientas.
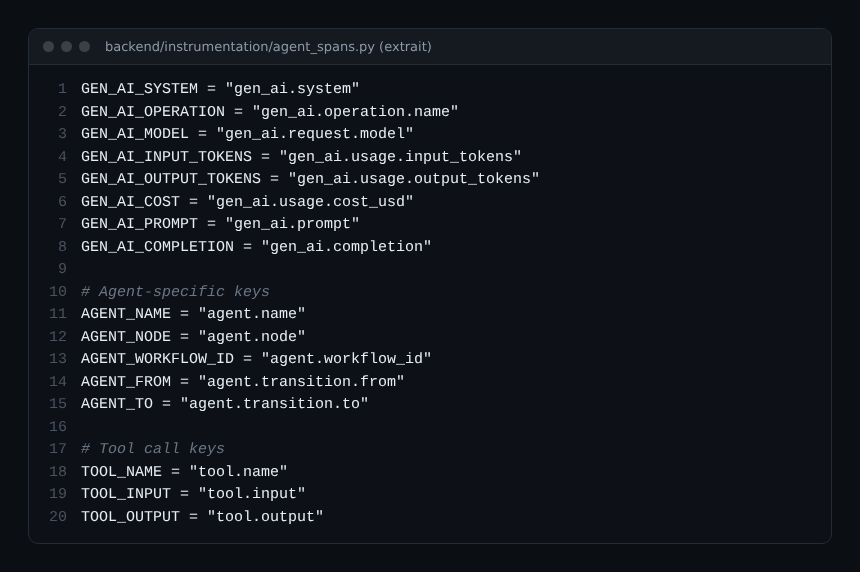
La mezcla tiene sentido: la parte estándar permite comparar modelos y proveedores; la parte propia lleva la lógica de negocio (qué agente, qué flujo). Con un identificador de flujo en cada span se agrupa todo, aunque los spans vengan de bibliotecas distintas. Si quieres repasar qué contiene un span, lee la anatomía de un span de OpenTelemetry.
Dos advertencias:
- Las convenciones GenAI de OpenTelemetry cambian deprisa. La página de la especificación remite ahora a un repositorio aparte que no pude leer (error del servidor cuando lo intenté). Es posible que
gen_ai.systemhaya sido sustituido por un atributo de proveedor más reciente: sin verificar. gen_ai.usage.cost_usdes una invención del proyecto, no una clave estándar que yo conozca. Los paneles que dependan de ella serán solo tuyos.
Otro detalle: gen_ai.prompt y gen_ai.completion se recortan a 500 caracteres en el código. Meter prompts enteros en los spans sale caro y expone datos; recortar es un compromiso razonable, pero define tu política antes de producción. Sobre este asunto, mira también los atributos de OpenTelemetry en Dynatrace.
Decisión 2: hacia dónde viaja la telemetría
En setup.py se inicializan un proveedor de trazas y otro de métricas con exportación OTLP gRPC a localhost:4317, valor que cambia OTEL_EXPORTER_OTLP_ENDPOINT. Se activa la instrumentación de FastAPI y httpx, y la de LangChain mediante OpenInference, que según un comentario cubre también LangGraph. El muestreo está al 100 %, algo que el propio código presenta como ajuste de demostración.
El Collector del repositorio recibe OTLP y escribe directamente en ClickHouse con los exportadores de SigNoz, un pipeline por señal.
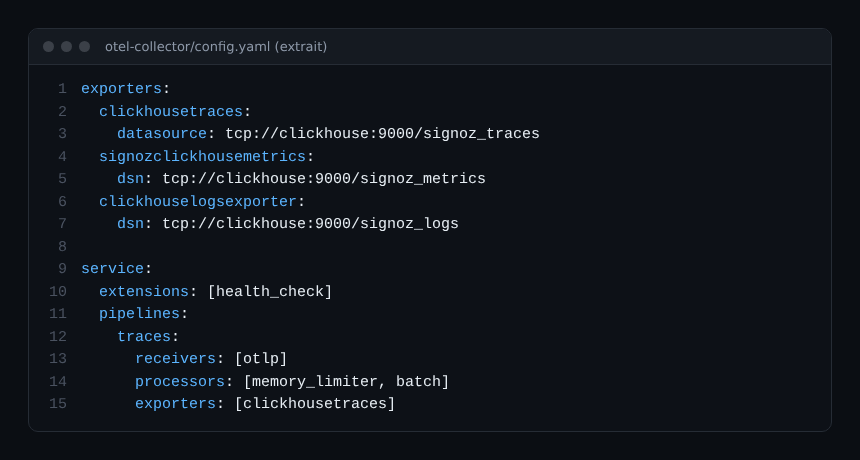
Este esquema es el de SigNoz autoalojado. Si tu backend es otro (Dynatrace, por ejemplo), solo cambia el exportador; el protocolo OTLP y los atributos se quedan. Nuestra guía del Collector de OpenTelemetry hacia Dynatrace muestra esa variante; yo no he probado este repositorio con Dynatrace.
Para operaciones, la configuración incluye memory_limiter y lotes de 10 000 elementos cada 10 segundos. Buen reflejo: un sistema de agentes puede generar miles de spans por ejecución, y el README menciona entre 2 340 y 3 559 por run en sus pruebas de humo.
Decisión 3: un asistente que diagnostica, pero con pruebas
Es la idea más interesante. El «Root Cause Copilot» no le pregunta a un modelo en el vacío. Un motor de evidencias consulta primero el servidor MCP de SigNoz para traer trazas, logs de error, métricas y alertas, arma un contexto etiquetado con la herramienta de origen y después puntúa la confianza.
La documentación de SigNoz confirma que ese servidor MCP expone, entre otras, signoz_search_traces, signoz_search_logs, signoz_query_metrics y signoz_list_alert_rules. El modo HTTP se activa con TRANSPORT_MODE=http y el endpoint es /mcp. Para el marco general del protocolo, lee observar agentes MCP con OpenTelemetry.
La puntuación está en reasoning.py:
- servidor MCP inalcanzable: confianza LOW, solo con el contexto local en memoria;
- trazas más otra señal (logs, métricas o alertas): HIGH;
- una sola señal: MEDIUM;
- ningún dato aprovechable: NONE.
Lectura crítica: es una heurística sobre la cantidad de señales, no una medida de acierto. Una condición del código llega a dar HIGH siempre que el servidor MCP responda con al menos dos señales, sean las que sean. La insignia dice «encontré con qué respaldar mi respuesta», no «mi respuesta es correcta».
Probar la observabilidad con fallos inyectados
El motor de caos (chaos/injector.py) sortea fallos según una intensidad entre 0 y 1: tiempo de espera agotado, error 429 o 500, fallo de herramienta, lentitud de 2 a 8 segundos, caída de agente y salida corrupta. El README menciona cinco; el código tiene seis, contando la salida inválida. Cada fallo crea un span de error con chaos.mode y chaos.injected.
Para un SRE la utilidad es comprobar que alertas y paneles ven la degradación antes de que llegue de verdad. Y la marca chaos.injected evita confundir un simulacro con un incidente. Sobre las protecciones relacionadas, lee las barreras de seguridad para agentes de IA en producción.
Lo real y lo escrito a mano
Aquí está el límite principal: los «incidentes» del flujo son de guion. En graph.py, según ciertas palabras del texto del escenario, el código emite spans de Redis, SQL y API de terceros con valores fijos: 48 conexiones de 50, un estado 429 en un servicio de pagos, esperas simuladas con asyncio.sleep.
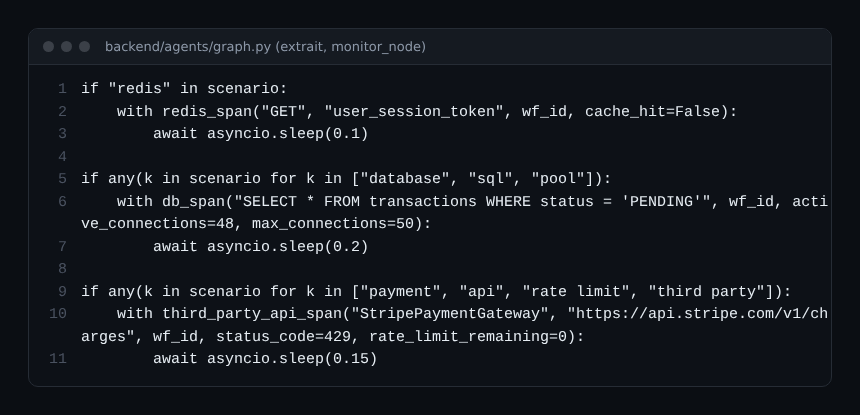
Para una demo no es un defecto, pero cambia cómo leer las capturas del README: demuestran que la cadena de telemetría funciona, no que la herramienta detecte averías reales. La tarifa de los modelos también es una tabla escrita en el código (cuatro modelos y un precio por defecto para el resto). Para un seguimiento de costes serio, mira el coste de un agente de IA por tokens con OpenTelemetry.
El propio README reconoce otras carencias en su lista de mejoras: sin autenticación ni multiinquilino, sin alertas integradas, sin retención larga. No reutilizo sus capturas aquí, porque falta el archivo de licencia.
Llevar el patrón a tu proyecto
- Fija tus claves de atributos: identificador de flujo, nombre de agente, nombre de herramienta y
gen_ai.*para los modelos. - Envuelve cada llamada al modelo y cada herramienta en un span, con estado de error y excepción registrada.
- Manda todo por OTLP a un Collector con
memory_limitery lotes. - Para probarlo en local, el README indica copiar
.env.example, poner una clave de Groq o de OpenAI y ejecutardocker compose up -d(anuncia nueve contenedores). - Comprueba que responden
localhost:3000(interfaz),8000(API) y8080(SigNoz), según el README.
Para ver cómo se traza un grafo de agentes desde el código, nuestro artículo sobre el trazado de LangChain y LangGraph explica la instrumentación.
Buenas prácticas
- Un identificador de flujo en cada span, también en los logs.
- Claves estándar para lo que se compara y claves propias, documentadas, para el resto.
- Muestrea en producción: el 100 % vale para una demo, no para una flota de agentes.
- Nunca pongas prompts completos ni secretos en los atributos.
- Marca los fallos inyectados para distinguirlos de los incidentes reales.
Preguntas frecuentes
¿Funciona AgentOps Center con Dynatrace?
Está escrito para SigNoz: el Collector exporta a ClickHouse y el copiloto consulta el servidor MCP de SigNoz. Los spans son OpenTelemetry estándar y podrían ir a otro destino, pero no he probado ese camino.
¿La insignia de confianza garantiza un buen diagnóstico?
No. Mide cuánta telemetría se encontró, no si la conclusión es correcta. Relee siempre las trazas citadas.
¿Está listo para producción?
El README lo presenta como demostración de hackathon y él mismo deja autenticación, alertas y retención para más adelante. Úsalo como fuente de ideas.
Conclusión
AgentOps Center responde a una duda real de operaciones con un patrón claro: spans bien nombrados, un pipeline OTLP y un asistente obligado a citar sus fuentes. Sus incidentes son de guion y el código es de hackathon, pero la arquitectura se lee en una hora y se traslada bien. Quédate con las ideas, no con el código tal cual.
span.observer es un blog independiente de la comunidad, no afiliado al proyecto AgentOps Center, a sus autores, a SigNoz ni a Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios. Las herramientas cambian rápido: comprueba los comandos y las opciones en su documentación oficial.