ai-memory memoria para agentes de código, escrita en Rust: este proyecto de código abierto da a tus agentes (Claude Code, Codex, Cursor, Gemini CLI, OpenCode y más de veinte arneses más) una memoria larga compartida, almacenada como páginas Markdown versionadas con Git. El repositorio akitaonrails/ai-memory muestra unas 12 600 estrellas a finales de octubre de 2026, con licencia MIT.
La idea del README: salir de Claude Code en plena tarea, abrir Codex en la misma carpeta y retomar sin volver a explicar la arquitectura, las pistas abandonadas y las preguntas abiertas. Este artículo presenta el proyecto, su instalación según el README, lo que muestra su interfaz web, sus límites (datos capturados, juventud) y la forma de supervisarlo con sus métricas de Prometheus. Aclaración de honestidad: span.observer no ha instalado ai-memory; los comandos proceden del README y las capturas proceden del repositorio.
ai-memory memoria para agentes de código: lo que dice el repositorio
- Quién: el repositorio pertenece a la cuenta
akitaonrails, con licencia MIT (copyright 2026 a nombre del mantenedor). Su sitio es aimemory.sh. - Cifras releídas el 22 de octubre de 2026: unas 12 600 estrellas, unos 889 forks, 4 344 commits; la versión 3.2.0 figura en el changelog con fecha del 21 de octubre de 2026; la cadena de herramientas requerida es Rust 1.95 o posterior.
- Arquitectura: un binario Rust autónomo que sirve MCP y HTTP y posee una carpeta de datos con un wiki Markdown versionado (fuente de verdad), un índice SQLite derivado (FTS5, entidades, embeddings opcionales) y registros.
- Ciclo: captura mediante hooks de ciclo de vida (prompts, llamadas a herramientas, límites de sesión), consolidación en páginas al final de la sesión, recuperación mediante búsqueda e inyección de un resumen, y después «handoff» al agente siguiente.
El proyecto insiste en un punto: la ruta por defecto no usa ninguna llamada a un LLM. La captura, la búsqueda y los handoffs funcionan sin clave de API, y las funciones que reescriben el contenido (compactación, deduplicación, «dream») son opcionales y están desactivadas por defecto. Para comparar con otros enfoques de memoria de agente, lee nuestro artículo sobre Hindsight; el propio README cita Hindsight en su tabla comparativa.
Recorrido por la interfaz web
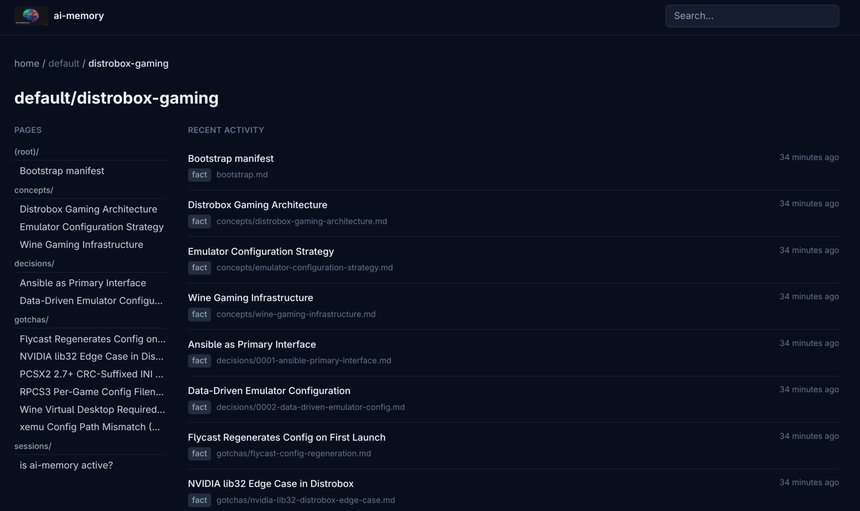
El servidor puede arrancar con --enable-web para ofrecer una vista del wiki en solo lectura en el navegador, un grafo de enlaces (/web/graph) y una API JSON bajo /api/v1. La captura siguiente, tomada del repositorio, muestra un proyecto con sus páginas clasificadas por carpeta (concepts/, decisions/, gotchas/, sessions/) y la actividad reciente.
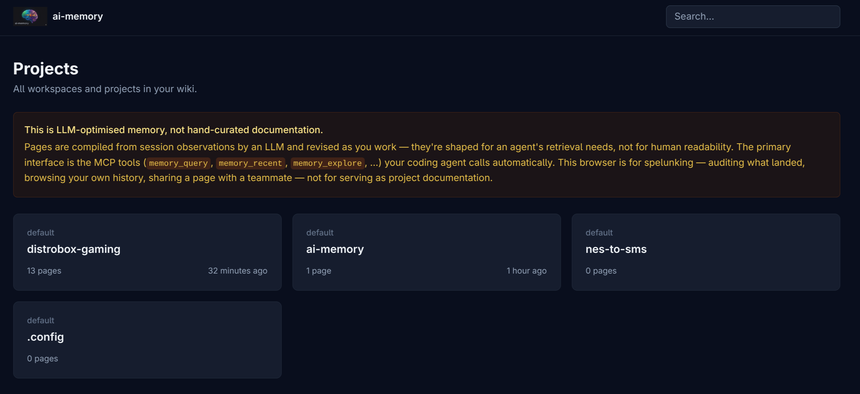
En la pantalla de inicio, un aviso del proyecto recuerda que estas páginas son «LLM-optimised memory, not hand-curated documentation»: compiladas para que un agente las recupere, no para la lectura humana. El navegador sirve para auditar lo que se ha registrado.
Instalación paso a paso
Paso 1 — Linux y macOS
El README propone dos comandos, sin permisos de root:
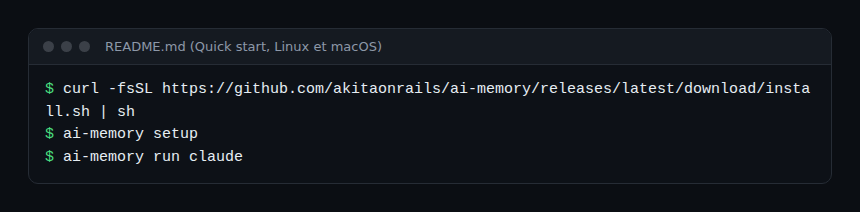
Según el README, install.sh descarga la versión para tu sistema, la compara con la suma SHA-256 publicada (y se niega a instalar si no coincide), y después crea un enlace en ~/.local/bin. ai-memory setup crea la carpeta de datos con un token en un archivo reservado al propietario, arranca un servicio de usuario (systemd o launchd) y configura MCP, hooks y skills para los agentes que encuentra, previa confirmación. La opción --plan muestra el plan sin modificar nada.
Paso 2 — Windows y otras plataformas
En Windows, el README da dos comandos de PowerShell (install.ps1 y luego ai-memory setup), y clasifica Windows nativo como «experimental»; Windows mediante WSL2 está «soportado». Existen paquetes para Arch (AUR), Fedora (RPM), NixOS, una aplicación de barra de menús de macOS y una imagen de Docker.
Paso 3 — Lanzar un agente
El README aconseja arrancar el agente con ai-memory run claude (o codex): el lanzador conecta hooks y MCP si faltan, y añade la continuidad de sesión entre arneses. Reinicia después tus agentes y pregúntales «What do you remember about this project?» para comprobarlo.
Límites y puntos abiertos
- Qué se captura: los hooks registran prompts y llamadas a herramientas, depurados por una frontera de confidencialidad antes de almacenarse. El archivo DATA_HANDLING.md precisa que no hay cifrado en reposo en la v1 y se apoya en los permisos del sistema de archivos. Unas reglas
[capture]por repositorio permiten excluir rutas. - Autenticación: el README señala que el arranque rápido con Docker no tiene ninguna autenticación (enlace solo al bucle local). Las instalaciones nativas con
ai-memory initreciben un token. Añade TLS mediante un proxy inverso en cuanto el servidor salga de la máquina. - Rutas externas opcionales: por defecto, todo es local, con embeddings locales. Un proveedor remoto de LLM o de embeddings envía contenido a ese proveedor si lo activas.
- Madurez: el proyecto publica versiones mayores muy seguidas, anuncia Windows nativo como experimental y declara, en sus agradecimientos, haber sido construido en colaboración con Claude Code. Lee el changelog antes de cada actualización.
- Memoria errónea: una memoria automática puede conservar una conclusión falsa. El README menciona «contradiction flagging», no una garantía de veracidad.
Cómo supervisar ai-memory
ai-memory es un servicio local de larga duración: se supervisa como tal. Según la documentación del repositorio, existen tres fuentes. El comando ai-memory status --json (equivalente a GET /admin/status, protegido) da el estado, incluida una telemetría de las llamadas a LLM por carga de trabajo cuando hay un proveedor configurado. El punto GET /admin/metrics expone en formato de texto de Prometheus contadores de hooks por resultado, las llamadas a herramientas MCP separadas en lectura y escritura, e histogramas de latencia de POST /hook y memory_query; las etiquetas proceden de un conjunto cerrado y no puede aparecer ningún texto de consulta, nombre de proyecto ni token. Por último, /web/health muestra la cola de escritura, el spool de hooks y la cola de consolidación.
El repositorio precisa que no existe exportador de OpenTelemetry: los contadores se reinician al reiniciar, y la exportación OTLP figura como «a medir primero». Para enviarlos a Dynatrace, se puede hacer que un OpenTelemetry Collector lea /admin/metrics con el receptor de Prometheus, como explica nuestro artículo sobre OpenTelemetry y Prometheus, respetando la autenticación del servidor. Esto vale para Dynatrace SaaS; en Dynatrace Managed, comprueba que se admite la ingesta de métricas OTLP.
Del lado del agente, el impacto en el coste (el resumen inyectado consume tokens) se mide con la telemetría del agente; consulta el coste de un agente de IA en tokens con OpenTelemetry y supervisar un agente de código en la empresa.
Cómo comprobar que funciona
ai-memory statusyai-memory doctorno señalan ninguna advertencia bloqueante.- Tras una sesión, aparece una página en el wiki (vista web o archivos Markdown).
- En un agente nuevo de la misma carpeta, la pregunta «where did we leave off?» retoma el handoff.
Buenas prácticas
- Empieza con un repositorio sin secretos, con las reglas de exclusión
[capture]ya definidas. - Mantén el servidor en el bucle local; si no, token, cuentas y TLS.
- Haz copia de seguridad de la carpeta de datos (el README describe una copia hacia un repositorio Git remoto) y relee las páginas registradas.
- Fija la versión y lee las notas de actualización antes de migrar.
Preguntas frecuentes
¿Necesita ai-memory un LLM o una clave de API?
No por defecto: captura, búsqueda y handoffs funcionan sin llamar a un LLM. Un proveedor solo sirve para mejorar los resúmenes y la búsqueda semántica, si lo configuras.
¿Salen los datos de mi máquina?
Según DATA_HANDLING.md, no por defecto: el proyecto dice que no envía telemetría. Algunas opciones (proveedor remoto de LLM o de embeddings, servidor compartido) envían contenido allí donde las apuntes.
¿Se puede compartir en un equipo?
Sí, según el README: un servidor común, con autenticación multiusuario, atribución y registro de auditoría. Los handoffs personales siguen siendo personales.
Conclusión
ai-memory propone una memoria para agentes de código transparente: archivos Markdown que son tuyos, un único binario Rust y un funcionamiento sin LLM por defecto. Captura mucho contenido: te toca decidir qué, dónde y con qué supervisión. Fuentes: repositorio akitaonrails/ai-memory.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba los comandos y las opciones en su documentación oficial.