DQL fieldsMove jsonExtract: estos dos comandos, anunciados en las notas de versión de SaaS del sprint 347 (16 de septiembre de 2026), sirven para ordenar logs en JSON. jsonExtract convierte las claves de un objeto JSON en campos. fieldsMove guarda campos de primer nivel en un registro anidado. Ninguno de los dos sobrescribe un campo existente.
El problema es habitual en operaciones. Llega un log de aplicación con un campo content que contiene JSON, y ese JSON trae una clave loglevel mientras el registro ya tiene un campo loglevel. Con un analizador ingenuo gana uno de los dos en silencio, y las consultas de alerta leen el valor equivocado. Aquí la colisión queda a la vista y usted decide dónde guardarla.
Este artículo sigue la referencia oficial de DQL (las páginas «DQL extraction and parsing commands» y «DQL selection and modification commands», leídas el 27 de octubre de 2026) y las notas del sprint 347. Vale para Dynatrace SaaS (Grail, DQL), no para Managed. Aclaración de honestidad: span.observer no ejecutó ninguna de estas consultas. Los ejemplos de la referencia se copian tal cual, y los resultados mostrados son los que indica la documentación.
DQL fieldsMove jsonExtract: lo que dicen las notas del sprint 347
- fieldsMove: mueve los campos de primer nivel que coinciden con un patrón
include(menos los que coinciden conexclude) a un campo nuevo con un registro anidado, y los quita del primer nivel. Es la contraparte defieldsFlatten. - jsonExtract: analiza una cadena JSON y coloca las claves de primer nivel del objeto en campos del registro. Las notas precisan que nunca sobrescribe un campo existente y que las claves en colisión pueden reunirse en un campo dedicado.
- Ambos comandos completan la familia de comandos
fields(fieldsKeep,fieldsRemove,fieldsRename). La misma versión añade funciones para manejar registros (recordField,recordFields,recordFromFields,recordKeys,recordValues), que este artículo no detalla.
Sintaxis de fieldsMove
La sintaxis de la referencia es:
fieldsMove fieldName [, include: {pattern [, ...]}] [, exclude: {pattern [, ...]}]Se exige al menos uno de los parámetros include o exclude. Esta regla evita mover todos los campos por descuido. El primer argumento es el nombre del campo nuevo que recibirá el registro.
Este es el primer ejemplo de la referencia: todos los campos cuyo nombre empieza por k8s. pasan a un campo k8s. Los campos event y status se quedan en la raíz.
data record(
  event = "failed to find product",
  status = "NONE",
  k8s.namespace.name = "unguard",
  k8s.pod.name = "unguard-user-simulator-28334535-tqqxt",
  k8s.pod.uid = "d3e93267-e7f9-4a2d-b5df-dc2ac226a7ce"
)
| fieldsMove k8s, include: {"k8s.*"}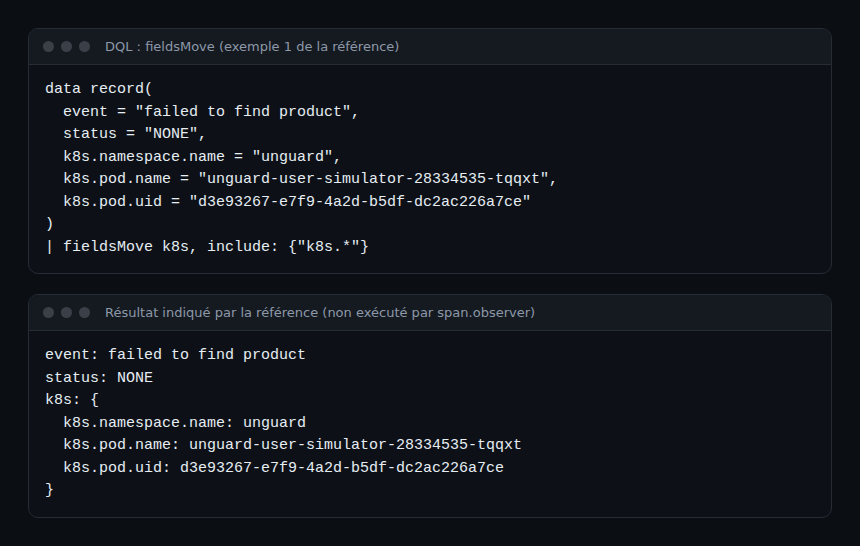
El segundo ejemplo de la referencia añade exclude: {k8s.namespace.name}: el campo k8s.namespace.name se queda en la raíz y los otros dos entran en k8s. Sirve cuando un campo actúa como filtro o dimensión en sus paneles y debe seguir a mano.
| fieldsMove k8s, include: {"k8s.*"}, exclude: {k8s.namespace.name}Sintaxis de jsonExtract
jsonExtract input [, conflicts]input(obligatorio): una expresión de tipo cadena que contiene el objeto JSON.conflicts(opcional): el nombre del campo donde guardar las claves en colisión. Sin este parámetro, las claves en colisión se descartan y no se crea ningún campo adicional.
Con conflicts, el campo contiene un registro vacío cuando no hay colisiones. Si el objeto JSON repite una clave, se conserva un solo valor, sin garantía de cuál.
Los tipos siguen el JSON: número a long o double, booleano a boolean, cadena a string, null a null, matriz a array, objeto a record.
Pasos prácticos: extraer JSON sin perder nada
Paso 1 — Ver la colisión de claves
El ejemplo de la referencia usa un registro que ya tiene loglevel = "WARN", mientras que el JSON de content contiene "loglevel":"ERROR":
data record(timestamp = now(),
            content = """{"loggerName":"Log4JGenerator", "threadId":33, "loglevel":"ERROR"}""",
            loglevel = "WARN",
            log.source = "/var/log/messages")
| jsonExtract content, conflicts: collisions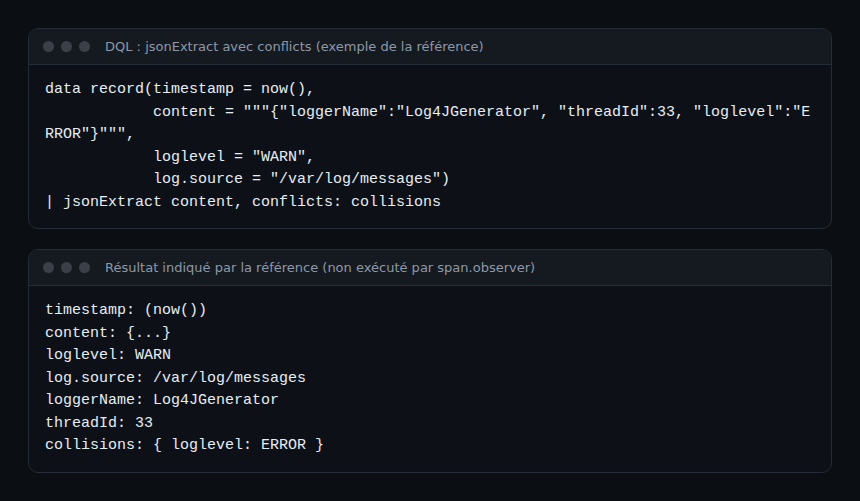
El resultado que describe la referencia: loglevel conserva el valor WARN, loggerName y threadId aparecen como campos, y collisions contiene loglevel: ERROR. El valor original queda intacto y el valor del JSON sigue consultable.
Paso 2 — Aplicar jsonExtract a logs reales
En Grail, todos los campos del flujo deben conocerse al planificar la consulta. Los logs no tienen esquema fijo, así que la referencia inserta fields antes de jsonExtract. Este es su ejemplo:
fetch logs
| filter startsWith(content, "{")
| fields timestamp, content
| jsonExtract content
El filtro conserva las líneas cuyo contenido empieza por una llave. fields enumera lo que se conserva y después jsonExtract añade las claves del JSON.
Paso 3 — Ordenar los campos de Kubernetes
Otro ejemplo de la referencia, sobre logs:
fetch logs
| fieldsMove k8s, include: {"k8s.*"}
El primer nivel queda legible y los atributos de Kubernetes acaban en un registro k8s.
Paso 4 — Encadenar los dos comandos
Ejemplo escrito para ilustrar, no ejecutado por span.observer. Combina los comandos anteriores; la sintaxis de cada comando viene de la referencia, el encadenamiento es nuestro y debe validarse en su entorno:
fetch logs
| filter startsWith(content, "{")
| fields timestamp, content, k8s.namespace.name, k8s.pod.name
| jsonExtract content, conflicts: collisions
| fieldsMove k8s, include: {"k8s.*"}
Después de fields, el flujo solo contiene los campos enumerados. Si una clave del JSON tiene el nombre de un campo conservado, el valor del JSON acaba en collisions.
Cómo comprobar que funciona
- Ejecute primero los ejemplos
data record(...): no dependen de datos de su entorno. Compare con los resultados de la referencia. - En logs, abra el campo
collisions: un registro vacío significa que no hubo colisión. - Compruebe los tipos: un número del JSON debe ser numérico, no una cadena.
- Relea la página de referencia de
jsonExtractantes de usarlo en una consulta de producción, porque la disponibilidad de un comando puede variar según el contexto (consulta DQL o procesador DQL de OpenPipeline).
Buenas prácticas
- Defina siempre un campo
conflictsmientras explora: una colisión ignorada es un dato perdido. - Filtre primero (
startsWith(content, "{")) para no analizar líneas que no son JSON. - Deje en la raíz los campos que usan sus filtros y sus SLO, con
exclude. - En términos de fiabilidad, una alerta que lee un
loglevelequivocado alarga el MTTR: trate las colisiones como una señal.
Para seguir, vea https://span.observer/es/dql-avanzado-lookup-join-parse/ (parse, lookup, join), https://span.observer/es/comandos-dql-filter-summarize-timeseries/ para los comandos básicos, https://span.observer/es/dql-smartscape-topologia/ para la topología y https://span.observer/es/patrones-de-logs-dql-es/ para el análisis de logs.
Enlaces internos: DQL avanzado, comandos DQL, DQL Smartscape, análisis de patrones en logs.
Preguntas frecuentes
¿jsonExtract sobrescribe un campo existente?
No. Según la referencia, los campos existentes nunca se eliminan ni se sobrescriben. Las claves en colisión se descartan o se guardan en el campo indicado por conflicts.
¿Se puede ejecutar fieldsMove sin include ni exclude?
No. Se exige al menos uno de los dos parámetros, para no mover todos los campos por error.
¿Qué relación tiene con fieldsFlatten?
fieldsMove reúne campos en un registro anidado; fieldsFlatten hace lo contrario y sube los campos anidados a la raíz, según la referencia.
Conclusión
fieldsMove y jsonExtract hacen más legibles los logs JSON sin perder datos. Pruebe primero los ejemplos data record y después adáptelos a sus logs.
Fuentes: notas de versión de SaaS del sprint 347 y referencia DQL, extracción y análisis.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las funciones de SaaS evolucionan rápido: compruebe su disponibilidad en su entorno y en la documentación oficial.