Un pico de errores en los logs y siempre la misma pregunta: ¿cuántos, de qué nivel y desde cuándo? Para los DQL errores de logs, el método tiene dos tiempos: primero una tabla por nivel con summarize y después una curva con makeTimeseries. Este artículo da las consultas, explica qué devuelve cada comando y cómo evitar las trampas.
Objetivo: detectar en pocos minutos si los errores suben, en qué momento y en qué nivel de gravedad, sin exportar los logs. Alcance: DQL consulta Grail, así que todo lo que sigue vale únicamente para Dynatrace SaaS. Dynatrace Managed no tiene Grail. Este artículo complementa nuestras 15 consultas DQL de operación centrándose en un solo caso de uso.
En resumen
summarizedevuelve una tabla: una fila por grupo, aquí porloglevel.makeTimeseriesdevuelve una serie temporal: una matriz de valores por intervalo de tiempo, lista para un gráfico.- Los dos comandos no se encadenan para el mismo resultado: se elige uno u otro según la pregunta.
- Para una serie sin huecos, se combinan
defaultynonempty.
Requisitos previos
- Un entorno Dynatrace SaaS con Grail y logs ingeridos (OneAgent, OpenTelemetry Collector o API).
- Permiso para leer los logs y abrir un Notebook o un Dashboard.
- Las bases de
fetchyfilter; si no, consulta los fundamentos de DQL.
El campo loglevel describe la gravedad del evento de log. La página del diccionario semántico de Dynatrace lo describe como «the log event severity level» y cita ERROR, INFO y TRACE como ejemplos; no da una lista cerrada. Antes de copiar una consulta, comprueba por tanto los valores presentes en tu entorno con la primera consulta de abajo.
DQL errores de logs: contar por nivel con summarize
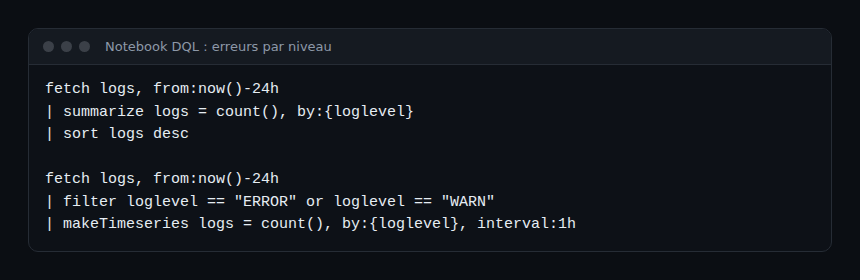
El comando fetch acepta los parámetros from y to como duraciones relativas. La documentación da el ejemplo fetch logs, from: -24h, to: -2h. Nuestra primera consulta lee las últimas 24 horas y cuenta los registros por nivel.
fetch logs, from:now()-24h
| summarize logs = count(), by:{loglevel}
| sort logs desc
La sintaxis de la documentación es summarize [field =] aggregation, ... [, by: {[field =] expression, ...}]. Aquí, count() «cuenta el número total de registros» de cada grupo. El resultado es una tabla con una fila por cada valor de loglevel.
Leer la tabla con método
- Localiza los niveles presentes: ERROR, WARN, INFO, pero también posibles valores vacíos o inesperados.
- Compara ERROR con el volumen total. Un volumen de errores que se duplica importa más que su valor absoluto.
- Comprueba el grupo
null. La documentación precisa que los registros que no tienen el campo delbyse agrupan bajonull. Unos logs sin nivel distorsionan la proporción de errores.
Si ningún registro coincide y no hay by, summarize devuelve igualmente una fila, con count() a 0. Un «0» puede significar por tanto «ningún log» tanto como «ningún error»: controla la ventana de tiempo.
Pasar a una curva con makeTimeseries
La tabla dice cuántos. No dice cuándo. makeTimeseries responde a esta segunda pregunta dividiendo el tiempo en intervalos.
fetch logs, from:now()-24h
| filter loglevel == "ERROR" or loglevel == "WARN"
| makeTimeseries logs = count(), by:{loglevel}, interval:1h
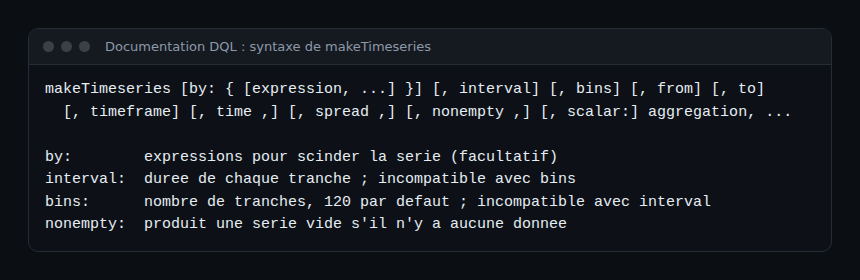
El parámetro by divide la serie: obtienes una curva por nivel. El parámetro interval fija la duración de cada intervalo. Para filtros más compactos, consulta la función in de DQL.
Qué devuelve el comando
Según la documentación, el resultado contiene un campo timeframe (inicio y fin), un campo interval (por ejemplo «1 min») y la columna de agregación. Esta columna es una matriz con un valor por intervalo, como [1, 2, 1] en el ejemplo oficial. Este formato difiere de una tabla de filas: es lo que permite mostrar directamente un gráfico.
Interval o bins
Dos parámetros regulan la finura. interval da la duración de un intervalo. bins da el número de intervalos, 120 por defecto. No se pueden usar juntos. La documentación indica también que el intervalo real se ajusta a un valor habitual, que la serie no puede superar los 1 500 elementos y que los intervalos se alinean a medianoche en la zona horaria solicitada: el periodo devuelto puede ser por tanto más amplio que el solicitado.
En la práctica, elige el intervalo según la pregunta. Un intervalo de 1 hora sobre 24 horas basta para detectar una deriva; para fechar un incidente al minuto, reduce la ventana en lugar del intervalo.
Rellenar los huecos: default y nonempty
Por defecto, un intervalo sin datos contiene null. El parámetro default de la agregación sustituye ese valor, por ejemplo por 0. El parámetro nonempty trata el otro caso: si no se procesa ningún registro, sin él el comando no devuelve nada. La documentación muestra count(default: 0) con interval: 30m y nonempty: true para obtener una serie de ceros.
fetch logs, from:now()-24h
| filter loglevel == "ERROR"
| makeTimeseries errors = count(default:0), interval:30m, nonempty:true
Este detalle importa en un gráfico de alerta: una curva que desaparece cuando todo va bien lleva a confusión, mientras que una línea en cero confirma que la recolección funciona.
Comparar varios niveles con countIf
Cuando se quieren varias curvas en una misma consulta, sin by, countIf(condition) «cuenta el número de registros que cumplen la condición».
fetch logs, from:now()-24h
| makeTimeseries
    errors = countIf(loglevel == "ERROR"),
    warnings = countIf(loglevel == "WARN"),
    interval:1h
Esta forma evita filtrar antes de la agregación. También da un denominador: añadiendo total = count(), puedes comparar los errores con el volumen global. No he verificado en la documentación ninguna operación aritmética entre series en este comando; calcula la proporción en el Notebook o el Dashboard.
Cómo comprobar que funciona
- Ejecuta
fetch logs, from:now()-1h | limit 5y comprueba queloglevelexiste en tus registros. - Ejecuta la consulta
summarizey compara la suma de las filas con el total esperado. - Ejecuta la consulta
makeTimeseriesy muéstrala como gráfico de líneas: el número de curvas debe corresponder a los niveles filtrados. - Reduce la ventana a un periodo en el que conozcas un incidente: la curva debe subir ahí.
Buenas prácticas
- Fija siempre
from: una consulta sin ventana explícita cuesta más lectura y enturbia la comparación. - Mantén un solo caso por consulta: tabla para el balance, serie para la cronología.
- Para vincular una curva a un SLO, parte de SLI definidos en DQL.
- Para un Dashboard completo, consulta los ejemplos de dashboards DQL.
- Si tus logs están en JSON, extrae primero los campos, como en este artículo sobre fieldsMove y jsonExtract.
- Del lado de OpenTelemetry, un log sin nivel cae en el grupo
null: verifica la severidad en la emisión, consulta los logs de OpenTelemetry en Dynatrace.
Preguntas frecuentes
¿Se puede encadenar summarize y después makeTimeseries?
No es el uso correcto. summarize produce una tabla agregada, mientras que makeTimeseries parte de los registros y de su marca de tiempo (campo timestamp por defecto) para construir la serie. Para obtener una curva, aplica directamente makeTimeseries después de filter.
¿Por qué mi curva contiene valores null?
Un intervalo sin registros se rellena con null por defecto. Usa count(default: 0) para obtener ceros y nonempty: true para conservar una serie incluso sin ningún registro.
¿Qué diferencia hay con el comando timeseries?
timeseries consulta métricas, makeTimeseries construye una serie a partir de registros como los logs. Para las métricas, consulta DQL timeseries y alertas. Los comandos básicos se recuerdan en filter, summarize y timeseries.
Conclusión
Una tabla por nivel para el balance, una serie por nivel para la cronología: dos consultas cortas bastan para calificar una subida de errores. Para un SRE, es una ganancia directa en el MTTR, porque el diagnóstico inicial deja de depender de una exportación. Para profundizar en la agrupación, lee DQL group by y summarize.
Fuentes
- DQL, comandos de agregación (summarize, makeTimeseries), documentación de Dynatrace
- DQL, comandos de fuente de datos (fetch), documentación de Dynatrace
- DQL, funciones de agregación (count, countIf), documentación de Dynatrace
- Diccionario semántico, modelo de log (loglevel), documentación de Dynatrace
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios; las consultas se dan con fines didácticos y deben adaptarse a tus datos. Comprueba siempre los valores en la documentación oficial correspondiente a tu versión.