La mayoría de las consultas que se escriben durante una guardia (on-call) se apoyan en cuatro bloques: filter, la función in(), summarize con su parámetro by y timeseries. Dominar estos comandos DQL ahorra minutos en cada incidente y, sobre todo, evita resultados erróneos que nadie nota: un limit colocado demasiado pronto, un grupo null olvidado, una unidad mal leída.
Este artículo no repite una colección de casos de uso, que ya existe en nuestras consultas DQL operativas. Adopta el ángulo opuesto: primero el comando, con 30 ejemplos breves y comentados que muestran su comportamiento exacto, sus parámetros y sus trampas.
Alcance: consultas DQL sobre Grail, así que todo lo que sigue se aplica a Dynatrace SaaS. Dynatrace Managed no tiene Grail ni DQL; sus equivalentes pasan por Data Explorer y el metric selector. Los nombres de los campos dependen del origen: ejecuta fetch logs | limit 5 antes de copiar una consulta.
Cómo encadena DQL los comandos
Una consulta DQL es un pipeline: cada comando recibe una tabla, la transforma y la pasa al siguiente con |.
Si lo básico (fetch, fields, sort) te resulta nuevo, empieza por el módulo de fundamentos de DQL.
filter: reducir pronto y con precisión (ejemplos 1 a 8)
// 1. Igualdad estricta: el valor es conocido
fetch logs | filter loglevel == "ERROR"

// 2. Varias condiciones y una ventana corta (mejor rendimiento)
fetch logs, from: -2h
| filter loglevel == "ERROR" and k8s.namespace.name == "checkout"

// 3. Valor parcialmente conocido: operador ~ con comodín
fetch logs | filter k8s.container.name ~ "core*"

// 4. Búsqueda de una frase en el contenido
fetch logs | filter matchesPhrase(content, "connection refused")

// 5. Subcadena sin distinguir mayúsculas
fetch logs | filter contains(content, "timeout", caseSensitive: false)

// 6. Excluir: filterOut conserva los registros cuya condición es null
fetch logs | filterOut loglevel == "DEBUG"

// 7. Problems activos, sin duplicados
fetch dt.davis.problems
| filter not(dt.davis.is_duplicate)
| filter event.status == "ACTIVE"
| fields display_id, event.name, event.category

// 8. Spans de servidor con errores HTTP 5xx
fetch spans
| filter span.kind == "server" and http.response.status_code >= 500
El punto más sutil es el ejemplo 6. filterOut x solo elimina los registros en los que x es true: los registros en los que x es null se quedan. filter not x elimina también los null. En logs sin loglevel, las dos consultas no devuelven por tanto el mismo número de filas.
in(): comprobar una lista de valores (ejemplos 9 a 12)
in(needle, haystack, …) devuelve un booleano. El haystack puede ser un array o una secuencia de valores.
// 9. Array literal entre llaves
fetch logs | filter in(loglevel, {"ERROR", "WARN"})

// 10. Varios valores pasados directamente
fetch logs | filter in(k8s.namespace.name, "checkout", "payment")

// 11. Excluir una lista
fetch logs | filter not in(k8s.namespace.name, {"kube-system", "monitoring"})

// 12. En timeseries, in() filtra por dimensiones
timeseries cpu = avg(dt.host.cpu.usage), by: { dt.entity.host },
  filter: in(dt.entity.host, "HOST-1", "HOST-2")
Prefiere in() a una cadena de or: la consulta se lee mejor y la lista es fácil de sustituir por una variable de dashboard.
summarize y by: agregar sin errores (ejemplos 13 a 21)
La sintaxis es summarize [field =] aggregation, … [, by: {[field =] expression, …}].
// 13. Contar todo: una sola fila de salida
fetch logs | summarize count()

// 14. Agrupar por una dimensión y nombrar el resultado
fetch logs | summarize c = count(), by: { loglevel } | sort c desc

// 15. Varias dimensiones, alias en el grupo
fetch logs, from: -1h
| summarize c = count(), by: { ns = k8s.namespace.name, loglevel }

// 16. Tasa de error en una sola pasada con countIf
fetch logs, from: -1h
| summarize total = count(), errors = countIf(loglevel == "ERROR"),
    by: { k8s.namespace.name }
| fieldsAdd error_pct = 100.0 * errors / total

// 17. Percentil de duración por endpoint (duration está en nanosegundos)
fetch spans
| filter span.kind == "server"
| summarize p95 = percentile(duration, 95), by: { endpoint.name }

// 18. Número exacto de orígenes de log distintos
fetch logs | summarize sources = countDistinctExact(log.source)

// 19. Lista de valores distintos por grupo
fetch logs | summarize sources = collectDistinct(log.source), by: { k8s.namespace.name }

// 20. Muestreo: 1 registro de cada 100, y luego corrección
fetch spans, samplingRatio: 100
| summarize c = count(), by: { span.kind }
| fieldsAdd c = c * 100

// 21. Problems por categoría
fetch dt.davis.problems
| filter not(dt.davis.is_duplicate)
| summarize problems = count(), by: { event.category }
Dos comportamientos que conviene recordar. Si un campo de by no existe en algunos registros, summarize crea un grupo null: no lo descartes sin entender de dónde viene, suele ser un origen mal enriquecido. Y sin by, summarize devuelve siempre una fila, incluso con cero registros: count() vale entonces 0 y las demás agregaciones, null.
timeseries y makeTimeseries: las gráficas (ejemplos 22 a 30)
timeseries es un comando de inicio: carga, filtra y agrega métricas en un solo paso. Todas las series devueltas comparten el mismo inicio, el mismo final y el mismo intervalo.
// 22. CPU media por host
timeseries usage = avg(dt.host.cpu.usage), by: { dt.entity.host }

// 23. Una semana, pasos de una hora
timeseries max(dt.host.cpu.usage), by: { dt.entity.host }, interval: 1h, from: -7d

// 24. Rellenar huecos con un valor por defecto
timeseries mem = avg(dt.host.memory.usage, default: 0), by: { dt.entity.host }

// 25. Tiempo de respuesta p99 (en microsegundos) por servicio
timeseries p99 = percentile(dt.service.request.response_time, 99),
  by: { dt.entity.service }

// 26. Tasa de fallos: operaciones elemento a elemento con []
timeseries total = sum(dt.service.request.count),
  failed = sum(dt.service.request.failure_count),
  by: { dt.entity.service }
| fieldsAdd failure_pct = failed[] / total[] * 100

// 27. Top 10 de hosts por CPU media en el periodo
timeseries cpu = avg(dt.host.cpu.usage), by: { dt.entity.host }
| fieldsAdd avg_cpu = arrayAvg(cpu)
| sort avg_cpu desc
| limit 10

// 28. Mismo periodo una semana antes
timeseries cpu_last_week = avg(dt.host.cpu.usage), shift: -7d

// 29. Agregar todas las series en una sola línea
timeseries usage = avg(dt.host.cpu.usage), by: { dt.entity.host }
| summarize usage = avg(usage[]), by: { timeframe, interval }

// 30. Gráfica a partir de logs (datos que no son métricas)
fetch logs
| filter loglevel == "ERROR"
| makeTimeseries errors = count(), by: { k8s.namespace.name }, interval: 5m
Tres trampas habituales. percentile sin rollup solo funciona con dt.service.request.response_time y dt.service.request.service_mesh.response_time; para otras métricas, añade rollup: avg. La estimación del percentil tiene una precisión de aproximadamente el 2,2 %. Por último, interval y bins son mutuamente excluyentes: elige uno. Para crear alertas sobre estas gráficas, consulta el módulo de timeseries y alertas.
Buenas prácticas con los comandos DQL
Buenas prácticas
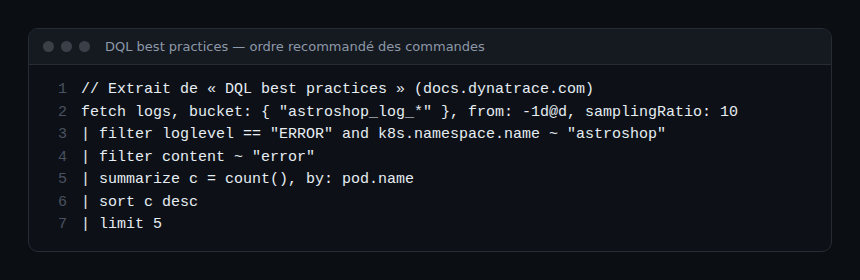
- Filtra primero, selecciona los campos después y agrega al final;
sortal final de la consulta. - Nunca pongas
limitantes desummarizesalvo que sea intencionado: el agregado se calcularía sobre una muestra arbitraria. - Filtra sobre el campo en bruto:
k8s.namespace.name ~ "astro*"en lugar dematchesValue(lower(…)). ==cuando el valor es conocido,~solo cuando es parcialmente conocido; filtros inclusivos en lugar de negaciones.- Reduce la ventana (
from: -2h) y el volumen (bucket,samplingRatio,scanLimitGBytes). - Lee la unidad:
durationde un span en nanosegundos,dt.service.request.response_timeen microsegundos.
Estas reglas importan para la fiabilidad: una consulta de SLI lenta o errónea da un presupuesto de error equivocado. Cuando las consultas sean estables, llévalas a un dashboard de Dynatrace SaaS; para lookup, join y parse, consulta DQL avanzado.
Cómo comprobar tus consultas
- Ejecuta la consulta en un Notebook con una ventana corta y compara
count()antes y después de cadafilter. - En
summarize, busca en el resultado un gruponullinesperado. - En
timeseries, comprueba las columnastimeframeeintervaldevueltas: te indican qué paso se aplicó realmente.
Preguntas frecuentes
¿Cuál es la diferencia entre summarize y makeTimeseries?
summarize produce una tabla (una fila por grupo). makeTimeseries produce series temporales a partir de datos que no son métricas, como logs o eventos. Para las métricas, usa timeseries directamente.
¿Por qué mi consulta timeseries no devuelve nada cuando espero un 0?
Por defecto, nonempty es false: sin datos, no se devuelve ninguna fila. Combina nonempty: true y default: 0 para obtener una serie de ceros.
¿Funcionan estas consultas en Dynatrace Managed?
No. DQL y Grail son específicos de Dynatrace SaaS. En Managed, usa Data Explorer y el metric selector, con claves builtin:.
Conclusión
Cuatro comandos DQL cubren la mayoría de los diagnósticos: filter para reducir, in() para apuntar a una lista, summarize para contar y clasificar, timeseries para ver la tendencia. Guarda estos 30 ejemplos en un Notebook de equipo y sigue el orden filtrar, seleccionar, agregar, ordenar. La referencia completa está en la documentación de los comandos DQL y en la página de buenas prácticas de DQL.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Los ejemplos se ofrecen solo a título orientativo: pruébalos en tu propio entorno antes de usarlos en producción.