Curso: Métricas de Dynatrace SaaS · Módulo 6/7 — métricas cloud de Grail (AWS, Azure, VMware) y extensiones · Formato: fichas de referencia · Plataforma: Dynatrace SaaS (Grail, DQL)
En este módulo:
- Una tabla resumen de 21 métricas
dt.cloud.*y de métricas de extensiones. - Una ficha por métrica: qué mide, cuándo usarla, la trampa que evitar y una consulta
timeseries. - Las tres reglas de nombres que permiten encontrar una métrica de extensión en Grail.
Este sexto módulo del curso de métricas de Dynatrace SaaS reúne las métricas cloud de Grail: las que Dynatrace recoge de AWS, Azure y VMware, y después las que aportan las extensiones. Son las métricas que se abren cuando una función Lambda empieza a fallar, cuando una base de datos gestionada se satura o cuando un servicio PaaS responde despacio sin que haya ningún OneAgent en él. Cada ficha da la clave exacta, su unidad y una consulta DQL lista para adaptar.
Todo este módulo se refiere a Dynatrace SaaS con Grail y DQL. En Dynatrace Managed, las mismas señales llevan claves clásicas builtin:cloud.* que se consultan con el metric selector: se tratan en el módulo de métricas cloud de Managed.
Las fichas van directas a la clave. Para el modelo de datos (claves, dimensiones, correspondencia con las claves clásicas), repasa el módulo Métricas de Grail del curso.
Las métricas cloud de Grail en una tabla
Las claves dt.cloud.* siguientes figuran en la tabla de correspondencia de la página Built-in Metrics on Grail. La regla es sencilla: se sustituye builtin:cloud. por dt.cloud. y el camelCase pasa a snake_case (errorsRate pasa a errors_rate). Las unidades son las del equivalente clásico, documentadas en las páginas de cada servicio. La dimensión principal es la que señala la documentación del servicio; en Grail, abre el navegador de métricas para ver el nombre exacto de las dimensiones antes de añadir un by:.
| Clave de Grail | Unidad | Dimensión principal (doc) | Qué mide |
|---|---|---|---|
dt.cloud.aws.lambda.invocations |
número | FunctionName | Invocaciones de una función Lambda |
dt.cloud.aws.lambda.duration |
milisegundo | FunctionName | Tiempo de ejecución del código |
dt.cloud.aws.lambda.errors_rate |
% | FunctionName | Parte de las invocaciones fallidas |
dt.cloud.aws.lambda.throttlers |
número | FunctionName | Invocaciones limitadas (throttling) |
dt.cloud.aws.lambda.conc_executions |
número | FunctionName | Ejecuciones simultáneas |
dt.cloud.aws.ec2.cpu.usage |
% | InstanceId | CPU de una instancia EC2 |
dt.cloud.aws.rds.cpu.usage |
% | DBInstanceIdentifier | CPU de una instancia RDS |
dt.cloud.aws.rds.connections |
número | DBInstanceIdentifier | Conexiones a la base de datos |
dt.cloud.aws.rds.latency.read |
segundo | DBInstanceIdentifier | Latencia de lectura |
dt.cloud.aws.rds.free |
% | DBInstanceIdentifier | Espacio de almacenamiento libre |
dt.cloud.aws.alb.errors.target.http5xx |
número | LoadBalancer | Errores 5xx devueltos por los destinos |
dt.cloud.aws.alb.resp_time |
segundo | LoadBalancer | Tiempo de respuesta de los destinos |
dt.cloud.azure.app_service.response.avg |
segundo | aplicación App Service | Tiempo de respuesta medio |
dt.cloud.azure.app_service.http.status.http5xx |
número | aplicación App Service | Respuestas HTTP 5xx |
dt.cloud.azure.sql_database.dtu.consumption_perc |
% | base de datos SQL | Consumo de DTU |
dt.cloud.azure.sql_database.deadlocks |
número | base de datos SQL | Interbloqueos |
dt.cloud.azure.redis.cache.misses |
número | caché Redis | Lecturas ausentes de la caché |
dt.cloud.azure.redis.load |
% | caché Redis | Carga del servidor Redis |
dt.cloud.vmware.vm.cpu.ready_perc |
% | máquina virtual | Tiempo de espera de una CPU física |
cloud.aws.dx.connection_error_count |
según la extensión | según la extensión | Ejemplo de métrica de extensión ext: renombrada |
cloud.gcp.cloudfunctions_googleapis_com.function.active_instances |
según la extensión | según la extensión | Ejemplo de métrica de Google Cloud sin prefijo común |
AWS Lambda
Las funciones Lambda no tienen un host que monitorizar: las métricas de CloudWatch recogidas por la integración con AWS suelen ser la única señal disponible. La documentación señala FunctionName como dimensión principal.
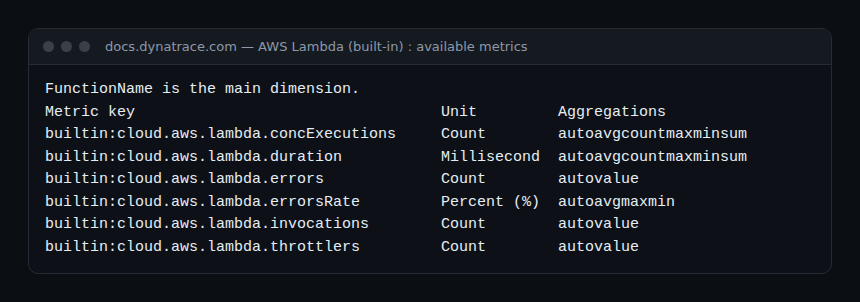
dt.cloud.aws.lambda.invocations
Número de llamadas a una función. Es el tráfico de la señal de oro: una caída brusca suele señalar una fuente de eventos rota (cola vacía, disparador desactivado) más que una función caída. Úsala también como denominador de tus propios ratios.
timeseries inv = sum(dt.cloud.aws.lambda.invocations)dt.cloud.aws.lambda.duration
Tiempo de ejecución del código, en milisegundos. Compara el máximo con el tiempo de espera configurado: una función que se acerca a él acabará expirando bajo carga. Trampa: la media oculta los arranques en frío, mira también el máximo.
timeseries {
    moy = avg(dt.cloud.aws.lambda.duration),
    pic = max(dt.cloud.aws.lambda.duration)
  }
dt.cloud.aws.lambda.errors_rate
Parte de las invocaciones fallidas, en porcentaje. Es el candidato natural para un SLI de disponibilidad de una función. Trampa: la clave vecina dt.cloud.aws.lambda.errors es un contador absoluto; no compares un contador entre dos funciones con tráfico muy distinto.
timeseries taux = avg(dt.cloud.aws.lambda.errors_rate)dt.cloud.aws.lambda.throttlers
Invocaciones rechazadas por AWS por falta de concurrencia disponible. Cualquier valor distinto de cero y sostenido merece una alerta: las llamadas síncronas se pierden para quien llama y las asíncronas se retrasan.
timeseries bridees = sum(dt.cloud.aws.lambda.throttlers)dt.cloud.aws.lambda.conc_executions
Número de ejecuciones simultáneas. Relacionado con el límite de concurrencia de la cuenta o de la función, anticipa el throttling. Agrega con max: la media en un intervalo suaviza los picos que provocan precisamente el throttling.
timeseries conc = max(dt.cloud.aws.lambda.conc_executions)EC2, RDS y balanceadores de carga de AWS
dt.cloud.aws.ec2.cpu.usage
CPU de una instancia EC2 vista por CloudWatch, en porcentaje. Útil para las instancias sin OneAgent. Si OneAgent está instalado, prefiere dt.host.cpu.usage (véase el módulo 2: métricas de host en Grail), más fino y con más dimensiones.
timeseries cpu = avg(dt.cloud.aws.ec2.cpu.usage)dt.cloud.aws.rds.cpu.usage
CPU de una instancia RDS. Una base de datos saturada en CPU ralentiza todos los servicios que la llaman: cruza esta curva con el tiempo de respuesta del lado del servicio antes de buscar el problema en el código.
timeseries cpu = avg(dt.cloud.aws.rds.cpu.usage)dt.cloud.aws.rds.connections
Número de conexiones abiertas en la base de datos. Una subida continua sin subida del tráfico suele delatar una fuga de conexiones en un pool de la aplicación. Compárala con el límite de conexiones de tu clase de instancia.
timeseries cnx = max(dt.cloud.aws.rds.connections)dt.cloud.aws.rds.latency.read
Latencia media de las lecturas de disco de la base de datos. Trampa: la unidad es el segundo, no el milisegundo; un valor de 0,02 ya representa 20 ms. Convierte antes de mostrar o de fijar un umbral.
timeseries lat = avg(dt.cloud.aws.rds.latency.read)
| fieldsAdd lat_ms = lat[] * 1000
dt.cloud.aws.rds.free
Espacio de almacenamiento libre, en porcentaje. Un disco lleno detiene las escrituras: es el tipo de incidente largo de resolver una vez producido. Sigue la tendencia más que el valor instantáneo.
timeseries libre = min(dt.cloud.aws.rds.free)dt.cloud.aws.alb.errors.target.http5xx
Número de respuestas 5xx producidas por los destinos detrás de un Application Load Balancer. Hay que distinguirla de dt.cloud.aws.alb.errors.alb.http5xx, que cuenta las 5xx generadas por el propio balanceador (destino inalcanzable, por ejemplo): ambas no se corrigen en el mismo sitio.
timeseries {
    cibles = sum(dt.cloud.aws.alb.errors.target.http5xx),
    alb = sum(dt.cloud.aws.alb.errors.alb.http5xx)
  }
dt.cloud.aws.alb.resp_time
Tiempo de respuesta de los destinos medido por el ALB, en segundos. Da una latencia vista desde la entrada del sistema, útil cuando los destinos no están instrumentados.
timeseries rt = avg(dt.cloud.aws.alb.resp_time)Azure y VMware
dt.cloud.azure.app_service.response.avg
Tiempo de respuesta medio de una aplicación App Service, en segundos. Buen indicador de primer nivel para una Web App sin OneAgent; para los percentiles hacen falta trazas.
timeseries rt = avg(dt.cloud.azure.app_service.response.avg)dt.cloud.azure.app_service.http.status.http5xx
Número de respuestas HTTP 5xx. Relaciónalo con dt.cloud.azure.app_service.traffic.requests para obtener una tasa de errores comparable entre aplicaciones.
timeseries {
    err = sum(dt.cloud.azure.app_service.http.status.http5xx),
    req = sum(dt.cloud.azure.app_service.traffic.requests)
  }
| fieldsAdd taux = 100 * err[] / req[]
dt.cloud.azure.sql_database.dtu.consumption_perc
Consumo de DTU (unidades de capacidad del modelo de compra DTU) de una base de datos Azure SQL, en porcentaje. Una base que se mantiene cerca del 100 % está limitada por Azure: las consultas se alargan sin ningún error visible. No se aplica a las bases con modelo vCore.
timeseries dtu = max(dt.cloud.azure.sql_database.dtu.consumption_perc)dt.cloud.azure.sql_database.deadlocks
Número de interbloqueos. Una aparición repentina tras un despliegue apunta casi siempre a un cambio en el orden de acceso a las tablas: es una señal que conviene relacionar con los eventos de despliegue.
timeseries dl = sum(dt.cloud.azure.sql_database.deadlocks)dt.cloud.azure.redis.cache.misses
Lecturas que no encuentran la clave en la caché. Comparada con dt.cloud.azure.redis.cache.hits, da la tasa de aciertos de la caché; una caída de esta tasa traslada la carga a la base de datos.
timeseries {
    hits = sum(dt.cloud.azure.redis.cache.hits),
    miss = sum(dt.cloud.azure.redis.cache.misses)
  }
| fieldsAdd taux_succes = 100 * hits[] / (hits[] + miss[])
dt.cloud.azure.redis.load
Carga del servidor Redis, en porcentaje. Redis procesa los comandos en un hilo principal: una carga alta se traduce en latencia para todos los clientes, aunque la CPU global de la máquina parezca moderada.
timeseries charge = max(dt.cloud.azure.redis.load)dt.cloud.vmware.vm.cpu.ready_perc
Parte del tiempo durante la cual una máquina virtual espera una CPU física libre. Un valor alto señala un hipervisor sobrecargado: la VM se ralentiza aunque su propia CPU parezca disponible. El umbral aceptable depende de tu plataforma; habla con el equipo de virtualización.
timeseries ready = avg(dt.cloud.vmware.vm.cpu.ready_perc)Encontrar las métricas de extensiones en Grail
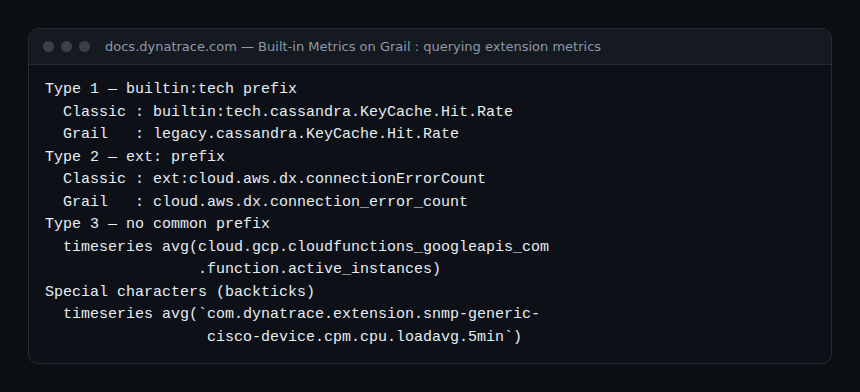
Las extensiones (Extensions 2.0, ActiveGate, antiguas extensiones 1.0) y los servicios cloud adicionales producen miles de claves: es imposible hacer una ficha de cada una. La documentación da tres reglas de nombres, resumidas en la captura siguiente.
- Prefijo
builtin:tech(extensiones 1.0): la clave pasa a serlegacy.*, por ejemplolegacy.cassandra.KeyCache.Hit.Rate. Excepciones: las métricasbuiltin:tech.genericybuiltin:tech.websphere, y las métricas de runtime como la JVM, que tienen sus claves de Grail (véase el módulo 5). - Prefijo
ext:: se elimina el prefijo y el camelCase pasa a snake_case, salvo en los nombres propios comoroute53resolver. - Sin prefijo común: la clave se consulta tal cual; si contiene un carácter especial (guion, segmento numérico), enciérrala entre comillas invertidas (backticks).
cloud.aws.dx.connection_error_count
Ejemplo documentado de la regla 2: la clave clásica ext:cloud.aws.dx.connectionErrorCount (errores de conexión de AWS Direct Connect) pasa a ser cloud.aws.dx.connection_error_count. Aplica la misma transformación a cualquier métrica ext: antes de concluir que falta en Grail.
timeseries err = sum(cloud.aws.dx.connection_error_count)cloud.gcp.cloudfunctions_googleapis_com.function.active_instances
Ejemplo documentado de la regla 3: una métrica de Google Cloud (instancias activas de una Cloud Function) que se consulta sin cambios. Para una clave con guion, la documentación da el ejemplo `com.dynatrace.extension.snmp-generic-cisco-device.cpm.cpu.loadavg.5min`.
timeseries inst = avg(cloud.gcp.cloudfunctions_googleapis_com.function.active_instances)Cómo comprobar que funciona
- Abre un notebook y lanza
timeseries sum(dt.cloud.aws.lambda.invocations)(o una clave de Azure de tu perímetro) sobre las últimas 24 horas: debe volver una serie. Si no vuelve nada, comprueba que la integración cloud está configurada y que el servicio está marcado en su lista de servicios. - Lanza
load "/dt/platform/metrics.metadata" | filter startsWith(metric.key, "dt.cloud.")para listar las claves cloud conocidas en tu entorno, con su unidad y sus dimensiones. - Antes de añadir un
by:, abre la clave en el navegador de métricas para leer el nombre exacto de sus dimensiones en Grail. - Las métricas de CloudWatch llegan con retraso: prueba tus alertas en una ventana de varios minutos, no en el último minuto.
Las consultas de este módulo siguen la sintaxis detallada en DQL timeseries: la guía avanzada. Para poner en marcha la integración con AWS, consulta Dynatrace AWS: métricas de CloudWatch y logs; en el lado de Azure, Dynatrace Azure y Azure Monitor.
Preguntas frecuentes
¿Por qué algunas métricas clásicas de AWS no existen en Grail?
La documentación lista las métricas clásicas de AWS no admitidas en Grail, en particular las métricas internas builtin:cloud.aws.cloudwatch.* que describen el estado de la recogida. Las métricas de servicio (Lambda, EC2, RDS, ALB…) sí tienen su equivalente dt.cloud.aws.*.
¿Hay que preferir dt.cloud.* o las métricas de OneAgent?
Cuando OneAgent funciona en la máquina, sus métricas (dt.host.*, dt.process.*) son más finas. Las métricas dt.cloud.* sirven para los servicios gestionados donde no es posible ningún agente: funciones, bases de datos gestionadas, balanceadores, cachés.
¿Cómo saber si una métrica de extensión ya está en Grail?
Aplica las tres reglas de nombres y busca después la clave en load "/dt/platform/metrics.metadata". Si sigue sin aparecer, consulta la documentación de la extensión: algunas métricas calculadas todavía no son compatibles con Grail.
Con estas 21 fichas, los módulos 2 a 6 cubren toda la pila, del host a los servicios cloud gestionados. El último módulo muestra cómo consultar estas métricas con precisión, crear las tuyas y disparar alertas.
← Módulo 5: métricas de Kubernetes en Grail · Índice del curso · Módulo 7: DQL timeseries y alertas →
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Este módulo no sustituye la documentación oficial: comprueba cada clave, unidad y dimensión en la documentación y en el navegador de métricas de tu entorno.