Curso: Métricas de Dynatrace SaaS · Módulo 3/7 — métricas de servicio de Grail, solicitudes, mensajería y service mesh · Formato: fichas de referencia · Plataforma: Dynatrace SaaS (Grail, DQL)
En este módulo: 12 entradas dt.service.* (solicitudes, mensajería, service mesh, métricas calculadas), una tabla resumen y una ficha por métrica.
Las métricas de servicio de Grail son las claves dt.service.* que describen lo que viven tus servicios. Tercer módulo del curso de métricas de Dynatrace SaaS, las ordena en fichas: solicitudes HTTP y RPC por endpoint, mensajería (Kafka, RabbitMQ, SQS…) y service mesh. Cada ficha da la unidad, las dimensiones, un caso de uso y una consulta DQL.
Las métricas de servicio miden lo que viven los llamantes: cuántas solicitudes llegan, cuántas fallan, cuánto tardan. Son las señales de oro sobre las que se construyen los SLO y, por tanto, las alertas que despiertan a alguien con razón. Dynatrace las produce automáticamente para cada endpoint detectado, sin configuración.
El contenido vale para Dynatrace SaaS. Para Dynatrace Managed, consulta el módulo de métricas de servicio builtin. Las claves de host están en el módulo 2; este módulo sirve para encontrar rápido la clave de servicio adecuada y su particularidad.
Métricas de servicio de Grail: la tabla resumen
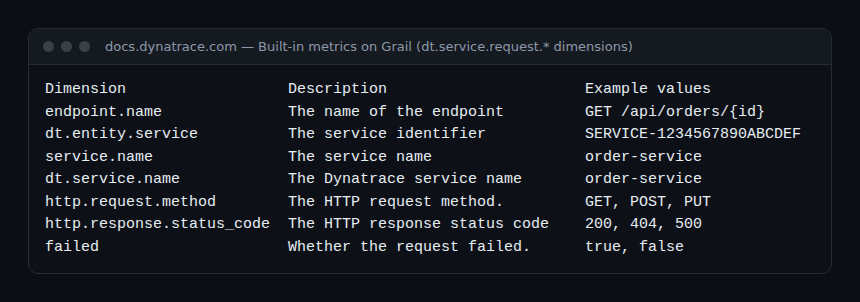
Solo doce entradas: en Grail, las dimensiones sustituyen a la multiplicación de claves. Donde Classic tenía una clave para los errores 4xx, otra para los 5xx y otra para las solicitudes clave, Grail mantiene dt.service.request.count y te deja filtrar. Las unidades y dimensiones proceden de la página de referencia; «ver el descriptor» señala lo que esta no precisa.
| Clave | Unidad | Dimensiones principales | Qué mide |
|---|---|---|---|
dt.service.request.count |
número | dt.entity.service, endpoint.name, http.request.method, http.response.status_code, failed |
Solicitudes recibidas por endpoint |
dt.service.request.failure_count |
número | dt.entity.service, endpoint.name, http.request.method, http.response.status_code |
Solicitudes fallidas por endpoint |
dt.service.request.response_time |
µs | dt.entity.service, endpoint.name, http.request.method, http.response.status_code, failed |
Tiempo de respuesta de las solicitudes por endpoint |
dt.service.messaging.publish.count |
número | dt.entity.service, messaging.destination.name, messaging.system |
Mensajes enviados a colas o topics |
dt.service.messaging.receive.count |
número | dt.entity.service, messaging.destination.name, messaging.system |
Mensajes recibidos desde colas o topics |
dt.service.messaging.process.count |
número | dt.entity.service, messaging.destination.name, messaging.system |
Mensajes procesados con éxito |
dt.service.messaging.process.duration |
ver el descriptor | dt.entity.service, messaging.destination.name, messaging.system |
Tiempo dedicado a procesar los mensajes |
dt.service.messaging.process.failure_count |
número | dt.entity.service, messaging.destination.name, messaging.system |
Mensajes cuyo procesamiento ha fallado |
dt.service.request.service_mesh.count |
número | ver el descriptor | Solicitudes vistas por el service mesh |
dt.service.request.service_mesh.failure_count |
número | ver el descriptor | Solicitudes fallidas vistas por el service mesh |
dt.service.request.service_mesh.response_time |
ver el descriptor | ver el descriptor | Tiempo de respuesta visto por el service mesh |
service.<nombre_de_la_métrica> |
según la definición | dimensión Classic + placeholders desglosados | Métrica de servicio calculada, migrada desde calc:service:… |
Fichas: solicitudes, mensajería y service mesh
Mismo orden en cada ficha: utilidad, caso de uso, trampa, consulta DQL. Las dimensiones de infraestructura (k8s.namespace.name, k8s.cluster.name, aws.region, dt.host_group.id…) y los primary_tags.* también están disponibles en las métricas de solicitudes y de mensajería, sin necesidad de un join de topología.
dt.service.request.count
Utilidad: el tráfico, primera señal de oro, y el denominador de toda tasa de fallos.
Caso de uso: una sola clave sustituye a una treintena de claves Classic (éxito, 4xx, 5xx, solicitudes clave): se filtra por http.response.status_code o failed en lugar de cambiar de métrica. Ejemplo: la parte de respuestas 5xx de un servicio.
Trampa: las métricas se recogen por minuto: añade rate: 1s si quieres solicitudes por segundo.
timeseries {all = sum(dt.service.request.count),
    s5xx = sum(dt.service.request.count, filter: {http.response.status_code >= 500}, default: 0)},
    by: {dt.entity.service}, union: true
| fieldsAdd pct_5xx = s5xx[] / all[] * 100
dt.service.request.failure_count
Utilidad: el numerador de la tasa de errores, base de un SLI de disponibilidad.
Caso de uso: ordenar los endpoints por número de fallos para saber cuál consume el presupuesto de error.
Trampa: la documentación precisa que la métrica contiene puntos a cero para las solicitudes correctas, con el fin de distinguir «hay fallos», «ningún fallo» y «ninguna solicitud». Una consulta timeseries normal no los devuelve: piensa en default: 0 en los ratios.
timeseries failed = sum(dt.service.request.failure_count), by: {dt.entity.service, endpoint.name}
| sort arraySum(failed) desc
| limit 10
dt.service.request.response_time
Utilidad: la latencia, medida del lado del servicio.
Caso de uso: el percentil 99 por servicio, como en el ejemplo de la documentación DQL, para seguir la cola de la distribución.
Trampa: la unidad es el microsegundo: un umbral de 300 ms se escribe 300000.
timeseries p99 = percentile(dt.service.request.response_time, 99),
    by: {dt.entity.service}
| limit 5
dt.service.messaging.publish.count
Utilidad: el caudal producido por un servicio, del lado del emisor.
Caso de uso: una caída a cero de la publicación en un topic de eventos de negocio señala un productor bloqueado antes de cualquier queja.
Trampa: estas métricas solo existen en Grail: no hay equivalencia Classic que migrar.
timeseries pub = sum(dt.service.messaging.publish.count),
    by: {messaging.destination.name, messaging.system}
dt.service.messaging.receive.count
Utilidad: la contrapartida de la publicación en el lado del consumidor.
Caso de uso: comparar publicación y recepción en un mismo destino para ver si los consumidores siguen el ritmo.
timeseries {pub = sum(dt.service.messaging.publish.count),
    rec = sum(dt.service.messaging.receive.count)},
    by: {messaging.destination.name}, union: true
dt.service.messaging.process.count
Utilidad: el tráfico útil de un consumidor.
Caso de uso: comparado con receive.count, muestra si los mensajes recibidos se procesan realmente.
timeseries done = sum(dt.service.messaging.process.count, rate: 1m),
    by: {dt.entity.service, messaging.destination.name}
dt.service.messaging.process.duration
Utilidad: la latencia de un consumidor, invisible en las métricas de solicitudes HTTP.
Caso de uso: un tiempo de procesamiento que se duplica explica un retraso que se acumula en la cola.
Trampa: la página de referencia no da la unidad: léela en el navegador de métricas antes de fijar un umbral.
timeseries d = avg(dt.service.messaging.process.duration),
    by: {dt.entity.service, messaging.destination.name}
dt.service.messaging.process.failure_count
Utilidad: la tasa de errores de un consumidor.
Caso de uso: fallos concentrados en un destino apuntan a un formato de mensaje o a una dependencia posterior.
timeseries {ok = sum(dt.service.messaging.process.count),
    ko = sum(dt.service.messaging.process.failure_count, default: 0)},
    by: {messaging.destination.name}, union: true
| fieldsAdd fail_pct = ko[] / (ok[] + ko[]) * 100
dt.service.request.service_mesh.count
Utilidad: el tráfico medido por el proxy del mesh y no por el código instrumentado.
Caso de uso: una diferencia sostenida con dt.service.request.count revela solicitudes rechazadas por el proxy antes de llegar a la aplicación.
timeseries mesh = sum(dt.service.request.service_mesh.count, rate: 1s)dt.service.request.service_mesh.failure_count
Utilidad: capta los fallos de red y de proxy (timeouts, conexiones rechazadas) que la aplicación no ve.
Caso de uso: tasa de fallos del mesh que conviene seguir en paralelo a la del servicio durante una subida de versión del mesh.
timeseries {all = sum(dt.service.request.service_mesh.count),
    ko = sum(dt.service.request.service_mesh.failure_count, default: 0)}, union: true
| fieldsAdd fail_pct = ko[] / all[] * 100
dt.service.request.service_mesh.response_time
Utilidad: incluye el coste del proxy: la diferencia con el tiempo del servicio mide la sobrecarga del mesh.
Caso de uso: percentil 90 que vigilar tras activar el cifrado mutuo (mTLS).
Trampa: compara en la misma unidad: compruébala en el descriptor antes de restarla del tiempo del servicio.
timeseries p90 = percentile(dt.service.request.service_mesh.response_time, 90)service.<nombre_de_la_métrica>
Utilidad: conserva una necesidad de negocio concreta (importe, cliente, tipo de pedido) que las métricas integradas no cubren.
Caso de uso: una métrica existente calc:service:orders pasa a ser service.orders una vez activada en Grail, con sus placeholders transformados en dimensiones separadas.
Trampa: la documentación anuncia la obsolescencia de las métricas de servicio calculadas, sin fecha. Para una necesidad nueva, parte de las métricas de endpoint o de una extracción de métrica desde los spans en OpenPipeline.
timeseries sum(service.orders), by: {dt.entity.service}Cómo comprobar que funciona
- En un notebook, ejecuta
timeseries sum(dt.service.request.count), by: {dt.entity.service}: debe aparecer cada servicio instrumentado. - Añade
endpoint.namealby: si la columna está vacía para un servicio SDv1, activa los endpoints enriquecidos (Enhanced endpoints) como indica la documentación. - Para la mensajería, filtra por
messaging.system; la ausencia total de series suele significar que la biblioteca cliente no es compatible o no está instrumentada. - Compara una tasa de fallos calculada aquí con la pantalla del servicio en la aplicación Services: ambas deben contar la misma historia.
Buenas prácticas
- Filtra por dimensión en lugar de buscar una clave dedicada: código de estado HTTP, método, endpoint.
- Usa
default: 0yunion: trueen los ratios para no perder los servicios sin fallos. - Prefiere los percentiles a la media para la latencia, y convierte los umbrales a microsegundos.
Para ir más lejos: alertas de burn rate sobre los SLO transforma estas series en alertas sobre el presupuesto de error, migrar tus SLO a Grail trata el paso desde las claves Classic y la propagación de contexto en Kafka explica por qué las métricas de mensajería dependen de un contexto bien transmitido. Fuentes: Built-in metrics on Grail y comandos de métricas de DQL.
← Módulo 2: métricas de host en Grail · Índice del curso · Módulo 4: métricas RUM en Grail →
Preguntas frecuentes
¿Dónde han ido a parar las métricas de solicitudes clave?
Ya no hay una clave dedicada: las antiguas claves builtin:service.keyRequest.* corresponden a las métricas dt.service.request.*, filtradas por endpoint.name.
¿Funciona la misma consulta para SDv1 y SDv2?
Sí. Según la documentación, las métricas de endpoint se producen para los servicios SDv1 (con Enhanced endpoints) y SDv2, y una sola consulta cubre ambos.
¿Hay que seguir creando métricas de servicio calculadas?
No para una necesidad nueva: se anuncian como obsoletas. Las métricas integradas y sus dimensiones cubren la mayoría de los desgloses; para el resto, extrae una métrica desde los spans con OpenPipeline.
Con estas doce entradas cubres la latencia, el tráfico y los errores de tus servicios, síncronos o asíncronos. El módulo siguiente pasa al lado del usuario final: frontends RUM y monitorización sintética.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Este módulo es una selección comentada, no la lista oficial: las claves, unidades y dimensiones se han tomado de la documentación pública de Dynatrace SaaS y pueden cambiar; compruébalas en el navegador de métricas de tu entorno.