Curso: Métricas de Dynatrace SaaS · Módulo 2/7 — métricas de host de Grail, CPU, memoria, disco y red · Formato: fichas de referencia · Plataforma: Dynatrace SaaS (Grail, DQL)
En este módulo: 26 claves dt.host.*, una tabla resumen y una ficha por métrica con su consulta DQL.
Las métricas de host de Grail son las claves dt.host.* que OneAgent reporta para cada máquina: CPU, memoria, disco, red y disponibilidad. Este segundo módulo del curso de métricas de Dynatrace SaaS las reúne en forma de fichas, para tenerlas abiertas durante la guardia (on-call): una línea por métrica y una consulta lista para copiar.
Las métricas de host describen la capa sobre la que descansa todo lo demás: CPU, memoria, discos, interfaces de red y disponibilidad, recogidas por OneAgent en Windows, Linux y AIX. Responden a la pregunta «¿aguanta la máquina?» y sirven como señal de saturación, la cuarta señal de oro junto a la latencia, el tráfico y los errores.
Este contenido vale para Dynatrace SaaS (Grail, DQL). Para Dynatrace Managed, los equivalentes builtin:host.* se tratan en el módulo de hosts de infraestructura del curso de Managed. Si estás descubriendo el modelo de datos (claves, dimensiones, comando timeseries), empieza por el módulo 1 sobre las métricas de Grail.
Métricas de host de Grail: la tabla resumen
Las 26 claves seleccionadas, agrupadas por familia. Las unidades proceden de las etiquetas de la página de referencia; «según el descriptor» significa que la documentación no la indica de forma explícita. Las dimensiones indicadas son las que se usan en los ejemplos de la documentación.
| Clave | Unidad | Dimensiones principales | Qué mide |
|---|---|---|---|
dt.host.cpu.usage |
% | dt.entity.host |
Parte de la CPU utilizada, todos los modos juntos |
dt.host.cpu.user |
% | dt.entity.host |
Tiempo de CPU en modo usuario |
dt.host.cpu.system |
% | dt.entity.host |
Tiempo de CPU en modo kernel |
dt.host.cpu.iowait |
% | dt.entity.host |
Tiempo de CPU inactiva a la espera de entrada/salida |
dt.host.cpu.steal |
% | dt.entity.host |
Tiempo de CPU que el hipervisor dedica a otras máquinas virtuales |
dt.host.cpu.load |
número (carga) | dt.entity.host |
Carga del sistema (load average), con las variantes dt.host.cpu.load5m y dt.host.cpu.load15m |
dt.host.memory.usage |
% | dt.entity.host |
Memoria utilizada en porcentaje |
dt.host.memory.avail.percent |
% | dt.entity.host |
Memoria disponible en porcentaje |
dt.host.memory.avail.bytes |
bytes | dt.entity.host |
Memoria disponible en valor absoluto |
dt.host.memory.used |
bytes | dt.entity.host |
Memoria utilizada en bytes |
dt.host.memory.avail.pfps |
fallos de página/s | dt.entity.host |
Fallos de página por segundo |
dt.host.memory.swap.used |
bytes | dt.entity.host |
Espacio de intercambio utilizado (véanse también swap.avail y swap.total) |
dt.host.disk.used.percent |
% | dt.entity.host, dt.entity.disk |
Espacio de disco utilizado, por disco |
dt.host.disk.avail |
bytes | dt.entity.host, dt.entity.disk |
Espacio de disco disponible en bytes |
dt.host.disk.inodes_avail |
% | dt.entity.host, dt.entity.disk |
Inodos disponibles en porcentaje (Linux, excepto CIFS) |
dt.host.disk.queue_length |
número | dt.entity.host, dt.entity.disk |
Longitud media de la cola del disco (excepto NFS, CIFS, GPFS) |
dt.host.disk.util_time |
según el descriptor | dt.entity.host, dt.entity.disk |
Tiempo de utilización del disco (excepto NFS, CIFS, GPFS) |
dt.host.disk.bytes_read |
bytes/s | dt.entity.host, dt.entity.disk |
Caudal de lectura (y dt.host.disk.bytes_written para la escritura) |
dt.host.disk.read_ops |
operaciones/s | dt.entity.host, dt.entity.disk |
Lecturas por segundo (IOPS), con dt.host.disk.write_ops |
dt.host.net.nic.bytes_rx |
bytes/s | dt.entity.host |
Bytes recibidos por interfaz de red (y bytes_tx para la emisión) |
dt.host.net.nic.link_util_rx |
% | dt.entity.host |
Utilización del enlace en recepción (y link_util_tx) |
dt.host.net.nic.packets.dropped_rx |
paquetes/s | dt.entity.host |
Paquetes entrantes descartados (y dropped_tx) |
dt.host.net.nic.packets.errors_rx |
paquetes/s | dt.entity.host |
Errores de recepción (y errors_tx) |
dt.host.availability |
número | dt.entity.host, availability.state |
Estado de disponibilidad del host visto por OneAgent |
dt.host.handles.file_descriptors_used |
número | dt.entity.host |
Descriptores de archivo utilizados (y file_descriptors_max) |
dt.host.uptime |
duración | dt.entity.host |
Tiempo transcurrido desde el último arranque del host |
Fichas: una métrica de host, una utilidad
Cada ficha sigue el mismo orden: utilidad, caso de uso, trampa eventual y consulta DQL timeseries. Los umbrales citados son ejemplos que hay que calibrar con tu historial.
dt.host.cpu.usage
Utilidad: el primer indicador de saturación de un host, el que se pone en un dashboard de guardia.
Caso de uso: detectar los hosts que están de forma sostenida por encima de tu umbral interno de capacidad (un umbral que fijas tú mismo, la documentación no impone ninguno) comparando la media y el máximo en la misma ventana.
Trampa: una media de 24 h suaviza los picos; mantén el max al lado antes de concluir que un host está infrautilizado.
timeseries {avg_cpu = avg(dt.host.cpu.usage), max_cpu = max(dt.host.cpu.usage)},
    by: {dt.entity.host}
| fieldsAdd host = entityName(dt.entity.host)
dt.host.cpu.user
Utilidad: indica si la carga procede de las propias aplicaciones.
Caso de uso: si dt.host.cpu.usage sube y user lo sigue, mira los procesos de aplicación (módulo 5) en lugar del kernel.
timeseries {user = avg(dt.host.cpu.user), system = avg(dt.host.cpu.system)},
    by: {dt.entity.host}
dt.host.cpu.system
Utilidad: revela el coste de las llamadas al sistema: red intensa, muchas operaciones de entrada/salida, cambios de contexto.
Caso de uso: un system que supera de forma sostenida a user en un servidor de aplicaciones merece un análisis (controlador, firewall de software, agente de terceros).
timeseries system = avg(dt.host.cpu.system), by: {dt.entity.host}
| sort arrayAvg(system) desc
| limit 10
dt.host.cpu.iowait
Utilidad: distingue un host que calcula de un host que espera a su disco o a su almacenamiento de red.
Caso de uso: cruza la métrica con dt.host.disk.queue_length: si ambas suben a la vez, apuntan al almacenamiento.
Trampa: el umbral 20 de la consulta es un ejemplo que hay que adaptar, no un valor de referencia.
timeseries iowait = max(dt.host.cpu.iowait), by: {dt.entity.host}
| filter arrayMax(iowait) > 20
dt.host.cpu.steal
Utilidad: en una VM o una instancia cloud, explica una lentitud que nada justifica dentro del invitado.
Caso de uso: un steal que aparece a las mismas horas cada día sugiere un vecino ruidoso o una instancia con los créditos de CPU agotados; es un asunto para el equipo de plataforma, no para la aplicación.
timeseries steal = avg(dt.host.cpu.steal), by: {dt.entity.host}
| filter arrayMax(steal) > 0
dt.host.cpu.load
Utilidad: cuenta las tareas listas o bloqueadas, algo que el porcentaje de CPU no muestra.
Caso de uso: compara la carga con el número de núcleos del host; una carga a 15 minutos que se mantiene por encima del número de núcleos señala una cola ya instalada.
Trampa: la carga solo tiene sentido en relación con el número de núcleos; no compares dos hosts de tamaños distintos con el valor bruto.
timeseries {l1 = avg(dt.host.cpu.load), l15 = avg(dt.host.cpu.load15m)},
    by: {dt.entity.host}
dt.host.memory.usage
Utilidad: la visión de conjunto de la presión de memoria.
Caso de uso: tendencia a siete días para la revisión de capacidad; para la alerta, prefiere la memoria disponible que figura más abajo.
Trampa: en Linux, la caché de archivos es recuperable: un porcentaje alto no es necesariamente un problema.
timeseries mem = avg(dt.host.memory.usage), by: {dt.entity.host}, from: -7d, interval: 1hdt.host.memory.avail.percent
Utilidad: la señal que precede al swap y al OOM killer.
Caso de uso: alerta cuando la memoria disponible baja de un mínimo que tú defines, por ejemplo un 10 % durante varios minutos.
timeseries avail = min(dt.host.memory.avail.percent), by: {dt.entity.host}
| filter arrayMin(avail) < 10
dt.host.memory.avail.bytes
Utilidad: útil en máquinas grandes, donde un 5 % representa todavía varios gigabytes.
Caso de uso: comprueba que queda espacio para arrancar una instancia más de un servicio antes de un despliegue.
timeseries avail = min(dt.host.memory.avail.bytes), by: {dt.entity.host}dt.host.memory.used
Utilidad: permite sumar el consumo de un grupo de hosts.
Caso de uso: estimar la memoria realmente consumida por una granja de servidores antes de una migración o un redimensionamiento.
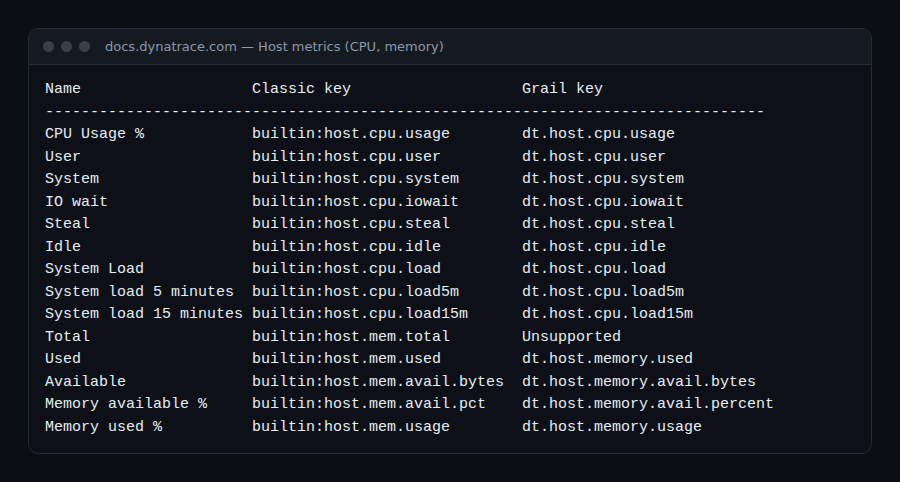
Trampa: según la página de referencia de las métricas de host, la memoria total no está disponible en Grail: dedúcela de used + disponible si hace falta.
timeseries used = avg(dt.host.memory.used), by: {dt.host_group.id}dt.host.memory.avail.pfps
Utilidad: una tasa alta y sostenida indica que el sistema va a buscar páginas al disco.
Caso de uso: compara la curva con su nivel habitual: lo que cuenta es la ruptura de tendencia, no el valor absoluto.
timeseries pf = avg(dt.host.memory.avail.pfps), by: {dt.entity.host}dt.host.memory.swap.used
Utilidad: un swap que crece anuncia latencias, mucho antes de una caída.
Caso de uso: ratio utilizado / total para seguir el porcentaje de swap consumido.
timeseries {used = avg(dt.host.memory.swap.used), total = avg(dt.host.memory.swap.total)},
    by: {dt.entity.host}
| fieldsAdd swap_pct = used[] / total[] * 100
dt.host.disk.used.percent
Utilidad: la métrica de llenado más legible.
Caso de uso: listar los volúmenes más llenos de producción.
timeseries used = max(dt.host.disk.used.percent), by: {dt.entity.host, dt.entity.disk}
| fieldsAdd disk = entityName(dt.entity.disk)
| sort arrayLast(used) desc
| limit 20
dt.host.disk.avail
Utilidad: base de las previsiones de llenado.
Caso de uso: proyectar la fecha en que un volumen estará lleno (el análisis de previsión de Dynatrace toma esta familia de métricas como entrada).
Trampa: dt.host.disk.free no es un número de bytes: la página de referencia la asocia al porcentaje de espacio disponible.
timeseries avail = avg(dt.host.disk.avail), by: {dt.entity.disk}, interval: 1h, from: -7ddt.host.disk.inodes_avail
Utilidad: un disco puede estar «lleno» con espacio libre si los inodos se han agotado.
Caso de uso: volúmenes de logs o de colas de mensajes que crean millones de archivos pequeños.
timeseries inodes = min(dt.host.disk.inodes_avail), by: {dt.entity.host, dt.entity.disk}
| filter arrayMin(inodes) < 15
dt.host.disk.queue_length
Utilidad: mide la saturación del disco, mientras que el espacio solo mide el llenado.
Caso de uso: una cola que se mantiene alta durante un pico de latencia del servicio une el síntoma con su causa.
timeseries q = avg(dt.host.disk.queue_length), by: {dt.entity.host, dt.entity.disk}dt.host.disk.util_time
Utilidad: indica cuánto tiempo está el disco ocupado atendiendo solicitudes.
Caso de uso: en un disco local, una ocupación cercana al máximo durante las copias de seguridad explica las lentitudes de la noche.
Trampa: comprueba la unidad en el navegador de métricas antes de fijar un umbral; no figura en la tabla de referencia.
timeseries util = avg(dt.host.disk.util_time), by: {dt.entity.disk}dt.host.disk.bytes_read
Utilidad: da el volumen transferido, que conviene comparar con los límites del almacenamiento.
Caso de uso: en un disco cloud con el caudal limitado, una meseta plana en la curva indica que se ha alcanzado el límite.
timeseries {r = avg(dt.host.disk.bytes_read), w = avg(dt.host.disk.bytes_written)},
    by: {dt.entity.host}
dt.host.disk.read_ops
Utilidad: los discos cloud suelen estar limitados en IOPS antes que en caudal.
Caso de uso: comparar la suma de lecturas + escrituras con los IOPS aprovisionados del volumen.
timeseries {r = avg(dt.host.disk.read_ops), w = avg(dt.host.disk.write_ops)},
    by: {dt.entity.disk}
| fieldsAdd iops = r[] + w[]
dt.host.net.nic.bytes_rx
Utilidad: el tráfico bruto de un host, para el dimensionamiento y la detección de anomalías.
Caso de uso: una caída brusca del tráfico recibido por un nodo de balanceador indica que ya no recibe solicitudes.
timeseries {rx = avg(dt.host.net.nic.bytes_rx), tx = avg(dt.host.net.nic.bytes_tx)},
    by: {dt.entity.host}
dt.host.net.nic.link_util_rx
Utilidad: relaciona el tráfico con la capacidad de la tarjeta.
Caso de uso: una interfaz cercana a su capacidad explica pérdidas de paquetes y tiempos de respuesta que se alargan.
timeseries {rx = max(dt.host.net.nic.link_util_rx), tx = max(dt.host.net.nic.link_util_tx)},
    by: {dt.entity.host}
dt.host.net.nic.packets.dropped_rx
Utilidad: los descartes señalan búferes saturados o una interfaz sobrecargada.
Caso de uso: cualquier valor distinto de cero y recurrente merece un ticket; relaciónalo con las retransmisiones del lado de la aplicación.
timeseries dropped = sum(dt.host.net.nic.packets.dropped_rx), by: {dt.entity.host}
| filter arraySum(dropped) > 0
dt.host.net.nic.packets.errors_rx
Utilidad: los errores dependen más del hardware o del controlador que de la carga.
Caso de uso: errores en un único host de un grupo homogéneo orientan hacia un cable, un puerto o una tarjeta.
timeseries errors = sum(dt.host.net.nic.packets.errors_rx), by: {dt.entity.host}dt.host.availability
Utilidad: la base de un SLI de infraestructura.
Caso de uso: contar los hosts en un estado distinto de «up» para detectar una parada o una pérdida de conexión del agente.
Trampa: un host no disponible puede ser también un OneAgent detenido; compruébalo antes de abrir un incidente de hardware.
timeseries n = sum(dt.host.availability, default: 0),
    by: {availability.state}
dt.host.handles.file_descriptors_used
Utilidad: el agotamiento de los descriptores bloquea las conexiones nuevas sin saturar la CPU ni la memoria.
Caso de uso: seguir el ratio utilizado / máximo en los servidores con mucha concurrencia (proxies, bases de datos).
timeseries {used = max(dt.host.handles.file_descriptors_used),
    max = max(dt.host.handles.file_descriptors_max)},
    by: {dt.entity.host}
| fieldsAdd fd_pct = used[] / max[] * 100
dt.host.uptime
Utilidad: confirma un reinicio inesperado durante un incidente.
Caso de uso: un valor que cae cerca de cero en el momento de un pico de errores explica el corte.
Trampa: la lista de métricas de Grail cita dt.host.uptime, pero la página de referencia de las métricas de host indica todavía la clave Classic en su columna de Grail: comprueba su presencia en tu entorno antes de usarla.
timeseries up = min(dt.host.uptime), by: {dt.entity.host}Cómo comprobar que funciona
- Abre un notebook y ejecuta
timeseries avg(dt.host.cpu.usage), by: {dt.entity.host}sobre las dos últimas horas: debe aparecer una serie por host. - Si una clave de este módulo no devuelve nada, búscala en el navegador de métricas: algunas dependen del sistema (AIX, Linux) o del tipo de disco (notas de la página de referencia).
- Compara un valor con la pantalla del host en la aplicación Infrastructure: los órdenes de magnitud deben coincidir.
- Si no llega ninguna métrica de host, comprueba que OneAgent funciona en modo Full-Stack o Infrastructure; en modo Discovery solo se envía una parte de las métricas.
Buenas prácticas
- Genera alertas sobre la memoria disponible, los inodos y la cola de disco; reserva la CPU media para la capacidad.
- Agrupa por
dt.entity.hostodt.host_group.id, nunca por una dimensión volátil. - Calibra cada umbral con entre dos y cuatro semanas de historial antes de despertar a alguien.
Para ir más lejos: la formación sobre DQL timeseries detalla los parámetros usados aquí (by, interval, default), y el artículo alertas de burn rate sobre los SLO muestra cómo pasar de una métrica a una alerta útil. Fuentes: Built-in metrics on Grail y Host metrics.
← Módulo 1: métricas de Grail · Índice del curso · Módulo 3: métricas de servicio en Grail →
Preguntas frecuentes
¿Por qué este módulo no cita la memoria total del host?
La página de referencia de las métricas de host marca la memoria total como no admitida en Grail. Suma la memoria utilizada y la disponible si necesitas un orden de magnitud.
¿Qué dimensión usar para agrupar por host?
dt.entity.host, que se transforma en un nombre legible con entityName(). Para las métricas de disco, añade dt.entity.disk para distinguir los volúmenes.
¿Valen estas fichas para Dynatrace Managed?
No. Managed no tiene ni Grail ni DQL: allí se usan las claves builtin:host.* y el metric selector. El curso de Managed sigue la misma estructura para orientarte.
Estas veintiséis claves cubren lo esencial del diagnóstico de un host. El módulo siguiente sube un piso y pasa a los servicios: solicitudes, fallos, mensajería y service mesh.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Este módulo es una selección comentada, no la lista oficial: las claves, unidades y dimensiones se han tomado de la documentación pública de Dynatrace SaaS y pueden cambiar; compruébalas en el navegador de métricas de tu entorno.