Suena el busca en plena madrugada de un Cyber Monday: el 4 % de los pagos falla y el panel solo enseña barras rojas. Faltan las excepciones OpenTelemetry trazas. Sin ellas, sabes que un span ha fallado, pero no por qué; con ellas, la pila de llamadas viaja dentro de la misma traza que el error.
Parto de esa guardia y recorro el camino con el SDK de Python: qué hay que escribir en el código, qué guarda realmente el span, cómo decidir ante la obsolescencia anunciada y cómo filtrar después en Dynatrace SaaS. Para un SRE el objetivo es bajar el MTTR: pasar de la tasa de errores a la causa en dos consultas.
Qué he comprobado y qué no. Ejecuté el código de Python con opentelemetry-sdk 1.45.2 y enseño la salida real. No ejecuté las consultas DQL: proceden de la documentación de Dynatrace y valen como ejemplo. Todo se refiere a Dynatrace SaaS (Grail, DQL); Dynatrace Managed queda fuera.
Dos datos, dos campos: el estado y la excepción
Un span que termina sin decir nada queda con el estado Unset, que la documentación de OpenTelemetry interpreta como «sin error». Para que cuente en un SLI hay que marcarlo como ERROR. Ese es el primer campo: se filtra y se cuenta.
El segundo campo responde a la pregunta de las 3:00. La excepción vive en un evento colgado del span que falló, es decir, del servicio y la operación correctos y con el trace_id exacto. No hace falta cruzar nada a mano con un archivo de log.
Quédate con esta regla de lectura: el estado sirve para contar y el evento sirve para entender. Con uno solo nunca basta.
Excepciones OpenTelemetry trazas: registrarlas desde el código
En sus ejemplos de Python, OpenTelemetry combina un set_status con un record_exception. En la página que leí no aparece que una excepción que atraviesa un bloque with dispare ambas llamadas por sí sola, así que las escribo yo, en un único lugar.
Mi entorno de prueba: el paquete opentelemetry-sdk, un exportador de consola para leer el span sin necesidad de backend y una función de cobro que falla a propósito.
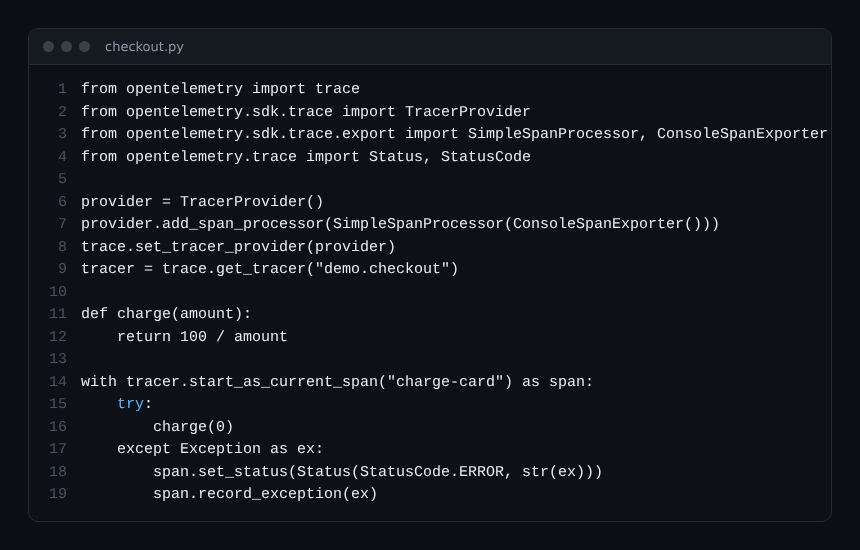
En ese archivo importan dos detalles. La línea 18 copia el mensaje en la descripción del estado, de modo que se lee sin abrir el evento. La línea 19 crea el evento. Y si quien llama debe enterarse del fallo, cierra el bloque con un raise; de lo contrario los spans padre siguen en verde aunque el hijo haya fallado.
Leer el span: lo que produjo la ejecución
La especificación fija el nombre de evento exception y tres atributos: exception.type, exception.message y exception.stacktrace. Tipo y mensaje son «condicionalmente obligatorios» (basta uno de los dos) y la pila es solo recomendable. Esto fue lo que imprimió mi consola.
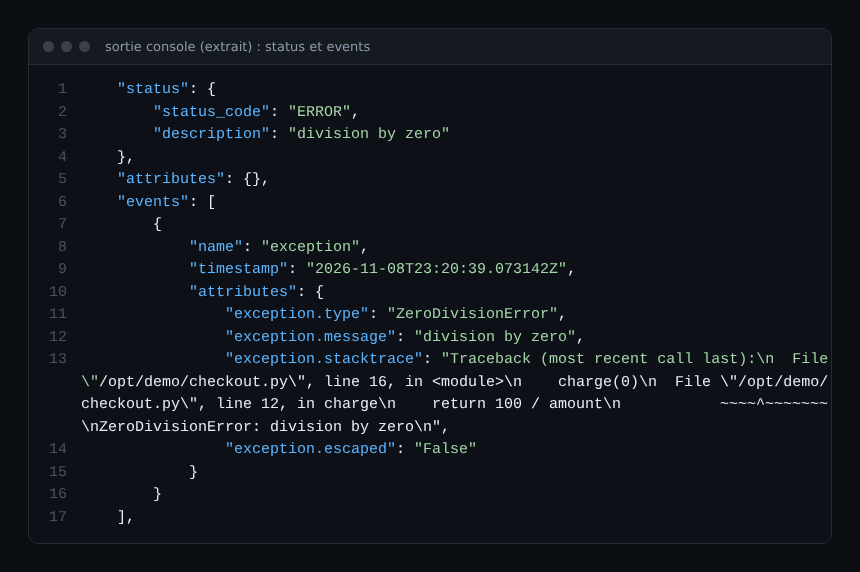
- Estado y evento conviven en el mismo objeto, pero son datos independientes.
- Mi SDK añade además
exception.escaped. La especificación lo da por obsoleto y pide dejar de registrar las excepciones controladas que no salen del span. - El mensaje llega tal cual a tu backend, y la especificación avisa de que puede contener datos sensibles. Un número de cliente o un token no pintan nada en el texto de una excepción.
¿Hay que temer la obsolescencia? Una decisión en tres tiempos
La página de la especificación sobre excepciones en spans muestra «Deprecated» y remite a las convenciones de logs. Sin embargo, el SDK que ejecuté sigue generando el evento. Ambas cosas son ciertas a la vez, y te toca a ti decidir.
Para gobernar la transición, la especificación define la variable OTEL_SEMCONV_EXCEPTION_SIGNAL_OPT_IN:
- sin definir: la instrumentación conserva el evento de span;
logs: las excepciones salen solo como logs;logs/dup: salen las dos señales, útil durante un despliegue gradual.
En los logs, la severidad depende de la gravedad: ERROR (17) para una excepción no controlada que no detiene la aplicación y WARN (13) para la que el código debe tratar. Si la instrumentación también crea spans, el log ha de llevar el contexto del span afectado.
Así lo decido yo. Primero: mientras tu SDK emita el evento y tus consultas lo lean, no toques nada. Segundo: prueba logs/dup en un servicio poco crítico. Tercero: apaga el evento solo cuando ya hayas reescrito tus consultas.
Ojo: cada SDK decide si lee esta variable. Con logs y el SDK de Python 1.45.2, el evento seguía dentro del span. No he probado otros lenguajes ni los agentes de autoinstrumentación.
La misma lógica de transición existe en HTTP: mira las convenciones semánticas de OpenTelemetry y su estabilidad. Para la parte de logs, lee los logs estables de OpenTelemetry.
De la tasa de errores a la causa en Dynatrace SaaS
Los spans llegan por OTLP, directamente o a través de un Collector. El montaje está en el Collector de OpenTelemetry hacia Dynatrace. No probé la ingesta de extremo a extremo.
La página «Use traces, DQL, and logs to spot patterns» de la documentación de Dynatrace propone una consulta de triaje, que comento a mi manera.
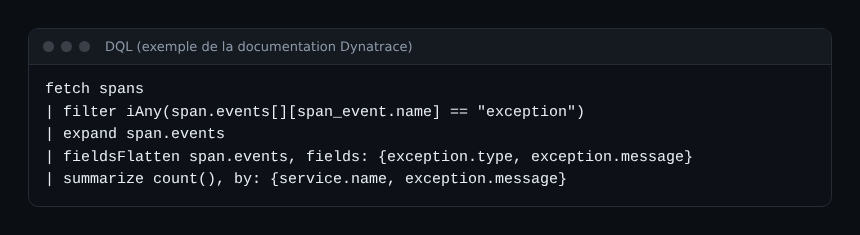
De arriba abajo hace cuatro cosas. Primero, filter iAny(…) descarta todos los spans sin evento exception. Luego, expand span.events despliega la lista: una fila por evento. Después, fieldsFlatten convierte exception.type y exception.message en columnas. Por último, summarize cuenta por servicio y por mensaje: arriba del todo queda el sospechoso más probable.
Para ver cuándo empezó el error, esa misma página propone makeTimeseries count(), by: {exception.type}, time:start_time. Con el servicio localizado, abre una traza fallida y lee la pila. Si la traza no existe, empieza por el diagnóstico de trazas OpenTelemetry ausentes.
Sin verificar: el nombre exacto del campo de estado en los spans de Grail. No me lo invento; compruébalo en un notebook antes de montar una alerta sobre él.
Cinco trampas con las que me topé
- Excepción sin estado: aparece en la traza, pero no entra en tu tasa de errores.
- Estado sin excepción: el span sale en rojo, sin pila.
- Excepciones controladas: si el código las captura y sigue, no las registres; ahogarías los errores de verdad.
- Doble conteo: con
logs/dup, la misma excepción existe dos veces. Deduplica antes de contar. - Obsolescencia mal entendida: afecta a la convención del span. La llamada
record_exceptionsigue en el ejemplo oficial de Python que leí.
Buenas prácticas
- Estado y excepción en el mismo punto, una vez por span.
- Un
raisetras registrar, para que los padres vean el fallo. - Migrar con
logs/dupy medir antes de apagar nada. - Mensajes de excepción sin datos personales.
- Logs enlazados con las trazas, como en los logs de OpenTelemetry con trace_id.
Preguntas frecuentes
¿Sigo llamando a record_exception?
Sí, si tu SDK genera el evento y tu backend lo lee. La variable de transición demuestra que el comportamiento por defecto sigue siendo el evento de span. Prueba tu propio SDK.
¿Estado ERROR o evento exception: cuál elijo?
Los dos. El estado permite filtrar y contar los fallos; el evento aporta tipo, mensaje y pila.
¿Cómo ordeno los servicios por número de excepciones?
Adapta la consulta de la documentación: filter iAny sobre el evento, expand, fieldsFlatten y después summarize count() por service.name. Estas consultas valen para Dynatrace SaaS.
Conclusión
Tres gestos: fijar el estado, registrar el evento y planificar la salida hacia los logs. Hoy el evento de span funciona con el SDK probado, y la dirección oficial apunta a los logs. Haz evolucionar tus consultas al ritmo de tus SDK y verifica cada paso en tu entorno.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las demás marcas citadas pertenecen a sus propietarios. Las herramientas cambian rápido: comprueba siempre comandos y opciones en la documentación oficial correspondiente a tu versión. Fuentes: especificación de excepciones en spans (página leída el 8 de noviembre de 2026).