Piensa en el proceso de cierre que una empresa lanza cada madrugada: miles de llamadas a la API de un proveedor de pagos. Tres noches de cada siete, unas cuantas expiran, el proceso reintenta, todo termina pasando y nadie encuentra un solo error en el código. Si esas máquinas salen a Internet detrás de un Load Balancer público, el sospechoso tiene nombre: el agotamiento SNAT Azure. Aquí verás cómo reconocerlo, cómo medirlo en Dynatrace SaaS y desde qué umbral conviene despertar a alguien.
Una aclaración antes de empezar: span.observer no ha ejecutado estas consultas en una suscripción real. Los datos sobre Azure salen de las páginas de Microsoft sobre las conexiones salientes y sobre el diagnóstico del Load Balancer. Las consultas DQL se han armado a partir de la documentación de Dynatrace y están marcadas como no ejecutadas.
El alcance es deliberadamente acotado: la recolección que se describe pertenece a Azure Cloud Platform Monitoring, un servicio de Dynatrace SaaS. No se ha comprobado nada para Dynatrace Managed, así que no apliques estos ajustes allí sin consultar su documentación. Si tu suscripción aún no está conectada, empieza por la integración de Dynatrace con Azure: Azure Monitor y logs.
Por qué el agotamiento SNAT Azure parece un fallo de la aplicación
Una máquina detrás de un Load Balancer público no tiene una dirección enrutable hacia Internet. Azure reescribe entonces la IP de origen de sus paquetes salientes con la IP pública del frontal. Eso es SNAT, y cada conexión distinta hacia un mismo par IP:puerto de destino consume un puerto. Cada IP pública de frontal aporta 64 000 puertos utilizables.
La trampa está en el reparto. Esos puertos no forman una bolsa común: Azure los distribuye por adelantado entre las instancias del grupo. Sin regla de salida, cuanto más grande es el grupo, más pequeña es la porción de cada una, con un tope de 1024 puertos por instancia. La tabla de la página de Microsoft marca los escalones.
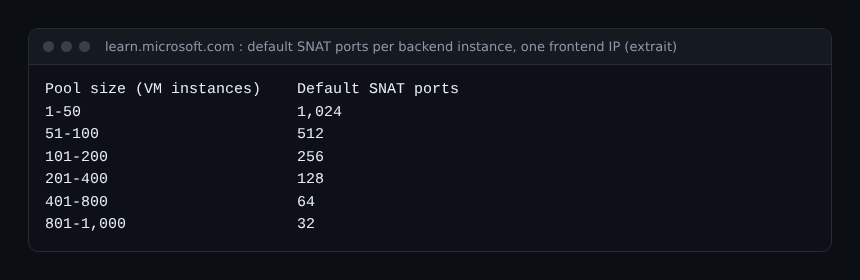
De ahí sale la consecuencia: una sola máquina muy activa puede quedarse sin puertos aunque el frontal conserve decenas de miles. Sus conexiones nuevas fallan y vuelven a funcionar cuando se libera un puerto (entre 4 y 120 minutos de inactividad, configurable por regla de salida). Ese vaivén explica la avería que se arregla sola y que los logs de la aplicación no saben explicar.
Dos señales, dos niveles de urgencia
Antes de escribir una consulta, decide qué quieres saber. Azure publica tres métricas SNAT en el Load Balancer público, con granularidad de un minuto.
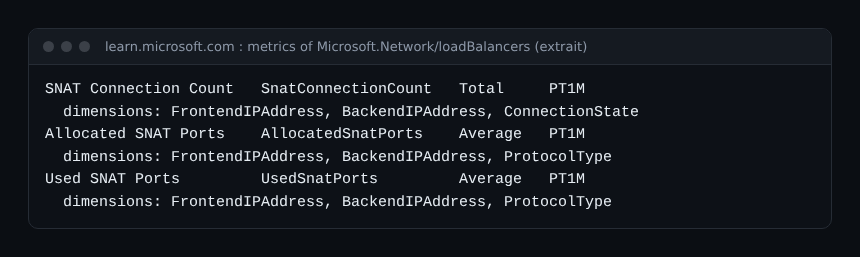
SnatConnectionCountcuenta las conexiones SNAT nuevas, desglosadas porConnectionState(pendiente, correcta, fallida).AllocatedSnatPortsindica la porción de puertos reservada para cada instancia.UsedSnatPortsindica lo que cada instancia usa de verdad.
Sirven para dos cosas distintas. Los fallos de SnatConnectionCount demuestran que la avería está ocurriendo: cualquier valor por encima de cero en el estado fallido es un incidente en curso. La relación entre puertos usados y asignados, en cambio, avisa con antelación. Microsoft propone gravedad baja al 75 % y gravedad alta al 90 % o al 100 %. Quédate con esta regla: el aviso del 75 % va a un ticket o a un canal; los fallos y el umbral alto activan la guardia. Ten en cuenta además que las métricas multidimensionales no están disponibles en un Load Balancer Basic.
Llevar las métricas a Dynatrace SaaS
El recolector de Dynatrace consulta Azure Monitor cada 5 minutos, con 5 minutos de retraso. Necesita un principal de servicio con el rol Monitoring Reader y el proveedor Microsoft.Insights registrado en cada suscripción; sin él, la topología llega pero las métricas no. Apunta ese desfase: la alerta no es instantánea.
Después, tres detalles que cuestan tiempo si se descubren tarde.
- El conjunto de métricas. Las tres métricas SNAT del Load Balancer Standard no están en el conjunto «Recommended», sino en «Recommended+Custom» (
microsoft_network.loadbalancers_essentialplus). Si no lo añades a la conexión de Azure, buscarás durante un buen rato datos que nunca llegarán. - El nombre de las claves. La regla documentada es
cloud.azure.<namespace>.<MetricName>, con el tipo de recurso en minúsculas. De ahí se deducecloud.azure.microsoft_network.loadbalancers.UsedSnatPorts, pero la página no lo escribe literalmente: compruébalo. - Las mayúsculas de las dimensiones. El recolector las escribe en minúsculas:
backendipaddress,protocoltype,connectionstate.
Para comprobar la clave, esta consulta de descubrimiento, adaptada de un ejemplo de la documentación, lista lo que tu tenant recibe realmente.
metrics
| filter startsWith(metric.key, "cloud.azure.microsoft_network.loadbalancers")
| filter dt.da.source == "azure-metric-poller"
| fields metric.key, azure.subscription
| dedup metric.key
Si la integración antigua (Dynatrace Classic) sigue activa, sus claves empiezan por ext:. Mantén ambas el tiempo justo de una migración; más allá, tendrás datos duplicados y alertas repetidas.
El cálculo que importa: la tasa por instancia
Un promedio de todo el Load Balancer lo oculta: nueve máquinas tranquilas esconden a la décima, que está sin puertos. Por eso la consulta de abajo divide los puertos usados entre los asignados, instancia por instancia. Está construida con las piezas descritas en la documentación y no se ha ejecutado: pruébala primero en un Notebook.
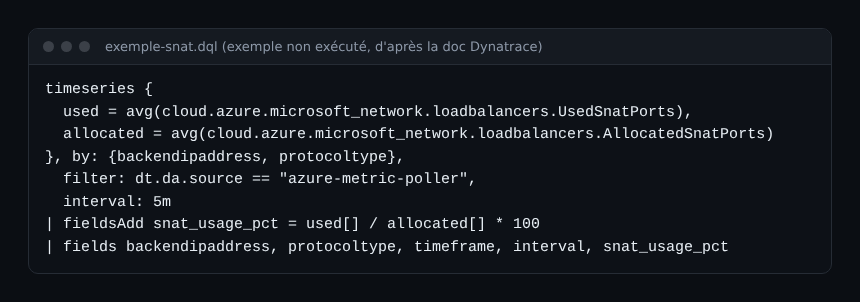
Para convertirla en alerta, la documentación remite a Settings (disponible desde la versión 1.344; la aplicación Anomaly Detection está obsoleta) y admite una consulta timeseries como origen. Fija un umbral estático sobre snat_usage_pct: 75 para el aviso y 90 para el nivel crítico, valores tomados del ejemplo de Microsoft. La segunda alerta, sobre los fallos de SnatConnectionCount, exige revisar antes cómo se escribe el valor de connectionstate en tus datos. El mecanismo completo está en crear una alerta en Dynatrace paso a paso.
Cómo comprobar que funciona
- Ejecuta la consulta de descubrimiento: deben aparecer tres claves SNAT. Si no, el conjunto «Recommended+Custom» no está activo.
- Ejecuta la consulta de la tasa: una serie por dirección de backend, con valores entre 0 y 100.
- Compara un punto con Used SNAT Ports en el portal de Azure (agregación Average, granularidad de un minuto), teniendo en cuenta el retraso de recolección.
Qué hacer cuando suena la alerta
Reiniciar las máquinas da un respiro, pero no resuelve nada. Las soluciones reales son estructurales, y Microsoft las ordena así:
- Azure NAT Gateway: el método de salida preferido por Microsoft. No tiene los mismos límites de agotamiento y tiene prioridad sobre el Load Balancer en la subred afectada.
- Asignación manual mediante regla de salida: puertos por instancia = IP de frontal × 64 000 ÷ instancias del grupo. Útil si te quedas con el Load Balancer.
- Conexiones reutilizadas: un pool de conexiones en la aplicación reduce el consumo, y su ausencia agrava el riesgo.
- Private Link hacia Storage, SQL o Cosmos DB: ese tráfico deja de pasar por SNAT.
Buenas prácticas
- Alerta por instancia, nunca sobre el promedio del Load Balancer.
- Evita la asignación por defecto en producción, algo que Microsoft desaconseja.
- Conserva el aviso del 75 %: es el margen que te ahorra la guardia.
- Toma el fallo de conexión como síntoma principal, según alertar sobre síntomas, no sobre causas, y la tasa de puertos como señal temprana.
Preguntas frecuentes
¿Cuántos puertos SNAT ofrece un Azure Load Balancer?
Según Microsoft, 64 000 por cada IP pública de frontal, menos un rango de ocho puertos por cada puerto usado en una regla de balanceo o de NAT de entrada. Con la asignación por defecto, cada instancia recibe como máximo 1024.
¿Qué métrica señala un agotamiento SNAT en Azure?
Un SnatConnectionCount en estado fallido por encima de cero confirma el agotamiento. La relación entre UsedSnatPorts y AllocatedSnatPorts lo anuncia antes de que haya fallos.
¿Hay que sustituir el Load Balancer por una NAT Gateway?
No, solo su función de salida. La NAT Gateway se encarga del tráfico saliente; el Load Balancer sigue con el entrante.
Conclusión
Para no volver a perder una noche con una avería fantasma: mide la tasa de uso de puertos por instancia, avisa al 75 %, escala al 90 % o ante fallos, y corrige la causa con una NAT Gateway o conexiones reutilizadas. Quedan por confirmar en tu entorno la clave exacta de las métricas, las mayúsculas de los valores de dimensión y el comportamiento de la alerta con datos reales.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC (ni a Microsoft). Las marcas citadas pertenecen a sus propietarios. Los servicios cambian rápido: comprueba siempre los nombres de métricas y los parámetros en la documentación oficial correspondiente a tu versión.