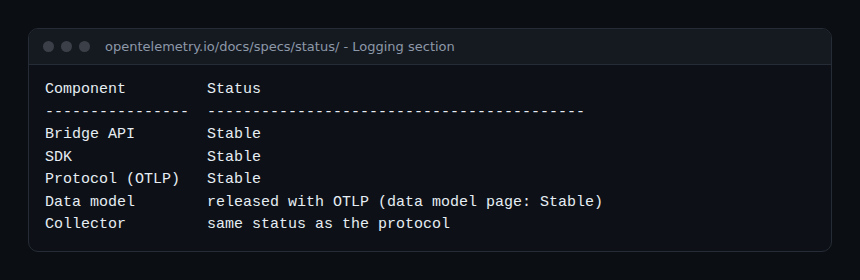
¿Cambian algo los logs OpenTelemetry estables para tu pila de logs actual? Según la página de estado de las especificaciones de OpenTelemetry, el Bridge API, el SDK y el protocolo OTLP de los logs figuran como «Stable». Para un equipo SRE o de plataforma, la pregunta ya no es «¿está listo?», sino «¿qué migrar y en qué orden?».
Este artículo ofrece una matriz de decisión: qué garantiza «estable», qué no garantiza, tres estrategias de migración y cómo verificar el resultado. Sigue al tutorial sobre la correlación logs-trazas mediante trace_id, que muestra el paso a paso técnico. Aquí se decide. Los puntos de Dynatrace se refieren a Dynatrace SaaS; para Dynatrace Managed, comprueba la documentación de tu versión.
En breve
- El Bridge API, el SDK y OTLP para logs son «Stable»; el Collector sigue el estado del protocolo (página de estado de OpenTelemetry).
- La madurez varía según el lenguaje: Java, .NET, C++, PHP y Rust son «Stable», Go está en «Release candidate», Python y JavaScript siguen en «Development».
- Nada obliga a reemplazarlo todo: OpenTelemetry pretende funcionar con los logs que ya produces.
- El mejor primer paso es el más pequeño: conservar la biblioteca de logs actual y añadir un appender de OpenTelemetry o un receiver de archivos.
Logs OpenTelemetry estables: qué significa «estable»
La página Specification Status Summary clasifica cada señal por componente. En la sección Logging, el Bridge API, el SDK y el protocolo son «Stable». El modelo de datos se publica con OTLP, y la página dedicada al modelo de datos de logs también lo muestra como «Stable». La página precisa que el estado del Collector sigue al del protocolo para cada señal.
En concreto, un estado estable en la especificación significa que el contrato del modelo y del protocolo ya no debería romperse. Un registro de log lleva, entre otros, Timestamp, TraceId, SpanId, SeverityText, SeverityNumber, Body, Resource y Attributes. La severidad es numérica: 1 a 4 para TRACE, 9 a 12 para INFO, 17 a 20 para ERROR, 21 a 24 para FATAL.
Ojo: la especificación no es la implementación. Un estado estable en la especificación no dice nada sobre la madurez de un SDK en tu lenguaje, ni sobre la de las convenciones semánticas.
Qué no garantiza el estado estable
El lenguaje lo cambia todo
La página Language APIs & SDKs da un estado por lenguaje y por señal. Para los logs, la tabla es desigual.
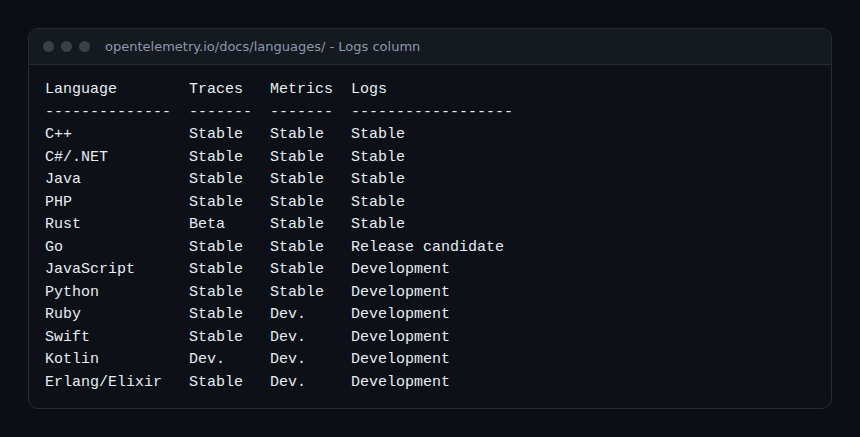
Si tus servicios están en Java o .NET, el camino del SDK es maduro. Si están en Python o JavaScript, la señal de logs sigue ahí en «Development» en la fecha de lectura de esta página: la API aún puede cambiar. Eso no impide usarla, pero obliga a fijar las versiones y a releer las notas de versión en cada actualización. El tutorial sobre la correlación usa precisamente Python: es un buen terreno de pruebas, no una base para generalizar sin salvaguardas.
Las convenciones semánticas
La misma página advierte de que las instrumentaciones que se apoyan en convenciones semánticas experimentales pueden sufrir cambios incompatibles, sea cual sea el estado de la API o del SDK. En la práctica, el nombre de un atributo puede cambiar entre dos versiones. Por eso tus consultas, alertas y dashboards deberían pasar por una capa de normalización en lugar de usar nombres sin procesar por todas partes.
El receiver de archivos
Muchas migraciones pasan por el Collector leyendo archivos. El README del receiver filelog indica un nivel «beta» para los logs. Esta mención es distinta del estado del protocolo: el protocolo es estable, este componente concreto todavía no.
Tres estrategias de migración
Estrategia 1: no cambiar nada, añadir un puente
La documentación de OpenTelemetry sobre logs recoge este principio: sigues usando tu biblioteca de logs y la configuras con un appender (o bridge) que emite hacia un exporter. El Bridge API está pensado para los autores de bibliotecas; las aplicaciones no tienen que llamarlo directamente. Ventaja: el código de la aplicación no cambia. Riesgo: el nivel de madurez depende del lenguaje (ver arriba).
La página de conceptos señala también que, una vez activa una instrumentación automática o un SDK, OpenTelemetry correlaciona los logs con la traza y el span activos. Es la ganancia más concreta: el trace_id llega sin trabajo de cruce por marca de tiempo.
Estrategia 2: conservar los archivos, leer con el Collector
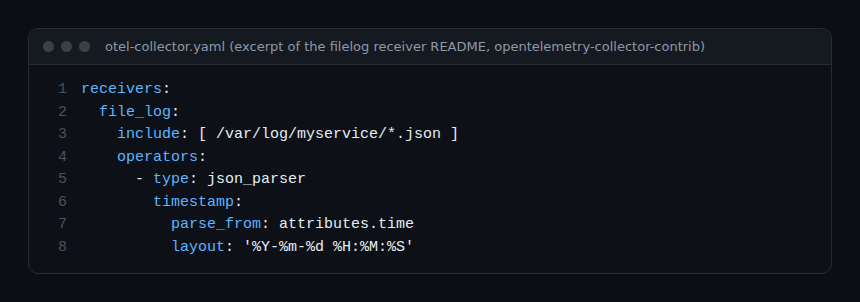
Si tus aplicaciones escriben logs JSON en archivos o en la salida estándar, el Collector puede leerlos sin tocar el código. El fragmento siguiente procede del README del receiver: lee archivos JSON y extrae la marca de tiempo.
receivers:
  file_log:
    include: [ /var/log/myservice/*.json ]
    operators:
      - type: json_parser
        timestamp:
          parse_from: attributes.time
          layout: '%Y-%m-%d %H:%M:%S'
Detalles que conviene conocer, según el README: include es obligatorio, start_at vale end por defecto (un archivo en el que ya no se escribe no se vuelve a leer) y, sin una extensión de almacenamiento (storage), las posiciones de lectura no sobreviven a un reinicio. Este último punto cuenta para la fiabilidad: reiniciar el Collector sin almacenamiento puede provocar huecos o duplicados. Los nombres del receiver varían según las versiones (filelog o file_log): alinéate con la documentación de la versión desplegada.
Estrategia 3: migración completa a OTLP
Todos los servicios emiten en OTLP, el Collector centraliza y el antiguo agente de logs desaparece. Es el objetivo más limpio, pero también el más arriesgado: acumula cambio de código, de pipeline y de destino. Se justifica cuando ya tienes trazas y métricas en OpenTelemetry, como describe el Collector de OpenTelemetry hacia Dynatrace, y la duplicación de agentes cuesta más que la migración.
Qué pasa con el destino: el ejemplo de Dynatrace
En Dynatrace SaaS, la documentación de ingesta OTLP de logs describe cómo un registro OTLP se convierte en un registro de Dynatrace: el Body alimenta content, la severidad alimenta loglevel (primero SeverityText, luego SeverityNumber, si no NONE), y TraceId y SpanId pasan a ser trace_id y span_id en hexadecimal. Los atributos del recurso, del ámbito de instrumentación y del log se fusionan. Una marca de tiempo situada más de diez minutos en el futuro se sustituye por la hora actual, y los eventos más antiguos que el límite de antigüedad se rechazan (ver la página de ingesta de logs OTLP).
Consecuencia práctica: lo que pongas en SeverityText y Body determina directamente el nivel y el contenido que verás. Para procesar, enrutar u ocultar datos después, consulta los pipelines de OpenPipeline. Si hoy pasas por un agente de terceros, Fluent Bit hacia Dynatrace en Kubernetes sigue siendo un camino válido: «estable» no obliga a nadie a migrar.
Cómo decidir: matriz de cinco preguntas
- ¿Qué lenguajes? Mayoría Java, .NET, PHP o C++: el camino del SDK está maduro. Python o JavaScript: empieza por el Collector sobre archivos, o prueba en preproducción.
- ¿Ya tienes trazas OpenTelemetry? Si es así, la correlación por
trace_idjustifica por sí sola el puente de logs. - ¿Tus logs están estructurados? La documentación de OpenTelemetry prefiere los logs estructurados en producción; los logs no estructurados son mucho más difíciles de analizar a gran escala.
- ¿Cuánto cuesta un agente más? Dos agentes en paralelo durante la transición duplican la carga y los riesgos de duplicados.
- ¿Cuál es el plan de vuelta atrás? Una migración por servicio, con posible marcha atrás, protege tu error budget.
Cómo comprobar que funciona
Tras cada lote de servicios migrados, compara los volúmenes antes y después y luego comprueba la correlación. En un Notebook de Dynatrace SaaS:
fetch logs, from: now() - 30m
| filter isNotNull(trace_id)
| summarize logs = count(), by: {loglevel}
Si el número de logs con trace_id es cero aunque los servicios estén trazados, el contexto de traza no se transmite: revisa el appender o el operador trace_parser. Para las consultas por nivel, consulta contar los errores de logs por nivel en DQL.
Buenas prácticas
- Migra servicio por servicio, midiendo el MTTR en incidentes reales, no en una demostración.
- Fija las versiones del SDK y del Collector mientras el lenguaje no sea «Stable».
- Activa un almacenamiento de posiciones para el receiver de archivos.
- No mezcles las señales: un log no es un span ni una métrica. Cada señal conserva su pipeline.
- Mantén logs estructurados: es el mejor seguro contra los cambios de formato.
Preguntas frecuentes
¿Los logs de OpenTelemetry son estables en todos los lenguajes?
No. La página de lenguajes indica «Stable» para C++, .NET, Java, PHP y Rust, «Release candidate» para Go y «Development» para Python, JavaScript, Ruby, Swift, Kotlin y Erlang/Elixir. Comprueba esa página antes de elegir el camino del SDK.
¿Hay que abandonar el agente de logs actual?
No necesariamente. OpenTelemetry afirma querer funcionar con los logs ya producidos. Un appender o el Collector pueden añadirse a lo existente, y el antiguo agente se retira servicio por servicio si el beneficio está demostrado.
¿Qué ganancia concreta aporta la migración?
La principal es la correlación nativa entre logs y trazas mediante trace_id y span_id, y después un formato de salida único (OTLP) para varios destinos. Comparar OpenTelemetry con otros enfoques es el objeto de OpenTelemetry y Prometheus, dos herramientas complementarias.
Conclusión
El estado estable de los logs de OpenTelemetry elimina el principal obstáculo de fondo: el modelo y el protocolo están fijados. No te exime de mirar el nivel de cada lenguaje ni el de los componentes del Collector. La elección razonable es progresiva: un puente o un receiver en un servicio piloto, una verificación en DQL y después la extensión.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Los estados citados son los de las páginas oficiales de OpenTelemetry y Dynatrace consultadas el 31 de octubre de 2026; cambian, compruébalos antes de cualquier decisión.