Un despliegue llega a producción y, sin causa aparente, empiezan los reinicios. O al revés: una aplicación caída sigue recibiendo tráfico. En ambos casos, las sondas liveness readiness startup suelen estar implicadas: bien configuradas protegen la disponibilidad; mal ajustadas, la degradan. Esta guía repasa las nueve trampas más habituales, todas verificadas en la documentación de Kubernetes.
Objetivo: ajustar sondas que sigan siendo acertadas bajo carga, durante el arranque y en un incidente, para no gastar el presupuesto de errores en reinicios inútiles. El contenido es Kubernetes puro: vale para cualquier clúster, esté supervisado por Dynatrace SaaS, por Dynatrace Managed o de otra forma. Para el caso vecino de los reinicios en bucle, consulte CrashLoopBackOff y OOMKilled.
Sondas liveness readiness startup: tres preguntas distintas
Cada sonda responde a una pregunta diferente, y el kubelet reacciona de forma distinta ante un fallo.
| Sonda | Pregunta planteada | Efecto de un fallo |
|---|---|---|
startupProbe |
¿Ha terminado de arrancar la aplicación? | El contenedor se mata y queda sujeto a su restartPolicy |
livenessProbe |
¿Sigue el proceso en condiciones de avanzar? | El contenedor se reinicia |
readinessProbe |
¿Puede recibir tráfico ahora? | El Pod sale de los Services, sin reinicio |
Según la documentación, mientras haya una sonda startup definida, el kubelet no ejecuta ni liveness ni readiness antes de su primer éxito. La sonda readiness, en cambio, se ejecuta durante toda la vida del contenedor. Esta es la configuración de ejemplo de la documentación, que combina las tres:
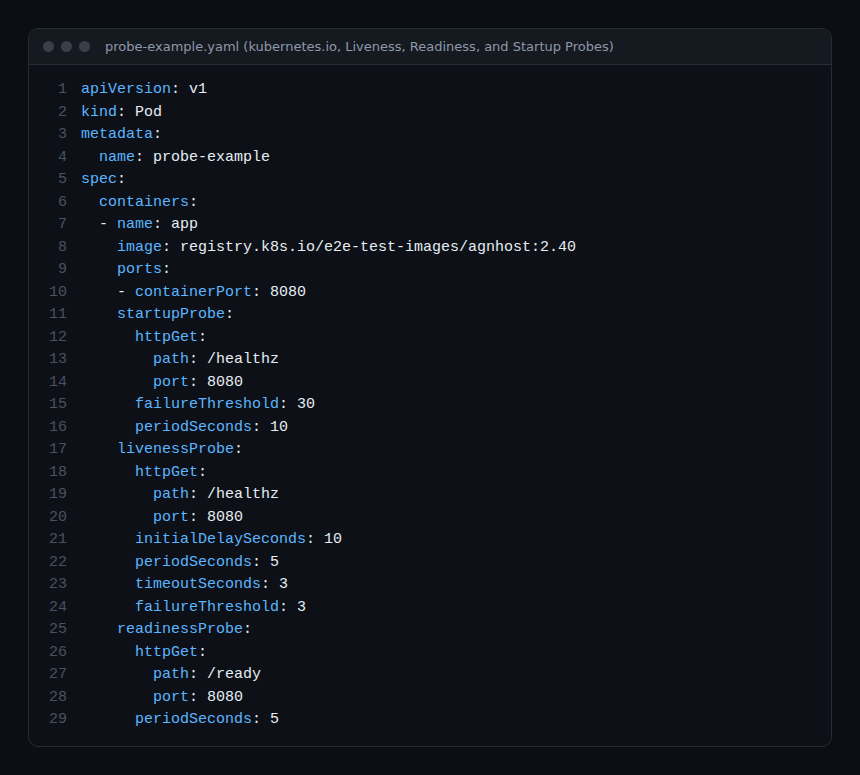
Los campos de ajuste y sus valores por defecto, según la misma documentación: initialDelaySeconds 0, periodSeconds 10, timeoutSeconds 1, successThreshold 1 (obligatoriamente 1 para liveness y startup), failureThreshold 3.
Trampa 1: una liveness que consulta las dependencias
La documentación es explícita: una sonda liveness debe señalar un fallo irrecuperable, como un deadlock. Una implementación incorrecta puede provocar fallos en cascada: reinicios bajo carga elevada, peticiones de clientes fallidas y más carga sobre los Pods restantes.
Si la liveness prueba la base de datos y esta se ralentiza, todos los Pods se reinician a la vez, cuando el reinicio no arregla nada. Reserve la prueba de las dependencias para la readiness. La documentación describe este esquema: la liveness pasa cuando la aplicación está sana; la readiness comprueba además los servicios que necesita.
Trampa 2: una aplicación lenta al arrancar sin startup probe
Sin startup probe, la liveness empieza tras initialDelaySeconds y tolera failureThreshold fallos separados por periodSeconds. Si el arranque dura más que ese total, el contenedor se mata antes de estar listo y vuelve a empezar: es el bucle de reinicio. Alargar la liveness hace más lenta la detección de un deadlock real. La documentación recomienda en su lugar una startup probe que apunte al mismo punto de acceso:
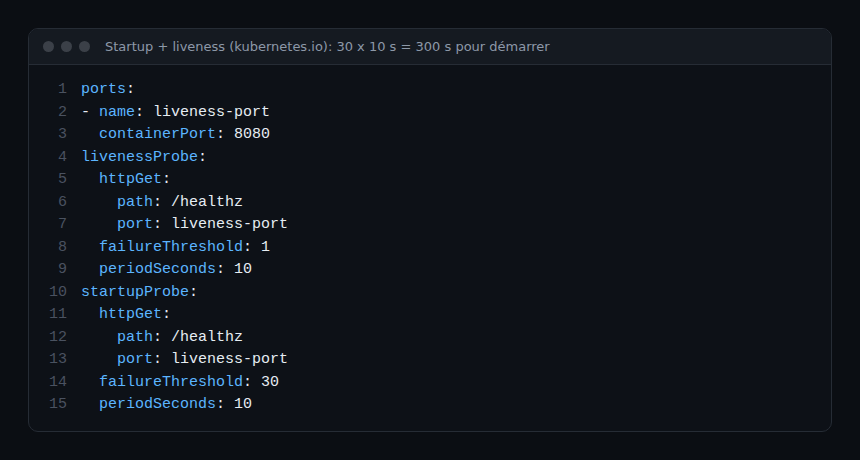
Aquí, la aplicación dispone de 300 segundos (30 x 10) para arrancar. Cuando la startup probe tiene éxito, la liveness recupera su reactividad original. Si la startup probe no llega a tener éxito, el contenedor se mata tras 300 s y queda sujeto a su restartPolicy.
Trampa 3: creer que readiness y liveness se esperan
La documentación precisa que las sondas liveness y readiness no dependen una de otra. La liveness no espera a que la readiness tenga éxito. Para aplazar una u otra, utilice initialDelaySeconds o una startup probe. Sin ello, una liveness agresiva puede matar un contenedor que aún no ha terminado de prepararse.
Trampa 4: confundir «no listo» con «caído»
Cuando la readiness falla, el kubelet deja el contenedor en ejecución y sigue sondeándolo. Pone la condición Ready del Pod en falso, y el controlador de EndpointSlice retira la dirección IP del Pod de los Services afectados. No hay ningún reinicio. Es lo previsto: la documentación cita las sobrecargas temporales y la carga de cachés entre los usos.
Dos consecuencias prácticas. Primero, un Pod 0/1 en Running no está caído: está fuera de servicio. Después, la readiness se considera fallida antes del retraso inicial: que un Pod no reciba tráfico al principio de su vida es normal. El caso de un ActiveGate bloqueado en 0/1 se detalla en ActiveGate Kubernetes not ready.
Trampa 5: el tiempo de espera de 1 segundo
El valor por defecto de timeoutSeconds es 1 segundo. Un punto de acceso que responde en 1,2 s durante un pico de carga se cuenta, por tanto, como fallo. Con una liveness, tres fallos seguidos bastan para provocar un reinicio, lo que agrava la carga. Mida la latencia real del punto de acceso bajo carga antes de fijar este campo y deje un margen.
Trampa 6: una sonda exec demasiado frecuente
La documentación advierte de que las sondas exec crean varios procesos en cada ejecución. En nodos con alta densidad de Pods y con intervalos cortos, pueden costar CPU. Los mecanismos httpGet, tcpSocket y grpc evitan ese coste. Un exec con periodSeconds: 1 sobre cien Pods es un buen candidato a sustituir.
Trampa 7: lo que valida realmente la sonda HTTP
- Un código mayor o igual que 200 y menor que 400 es un éxito: una redirección 302 pasa como un 200.
- Con
scheme: HTTPS, el kubelet no verifica el certificado. - El kubelet envía la petición a la dirección IP del Pod. Para un host virtual, defina la cabecera
HostenhttpHeadersen lugar del campohost.
Un punto de acceso que devuelve 200 sin probar nada, por ejemplo una página estática, declara sano un proceso cuyo trabajo está bloqueado. Haga que pruebe un mínimo: que el bucle principal responde y que la cola no está saturada.
Trampa 8: una liveness y una readiness idénticas
Usar el mismo punto de acceso para ambas está permitido, pero la documentación propone un patrón más seguro: el mismo punto de acceso poco costoso, con una liveness de failureThreshold más alto. Así, el Pod se observa como no listo durante cierto tiempo antes de ser eliminado, lo que deja margen para la recuperación.
Trampa 9: olvidar el plazo de parada
Cuando una liveness o una startup falla, el kubelet respeta terminationGracePeriodSeconds: 30 segundos por defecto si no se indica nada. Desde Kubernetes 1.25, este campo existe también a nivel de sonda (estable desde 1.28) y prevalece sobre el del Pod. La API lo rechaza para una readiness.
Cómo comprobar que funciona
Los fallos de sonda dejan eventos. Léalos antes de modificar nada:
kubectl describe pod <pod> -n <namespace>
kubectl get events -n <namespace> --field-selector reason=Unhealthy
La documentación de Kubernetes muestra la traza típica de una liveness que falla:
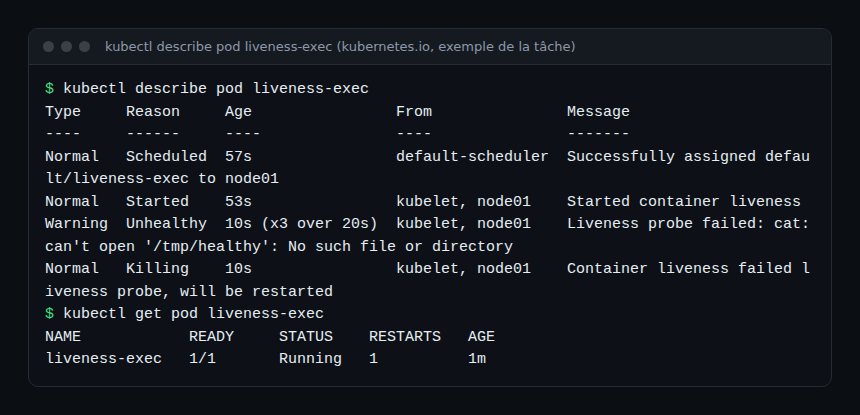
- Las líneas Liveness probe failed o Readiness probe failed dejan de aparecer tras su corrección.
- La columna RESTARTS de
kubectl get podsse estabiliza. - La columna READY llega a
1/1y el Pod vuelve a recibir tráfico.
En la supervisión, vigile los reinicios y los Pods no listos en lugar de las propias sondas: véanse las alertas de Kubernetes sobre nodos, pods y cuotas. Las mediciones de latencia del punto de acceso, útiles para fijar timeoutSeconds, pertenecen a la métrica de la aplicación; la diferencia entre señal de salud y observabilidad se plantea en observabilidad y monitorización.
Buenas prácticas
- Liveness mínima: solo detecta lo que un reinicio puede reparar.
- Dependencias externas únicamente en la readiness.
- Startup probe en cuanto el arranque supere
initialDelaySeconds + failureThreshold x periodSeconds. - Plazos fijados a partir de mediciones, no de valores copiados.
- Tras cada cambio de sonda, releer los eventos durante un despliegue progresivo.
Preguntas frecuentes
¿Hace falta una liveness probe en cada contenedor?
No. Según la documentación, si el proceso se cae por sí mismo ante un problema, una liveness no es necesaria: el kubelet ya aplica la restartPolicy.
¿Qué diferencia hay entre startup y readiness?
La startup probe solo actúa al arrancar y provoca que se mate el contenedor si falla. La readiness actúa durante toda la vida del contenedor y solo retira el Pod del tráfico. La documentación sugiere la readiness si quiere distinguir una aplicación que falla de una que aún está cargando sus datos.
¿Por qué mi Pod está en Running pero en 0/1?
Su readiness falla: el contenedor se ejecuta, pero el Pod está fuera de los Services. Lea los eventos Readiness probe failed para conocer el código o el error devuelto.
Conclusión
Las sondas liveness readiness startup no se ajustan de una vez por todas: reflejan lo que el equipo sabe del comportamiento de la aplicación. Bastan tres reflejos para evitar lo esencial de los incidentes: una liveness sobria, una readiness que cargue con las dependencias y una startup probe para los arranques lentos.
Este artículo procede de un blog independiente, no afiliado a Dynatrace LLC ni a los proyectos citados. Los comportamientos descritos son los de la documentación de Kubernetes consultada en octubre de 2026; compruébelos para la versión de su clúster. Dynatrace es una marca de Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios.