Kronos modelo de fundación: el repositorio shiyu-coder/Kronos publica una familia de modelos preentrenados con velas financieras (series OHLCV, llamadas «K-lines» en el README) para producir previsiones de series temporales de mercado. El proyecto muestra unas 43 000 estrellas y 7 100 forks en la fecha de revisión, el 22 de octubre de 2026, bajo licencia MIT. Esta guía trata de la herramienta, no de las finanzas: no contiene ningún consejo de inversión ni promesa de rentabilidad, y nada de lo que aquí se dice indica que un modelo prediga bien los mercados.
¿Por qué hablar de ello en un blog de observabilidad? Porque un modelo de previsión es un componente de producción como cualquier otro: tiene una latencia, un consumo de memoria de GPU, entradas que validar y una calidad que se degrada. Aquí tienes cómo leerlo, instalarlo según el README y hacerle seguimiento.
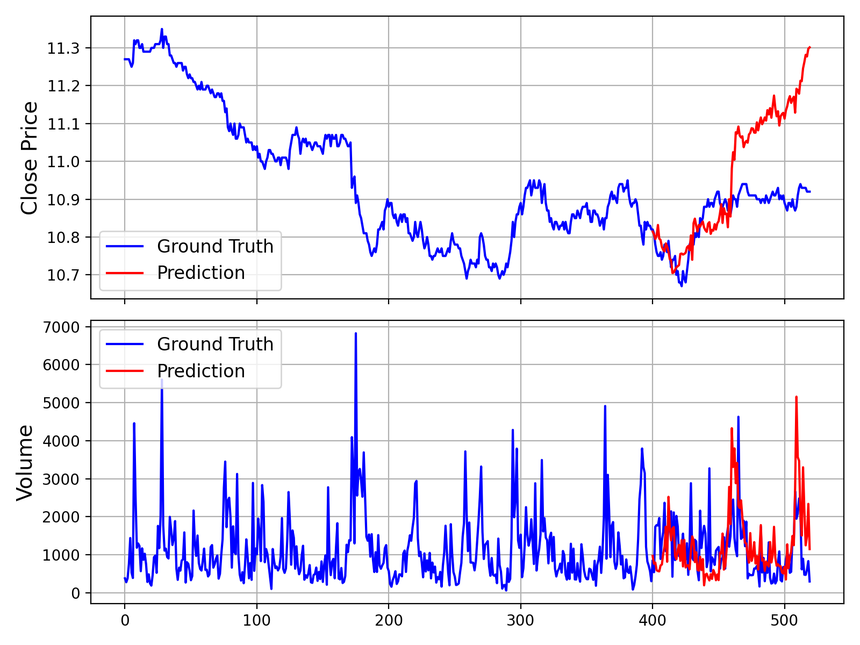
Aclaración de honestidad: span.observer no ha instalado ni ejecutado Kronos. Los comandos proceden del README, las dos primeras imágenes son figuras del repositorio y la tercera es un extracto de código del README.
Kronos modelo de fundación para los mercados financieros: qué dice el repositorio
- Licencia: MIT (archivo LICENSE del repositorio). Lenguaje: Python; dependencias listadas en
requirements.txt(entre ellastorch>=2.0.0,pandas,huggingface_hub,safetensors). - Cifras revisadas el 22 de octubre de 2026: unas 43 000 estrellas, unos 7 100 forks. No hay ninguna release publicada en la página del repositorio. El último commit de la rama principal que hemos revisado es del 13 de abril de 2026: el repositorio no se ha movido, por tanto, desde hace varios meses, lo que importa para el mantenimiento.
- Quién está detrás: un grupo de investigadores; el README remite a un artículo en arXiv (2508.02739) e indica su aceptación en la conferencia AAAI 2026. Son afirmaciones del README, que no hemos verificado con la conferencia.
- Lo que afirma el proyecto: ser «el primer modelo de fundación de código abierto» para velas, entrenado con datos de más de 45 bolsas mundiales.
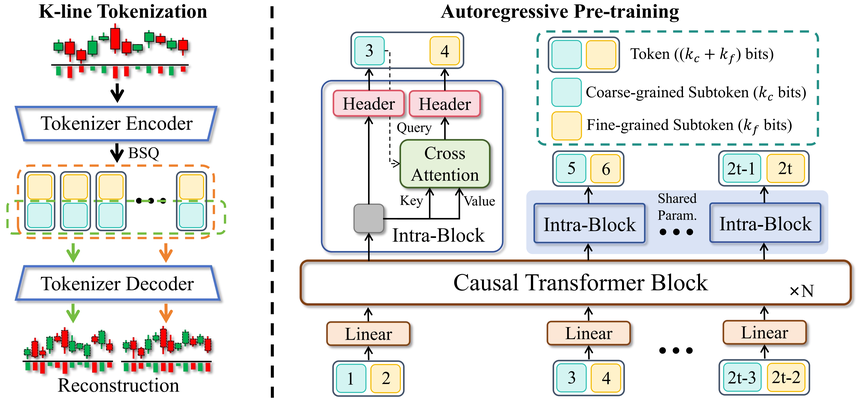
El principio, según el README: un tokenizer cuantifica los datos continuos y multidimensionales (open, high, low, close, volume) en tokens discretos jerárquicos, y después se preentrena sobre esos tokens un gran Transformer autorregresivo de tipo «decoder-only».
La familia de modelos
El README lista cuatro tamaños, todos accesibles desde Hugging Face (espacio NeoQuasar) salvo el más grande:
- Kronos-mini: 4,1 M de parámetros, contexto de 2048; tokenizer Kronos-Tokenizer-2k.
- Kronos-small: 24,7 M de parámetros, contexto de 512.
- Kronos-base: 102,3 M de parámetros, contexto de 512.
- Kronos-large: 499,2 M de parámetros, contexto de 512, no publicado (marcado con una cruz en la tabla del README).
Instalación paso a paso
- Instalar Python 3.10 o más reciente (requisito del README) y después clonar el repositorio.
- Instalar las dependencias:
pip install -r requirements.txt - Cargar el tokenizer y un modelo desde Hugging Face y después crear el predictor:
from model import Kronos, KronosTokenizer, KronosPredictor tokenizer = KronosTokenizer.from_pretrained("NeoQuasar/Kronos-Tokenizer-base") model = Kronos.from_pretrained("NeoQuasar/Kronos-small") predictor = KronosPredictor(model, tokenizer, max_context=512) - Preparar un DataFrame de pandas con las columnas
open,high,low,close(volumeyamountson opcionales), la serie de fechas históricasx_timestampy las fechas que se quieren prevery_timestamp. - Llamar a
predict:
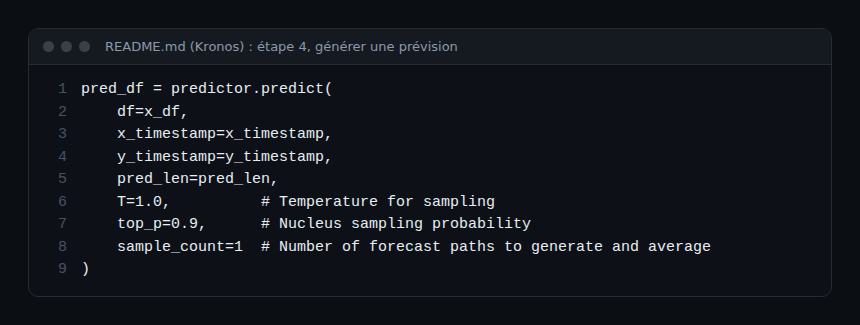
El README precisa que max_context vale 512 para Kronos-small y Kronos-base y recomienda no superar esa longitud de histórico; T regula la temperatura de muestreo, top_p el núcleo de muestreo y sample_count el número de trayectorias generadas y luego promediadas. El método devuelve un DataFrame con los valores previstos. Un método predict_batch procesa varias series en paralelo, siempre que tengan la misma longitud de histórico y de previsión.
Qué se ve del funcionamiento
El script examples/prediction_example.py produce un gráfico que compara los valores reales («Ground Truth») y la previsión. La figura de abajo es la del README. Mírala sin hacerle decir más de lo que muestra: al final de la ventana, la curva prevista se aleja claramente de la curva real. Es un ejemplo ilustrativo de un proyecto de investigación, no una medida de rendimiento.
La carpeta webui/ contiene una interfaz web Flask: cd webui y después python run.py, con una página en la dirección http://localhost:7070 según su README. Permite cargar un archivo de datos, elegir el modelo y el dispositivo (CPU, CUDA o MPS), ajustar temperatura, top_p y número de muestras, y mostrar el resultado en velas. El README propone también una demostración en línea y un pipeline de fine-tuning con Qlib sobre datos de acciones chinas.
Límites y puntos abiertos
- Sin consejo, sin garantía: el propio README califica su pipeline de fine-tuning y de backtest como demostración, «no un sistema de trading cuantitativo listo para producción». Un backtest sin costes de transacción, deslizamiento (slippage) ni impacto de mercado no dice nada de la realidad.
- Tamaño de contexto: 512 puntos para los modelos small y base; si es más largo, la entrada se trunca.
- Mantenimiento: ninguna release publicada, último commit revisado en abril de 2026.
- Comentarios generados: el README indica que muchos comentarios de la carpeta
finetune/fueron redactados por un asistente de IA y pueden contener errores; el código es la referencia. - Datos y licencias: tus datos de mercado tienen sus propias condiciones de licencia, independientes de la licencia MIT del código.
Observar un modelo de previsión
Kronos no es un servicio: es una biblioteca Python a la que llamas. El README no describe métricas ni trazas. Te toca instrumentar la llamada, tanto para Dynatrace SaaS como para Dynatrace Managed, con OpenTelemetry (consulta instrumentar una aplicación Python con OpenTelemetry):
- un span alrededor de cada llamada a
predict, con el nombre del modelo,pred_lenysample_countcomo atributos; - unas métricas: duración de la inferencia, tamaño del lote y memoria de GPU máxima (la API de PyTorch
torch.cuda.max_memory_allocatedla proporciona); - la calidad a lo largo del tiempo: cuando llegan los valores reales, calcula la diferencia con la previsión (por ejemplo el error absoluto medio) y publícala como métrica. Una deriva de esa diferencia es la señal de alerta, no solo la latencia;
- unos logs de entrada: número de filas, columnas que faltan, rango de fechas, para detectar datos incompletos antes de la inferencia.
Estas mediciones son nuestra propuesta, no una función del proyecto. Para el seguimiento de costes y calidad de otros modelos, consulta la observabilidad de LLM con Langfuse y OpenLLMetry.
Cómo comprobar que funciona
pip install -r requirements.txttermina sin error yimport torchfunciona.- La carga de los modelos desde Hugging Face tiene éxito; la primera llamada descarga los pesos.
- El script
examples/prediction_example.pyproduce un gráfico con la curva de previsión. - Tu backend de OpenTelemetry muestra un span por predicción, con su duración.
Buenas prácticas
- Trata la salida como una hipótesis estadística, nunca como una decisión automática.
- Fija las versiones del modelo y del tokenizer (revisión de Hugging Face) y anótalas en tus spans.
- Valida las entradas: mismas longitudes para
predict_batch, sin valores ausentes. - Compara la previsión con una base sencilla antes de darle importancia.
- Para otros modelos que servir en producción, consulta vLLM, la inferencia de LLM en producción.
Preguntas frecuentes
¿Puede Kronos hacerme ganar dinero?
Esta guía no hace ninguna promesa de rentabilidad. El README presenta su pipeline como una demostración, y una previsión de serie temporal no es una estrategia. No es asesoramiento financiero.
¿Hace falta una GPU?
La interfaz web ofrece CPU, CUDA y MPS según su README. El proyecto no da, en lo que hemos leído, ninguna medida de rendimiento por hardware: prueba primero los modelos pequeños.
¿Puedo usarlo en un producto comercial?
El código está bajo licencia MIT, que lo autoriza con mención del copyright. Comprueba por separado la licencia indicada en cada modelo de Hugging Face y la de tus datos.
Conclusión
Kronos es un proyecto de investigación abierto, útil para entender cómo se pueden «tokenizar» velas y tratarlas como un lenguaje. En explotación se trata como cualquier modelo: entradas validadas, versiones fijadas, latencia y deriva de calidad medidas. Para otra pieza de la serie, consulta Hindsight, la memoria de los agentes de IA. Fuentes: repositorio shiyu-coder/Kronos.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Este artículo no constituye asesoramiento financiero. Las herramientas evolucionan rápido: comprueba los comandos y las opciones en su documentación oficial.