Kronos modèle fondation : le dépôt shiyu-coder/Kronos publie une famille de modèles pré-entraînés sur des chandeliers financiers (séries OHLCV, appelées « K-lines » dans le README) pour produire des prévisions de séries temporelles de marché. Le projet affiche environ 43 000 étoiles et 7 100 forks à la date de relecture, le 22 octobre 2026, sous licence MIT. Ce guide traite de l’outil, pas de la finance : il ne contient aucun conseil d’investissement ni promesse de rendement, et rien ici ne dit qu’un modèle prédit bien les marchés.
Pourquoi en parler sur un blog d’observabilité ? Parce qu’un modèle de prévision est un composant de production comme un autre : il a une latence, une consommation de mémoire GPU, des entrées à valider et une qualité qui se dégrade. Voici comment le lire, l’installer d’après le README et le suivre.
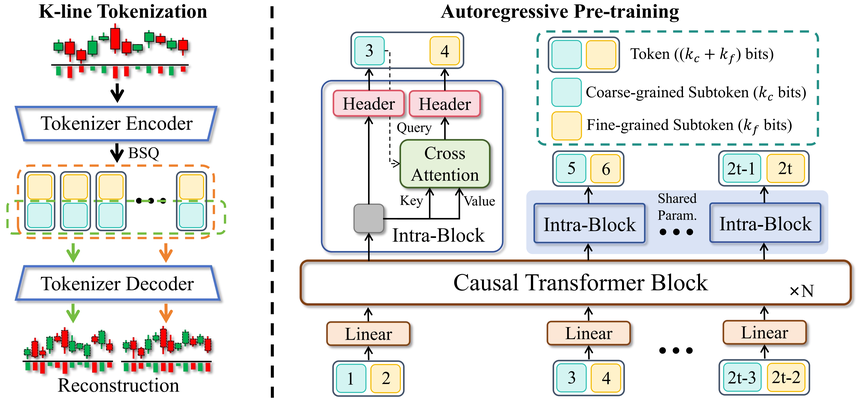
Précision d’honnêteté : span.observer n’a pas installé ni exécuté Kronos. Les commandes viennent du README, les deux premières images sont des figures du dépôt, la troisième est un extrait de code du README.
Kronos modèle fondation pour les marchés financiers : ce que dit le dépôt
- Licence : MIT (fichier LICENSE du dépôt). Langage : Python ; dépendances listées dans
requirements.txt(donttorch>=2.0.0,pandas,huggingface_hub,safetensors). - Chiffres relus le 22 octobre 2026 : environ 43 000 étoiles, environ 7 100 forks. Aucune release n’est publiée sur la page du dépôt. Le dernier commit de la branche principale que nous avons relu date du 13 avril 2026 : le dépôt n’a donc pas bougé depuis plusieurs mois, ce qui compte pour la maintenance.
- Qui est derrière : un groupe de chercheurs ; le README renvoie à un article sur arXiv (2508.02739) et indique son acceptation à la conférence AAAI 2026. Ce sont des affirmations du README, que nous n’avons pas vérifiées auprès de la conférence.
- Ce que le projet affirme : être « le premier modèle de fondation open source » pour les chandeliers, entraîné sur des données de plus de 45 bourses mondiales.
Le principe, d’après le README : un tokenizer quantifie les données continues et multidimensionnelles (open, high, low, close, volume) en jetons discrets hiérarchiques, puis un grand Transformer autorégressif de type « decoder-only » est pré-entraîné sur ces jetons.
La famille de modèles
Le README liste quatre tailles, toutes accessibles depuis Hugging Face (espace NeoQuasar) sauf la plus grande :
- Kronos-mini : 4,1 M de paramètres, contexte de 2048 ; tokenizer Kronos-Tokenizer-2k.
- Kronos-small : 24,7 M de paramètres, contexte de 512.
- Kronos-base : 102,3 M de paramètres, contexte de 512.
- Kronos-large : 499,2 M de paramètres, contexte de 512, non publié (marqué d’une croix dans le tableau du README).
Installation pas à pas
- Installer Python 3.10 ou plus récent (prérequis du README), puis cloner le dépôt.
- Installer les dépendances :
pip install -r requirements.txt - Charger le tokenizer et un modèle depuis Hugging Face, puis créer le prédicteur :
from model import Kronos, KronosTokenizer, KronosPredictor tokenizer = KronosTokenizer.from_pretrained("NeoQuasar/Kronos-Tokenizer-base") model = Kronos.from_pretrained("NeoQuasar/Kronos-small") predictor = KronosPredictor(model, tokenizer, max_context=512) - Préparer un DataFrame pandas avec les colonnes
open,high,low,close(volumeetamountsont facultatives), la série de dates historiquesx_timestampet les dates à prévoiry_timestamp. - Appeler
predict:
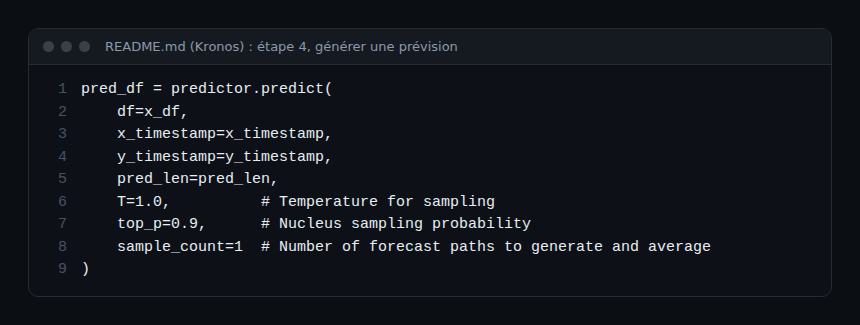
Le README précise que max_context vaut 512 pour Kronos-small et Kronos-base et recommande de ne pas dépasser cette longueur d’historique ; T règle la température d’échantillonnage, top_p le noyau d’échantillonnage et sample_count le nombre de trajectoires générées puis moyennées. La méthode renvoie un DataFrame avec les valeurs prévues. Une méthode predict_batch traite plusieurs séries en parallèle, à condition qu’elles aient la même longueur d’historique et de prévision.
Ce que l’on voit du fonctionnement
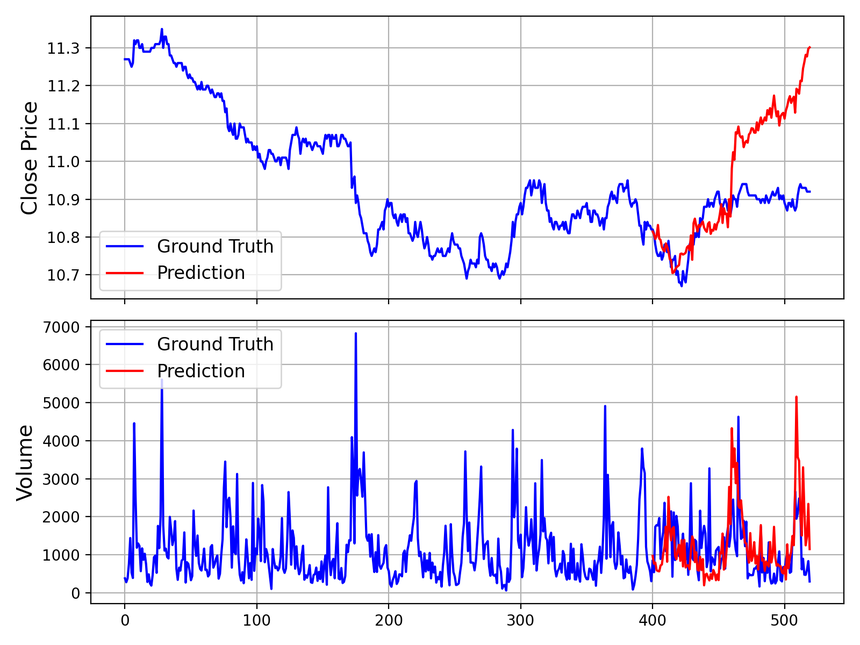
Le script examples/prediction_example.py produit un graphique qui compare les valeurs réelles (« Ground Truth ») et la prévision. La figure ci-dessous est celle du README. Regardez-la sans lui faire dire plus qu’elle ne montre : sur la fin de la fenêtre, la courbe prévue s’éloigne nettement de la courbe réelle. C’est un exemple illustratif d’un projet de recherche, pas une mesure de performance.
Le dossier webui/ contient une interface web Flask : cd webui puis python run.py, avec une page à l’adresse http://localhost:7070 d’après son README. Elle permet de charger un fichier de données, de choisir le modèle et le périphérique (CPU, CUDA ou MPS), de régler température, top_p et nombre d’échantillons, et d’afficher le résultat en chandeliers. Le README propose aussi une démonstration en ligne et un pipeline de fine-tuning avec Qlib sur des données d’actions chinoises.
Limites et points ouverts
- Pas de conseil, pas de garantie : le README lui-même qualifie son pipeline de fine-tuning et de backtest de démonstration, « pas un système de trading quantitatif prêt pour la production ». Un backtest sans coûts de transaction, glissement ni impact de marché ne dit rien du réel.
- Taille de contexte : 512 points pour les modèles small et base ; plus long, l’entrée est tronquée.
- Maintenance : pas de release publiée, dernier commit relu en avril 2026.
- Commentaires générés : le README indique que de nombreux commentaires du dossier
finetune/ont été rédigés par un assistant IA et peuvent contenir des erreurs ; le code fait foi. - Données et licences : vos données de marché ont leurs propres conditions de licence, indépendantes de la licence MIT du code.
Observer un modèle de prévision
Kronos n’est pas un service : c’est une bibliothèque Python que vous appelez. Le README ne décrit ni métriques ni traces. À vous d’instrumenter l’appel, pour Dynatrace SaaS comme pour Dynatrace Managed, avec OpenTelemetry (voir instrumenter une application Python avec OpenTelemetry) :
- un span autour de chaque appel à
predict, avec en attributs le nom du modèle,pred_lenetsample_count; - des métriques : durée d’inférence, taille du lot, et mémoire GPU pic (l’API PyTorch
torch.cuda.max_memory_allocatedla fournit) ; - la qualité dans le temps : quand les valeurs réelles arrivent, calculez l’écart avec la prévision (par exemple l’erreur absolue moyenne) et publiez-le comme métrique. Une dérive de cet écart est le signal d’alerte, pas la latence seule ;
- des logs d’entrée : nombre de lignes, colonnes manquantes, plage de dates, pour repérer les données incomplètes avant l’inférence.
Ces mesures sont notre proposition, pas une fonction du projet. Pour le suivi des coûts et de la qualité d’autres modèles, voir l’observabilité LLM avec Langfuse et OpenLLMetry.
Comment vérifier que ça fonctionne
pip install -r requirements.txtse termine sans erreur etimport torchfonctionne.- Le chargement des modèles depuis Hugging Face réussit ; le premier appel télécharge les poids.
- Le script
examples/prediction_example.pyproduit un graphique avec la courbe de prévision. - Votre backend OpenTelemetry affiche un span par prédiction, avec sa durée.
Bonnes pratiques
- Traitez la sortie comme une hypothèse statistique, jamais comme une décision automatique.
- Figez les versions du modèle et du tokenizer (révision Hugging Face) et notez-les dans vos spans.
- Validez les entrées : mêmes longueurs pour
predict_batch, pas de valeurs manquantes. - Comparez la prévision à une base simple avant d’y accorder de l’importance.
- Pour d’autres modèles à servir en production, voir vLLM, l’inférence LLM en production.
Questions fréquentes
Kronos peut-il me faire gagner de l’argent ?
Ce guide ne fait aucune promesse de rendement. Le README présente son pipeline comme une démonstration, et une prévision de série temporelle n’est pas une stratégie. Ce n’est pas un conseil financier.
Faut-il un GPU ?
L’interface web propose CPU, CUDA et MPS selon son README. Le projet ne donne pas, dans ce que nous avons lu, de mesure de performance par matériel : testez les petits modèles d’abord.
Puis-je l’utiliser dans un produit commercial ?
Le code est sous licence MIT, qui l’autorise avec mention du copyright. Vérifiez séparément la licence affichée sur chaque modèle Hugging Face et celle de vos données.
Conclusion
Kronos est un projet de recherche ouvert, utile pour comprendre comment on peut « tokeniser » des chandeliers et les traiter comme un langage. En exploitation, il se traite comme n’importe quel modèle : entrées validées, versions figées, latence et dérive de qualité mesurées. Pour une autre pièce de la série, voir Hindsight, mémoire des agents IA. Sources : dépôt shiyu-coder/Kronos.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Cet article ne constitue pas un conseil financier. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.