Módulo 5 del curso de métricas de Dynatrace Managed: las métricas de proceso builtin, las de los runtimes (JVM, .NET, Node.js, Go), los contenedores y Kubernetes, en 24 fichas con clave exacta, unidad, caso de uso y selector listo para pegar.
Curso: Formación en métricas de Dynatrace Managed · Módulo 5/7 · Tipo: referencia · Plataforma: Dynatrace Managed (métricas clásicas)
En este módulo:
- una tabla resumen de las 24 claves, para tener a mano
- una ficha por métrica: qué mide, cuándo usarla, la trampa que evitar
- un metric selector por ficha, que se puede probar en el Data Explorer
Cuando un host va mal, la pregunta siguiente es siempre la misma: ¿qué proceso, qué JVM, qué contenedor? Las métricas de este módulo responden a esa pregunta. Se sitúan por debajo del servicio y por encima del host, y son las que acortan el diagnóstico, y con él el MTTR, cuando una alerta de infraestructura salta de madrugada.
Todo lo que sigue vale para Dynatrace Managed: claves builtin:, metric selector, API Metrics v2 y Data Explorer. Aquí no hay ni Grail ni DQL. En Dynatrace SaaS, las mismas medidas llevan claves dt.process.*, dt.runtime.* o dt.kubernetes.*; se tratan en el curso de métricas de SaaS.
Este módulo enlaza el módulo 2 sobre los hosts con el módulo 3 sobre los servicios. Aquí vamos directos a la ficha.
Las métricas de proceso builtin en una tabla
Todas las claves, unidades y agregaciones siguientes proceden de la lista oficial de métricas integradas de Dynatrace Managed. La columna «Ámbito» recoge la sección de la documentación; las dimensiones exactas se leen en el descriptor de cada métrica.
| Clave | Unidad | Agregaciones | Ámbito | Qué mide |
|---|---|---|---|---|
builtin:tech.generic.cpu.usage |
Percent (%) | avg, max, min | Proceso | CPU del proceso, en % de la CPU del host |
builtin:tech.generic.mem.workingSetSize |
Byte | avg, max, min | Proceso | Memoria utilizada por el proceso |
builtin:tech.generic.mem.exhaustedMem |
Count | value | Proceso | Eventos «Memory resource exhausted» |
builtin:tech.generic.handles.fileDescriptorsPercentUsed |
Percent (%) | avg, max, min | Proceso (Linux) | % del límite de descriptores de archivo |
builtin:tech.generic.network.packets.retransmission |
Percent (%) | avg, max, min | Proceso (red) | % de paquetes retransmitidos |
builtin:tech.generic.network.sessions.reset |
Per second | avg, max, min | Proceso (red) | Sesiones TCP entrantes reiniciadas |
builtin:tech.generic.processCount |
Count | avg, max, min | Proceso | Número de procesos workers |
builtin:pgi.availability.state |
Count | value | Instancia de proceso | Estado de disponibilidad del proceso, por minuto |
builtin:tech.jvm.memory.pool.used |
Byte | avg, max, min | JVM | Memoria utilizada por pool del heap |
builtin:tech.jvm.memory.gc.suspensionTime |
Percent (%) | avg, max, min | JVM | Parte del tiempo en pausa de GC |
builtin:tech.jvm.memory.gc.collectionTime |
Millisecond | value | JVM | Tiempo acumulado de recolección, todos los pools |
builtin:tech.jvm.threads.count |
Count | avg, max, min | JVM | Threads vivos de la JVM |
builtin:tech.dotnet.gc.timePercentage |
Percent (%) | avg, max, min | .NET | % del tiempo pasado en el GC de .NET |
builtin:tech.dotnet.threadpool.queuedWorkItems |
Count | avg, max, min | .NET | Elementos en espera en el pool de threads |
builtin:tech.nodejs.uvLoop.loopLatency |
Nanosecond | avg, max, min | Node.js | Latencia del bucle de eventos |
builtin:tech.nodejs.v8heap.used |
Byte | avg, max, min | Node.js | Heap de V8 ocupado por los datos |
builtin:tech.go.memory.heap.live |
Byte | avg, max, min | Go | Heap de Go considerado vivo por el GC |
builtin:containers.cpu.throttledMilliCores |
Millicores | avg, max, min | Contenedor | Limitación (throttling) de CPU del contenedor |
builtin:containers.memory.limitPercent |
Percent (%) | avg | Contenedor | Límite de memoria, en % de la memoria física |
builtin:containers.memory.outOfMemoryKills |
Count | value | Contenedor | Paradas por exceso de memoria (OOM kills) |
builtin:kubernetes.container.restarts |
Count | value | Kubernetes (contenedor) | Reinicios de contenedores |
builtin:kubernetes.node.requests_cpu |
Millicores | avg, max, min | Kubernetes (nodo) | Requests de CPU de los pods, por nodo |
builtin:kubernetes.workload.pods_desired |
Count | avg, max, min | Kubernetes (workload) | Pods deseados por workload |
builtin:kubernetes.persistentvolumeclaim.used |
Byte | avg, max, min | Kubernetes (PVC) | Bytes utilizados en el volumen |
Cómo leer una ficha
Cada ficha sigue el mismo orden: qué mide la métrica, un caso de uso concreto, una trampa y después un selector. Los selectors desglosan por dt.entity.process_group_instance cuando la métrica se refiere a un proceso, y solo usan las transformaciones documentadas (splitBy, sort, limit, agregaciones). Los umbrales mencionados son referencias que debes calibrar con tu histórico, no valores oficiales.
Procesos: CPU, memoria, red y disponibilidad
builtin:tech.generic.cpu.usage
Suma del tiempo de CPU de todos los workers del proceso, relacionada con la CPU disponible del host: 100 % significa que el proceso consume todo el host. Es la primera métrica que abrir cuando builtin:host.cpu.usage sube: dice qué proceso es el responsable. Caso de uso: clasificar los diez procesos más voraces de un host saturado. Trampa: en un host de 16 núcleos, un proceso de un solo thread se queda en torno al 6 %; una cifra baja no prueba la ausencia de cuello de botella.
builtin:tech.generic.cpu.usage:splitBy("dt.entity.process_group_instance"):sort(value(avg,descending)):limit(10)builtin:tech.generic.mem.workingSetSize
Suma de la memoria utilizada por cada worker, memoria compartida incluida. La documentación la presenta como la herramienta para detectar a los grandes consumidores y las fugas. Caso de uso: una curva en dientes de sierra que no vuelve nunca al mismo nivel tras cada reinicio señala una fuga probable. Trampa: la memoria compartida se cuenta, así que sumar varios procesos de un mismo host sobrestima el total.
builtin:tech.generic.mem.workingSetSize:splitBy("dt.entity.process_group_instance"):sort(value(max,descending)):limit(10)builtin:tech.generic.mem.exhaustedMem
Número de eventos «Memory resource exhausted» emitidos por los workers en un minuto; la JVM los genera cuando le falta memoria. Caso de uso: todo valor no nulo en una JVM de producción merece un análisis, a menudo antes del OutOfMemoryError visible en los logs. Trampa: la ausencia de punto no significa cero; comprueba que el proceso es realmente una JVM monitorizada en profundidad.
builtin:tech.generic.mem.exhaustedMem:splitBy("dt.entity.process_group_instance")builtin:tech.generic.handles.fileDescriptorsPercentUsed
Mayor porcentaje del límite de descriptores de archivo utilizado entre los workers, en Linux. Caso de uso: un servidor que abre conexiones sin cerrarlas se acerca lentamente al 100 % y después falla con «Too many open files». Una alerta mucho antes del límite deja tiempo para actuar. Trampa: la métrica no existe en Windows.
builtin:tech.generic.handles.fileDescriptorsPercentUsed:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.generic.network.packets.retransmission
Porcentaje de paquetes TCP retransmitidos para el proceso, medido por el análisis de red de OneAgent. Caso de uso: un servicio lento sin causa de aplicación visible; un aumento de las retransmisiones apunta a la red (pérdida, saturación, MTU) más que al código. Trampa: con un volumen bajo de paquetes, unas pocas retransmisiones dan un porcentaje espectacular; míralo junto con el tráfico.
builtin:tech.generic.network.packets.retransmission:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.generic.network.sessions.reset
Número por segundo de sesiones TCP entrantes terminadas por un error de reinicio (RST). Caso de uso: tras un cambio de balanceador de carga o de firewall, un aumento repentino delata conexiones cortadas a mitad de camino. Trampa: algunos clientes cierran voluntariamente con RST; compara con un periodo de referencia en lugar de con cero.
builtin:tech.generic.network.sessions.reset:splitBy("dt.entity.process_group_instance"):avgbuiltin:tech.generic.processCount
Número de workers de un proceso (Apache, PHP-FPM, IIS…). La documentación recuerda que un número demasiado bajo degrada el rendimiento y que uno demasiado alto desperdicia recursos. Caso de uso: comprobar que el pool escala realmente durante un pico. Trampa: no lo confundas con builtin:tech.generic.count, que cuenta los procesos de un grupo.
builtin:tech.generic.processCount:splitBy("dt.entity.process_group_instance"):maxbuiltin:pgi.availability.state
Estado de disponibilidad de la instancia de proceso, publicado cada minuto. Caso de uso: construir un SLO de disponibilidad de un componente sin depender del tráfico, o detectar los reinicios nocturnos. Trampa: es un estado, no un porcentaje; lee el descriptor para conocer la dimensión de estado antes de filtrar.
builtin:pgi.availability.state:splitBy("dt.entity.process_group_instance")Tecnologías: JVM, .NET, Node.js y Go
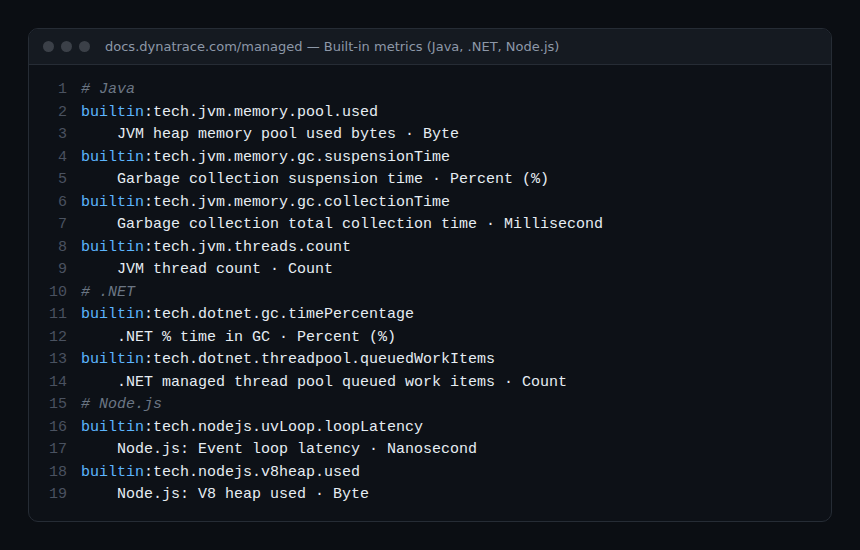
builtin:tech.jvm.memory.pool.used
Memoria ocupada actualmente en cada pool de la JVM (Eden, Survivor, Old Gen según el recolector). Caso de uso: el Old Gen que vuelve a subir tras cada recolección mayor es el signo clásico de una fuga. Trampa: el Eden oscila de forma natural entre vacío y lleno; sumar todos los pools oculta la única curva que importa.
builtin:tech.jvm.memory.pool.used:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.jvm.memory.gc.suspensionTime
Tiempo pasado entre el inicio y el final de las pausas del recolector de basura, expresado en porcentaje. Es la métrica que une el GC con la percepción del usuario: durante una pausa, la aplicación no responde. Caso de uso: correlacionar picos de tiempo de respuesta con picos de suspensión. Trampa: una media sobre una hora suaviza las pausas largas; usa max.
builtin:tech.jvm.memory.gc.suspensionTime:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.jvm.memory.gc.collectionTime
Tiempo aproximado pasado recolectando, con todos los pools juntos. Caso de uso: comparar dos versiones de una aplicación o dos ajustes de recolector con la misma carga. Trampa: la documentación de SaaS señala que esta clave diverge de su equivalente en Grail para los procesos Go; en Managed, ciñete a la clave builtin: y a su descriptor.
builtin:tech.jvm.memory.gc.collectionTime:splitBy("dt.entity.process_group_instance")builtin:tech.jvm.threads.count
Número de threads vivos, demonios incluidos. Caso de uso: un crecimiento continuo delata un pool sin límite o threads que nunca se liberan, antes de que la JVM se quede sin memoria nativa. Trampa: un número alto y estable es normal en un servidor de aplicaciones; lo que cuenta es la tendencia.
builtin:tech.jvm.threads.count:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.dotnet.gc.timePercentage
Porcentaje del tiempo pasado en el recolector de basura del CLR. Caso de uso: una aplicación ASP.NET que se ralentiza bajo carga mientras la CPU del host sigue siendo razonable; un % de GC alto orienta hacia las asignaciones (cadenas, objetos grandes) más que hacia la base de datos. Trampa: léela junto con el consumo del heap de objetos grandes (LOH), a menudo implicado.
builtin:tech.dotnet.gc.timePercentage:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.dotnet.threadpool.queuedWorkItems
Número de elementos de trabajo en cola en el pool de threads gestionado. Caso de uso: la cola que crece mientras se disparan los tiempos de respuesta es la firma de una saturación del pool, a menudo debida a llamadas bloqueantes dentro de código asíncrono. Trampa: una cola breve durante un pico es normal; alerta sobre una cola que dura.
builtin:tech.dotnet.threadpool.queuedWorkItems:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.nodejs.uvLoop.loopLatency
Latencia media entre el momento en que se espera un evento y aquel en que se procesa. Como Node.js es de un solo thread, un bucle bloqueado retrasa todas las peticiones. Caso de uso: detectar un procesamiento síncrono costoso (JSON voluminoso, cifrado) introducido por una nueva versión. Trampa: la unidad es el nanosegundo; convierte antes de comparar con tiempos de respuesta en milisegundos.
builtin:tech.nodejs.uvLoop.loopLatency:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.nodejs.v8heap.used
Tamaño del heap de V8 ocupado por los datos de la aplicación, medido por instantánea periódica. Caso de uso: un aumento continuo hasta el techo del heap precede a las caídas «heap out of memory». Trampa: compárala con builtin:tech.nodejs.v8heap.total; solo el margen entre ambas informa del riesgo.
builtin:tech.nodejs.v8heap.used:splitBy("dt.entity.process_group_instance"):maxbuiltin:tech.go.memory.heap.live
Memoria considerada viva por el recolector de basura de Go: lo que retuvo la última recolección, más lo asignado desde entonces. Caso de uso: seguir la huella real de un servicio Go tras una subida de versión. Trampa: la memoria del proceso vista por el sistema operativo es más alta, porque el runtime conserva páginas inactivas.
builtin:tech.go.memory.heap.live:splitBy("dt.entity.process_group_instance"):maxContenedores y Kubernetes
builtin:containers.cpu.throttledMilliCores
CPU denegada al contenedor por su límite, en milicores. Caso de uso: un contenedor lento mientras el host tiene CPU libre; una limitación no nula muestra que el cuello de botella es el límite, no la máquina. Trampa: sin un límite de CPU definido, no hay limitación que medir.
builtin:containers.cpu.throttledMilliCores:sort(value(max,descending)):limit(10)builtin:containers.memory.limitPercent
Límite de memoria del contenedor relacionado con la memoria física del host; vacío si no se ha fijado ningún límite. Caso de uso: hacer el inventario de los contenedores sin límite, los que pueden dejar sin recursos a sus vecinos. Trampa: un valor ausente es aquí una información, no un hueco de recogida de datos.
builtin:containers.memory.limitPercent:sort(value(avg,descending))builtin:containers.memory.outOfMemoryKills
Número de paradas del contenedor por el kernel por exceso de memoria. Caso de uso: explicar reinicios sin rastro en los logs de la aplicación; todo valor no nulo se trata como un incidente. Trampa: en Kubernetes, cruza esta métrica con builtin:kubernetes.container.oom_kills, que aporta el contexto del workload.
builtin:containers.memory.outOfMemoryKillsbuiltin:kubernetes.container.restarts
Delta del contador restartCount del estado del contenedor; solo se escribe cuando ha habido al menos un reinicio. Caso de uso: detectar un CrashLoopBackOff antes de que un usuario se queje. Trampa: la ausencia de datos es el caso normal, no un fallo de recogida.
builtin:kubernetes.container.restartsbuiltin:kubernetes.node.requests_cpu
Suma de los requests de CPU de los contenedores de aplicación de los pods, agregada por nodo. Caso de uso: comparada con builtin:kubernetes.node.cpu_allocatable, dice cuánto espacio le queda al planificador, con independencia del consumo real. Trampa: un nodo «lleno» en requests puede estar casi ocioso; es un asunto de dimensionamiento, no de carga.
builtin:kubernetes.node.requests_cpu:sort(value(max,descending))builtin:kubernetes.workload.pods_desired
Número de pods esperados: el campo replicas de un deployment, o desiredNumberScheduled de un daemon set. Caso de uso: comparada con el número de pods en marcha, revela un despliegue bloqueado o un autoscaler en su techo. Trampa: es una intención, no un estado; no baja cuando los pods fallan.
builtin:kubernetes.workload.pods_desired:maxbuiltin:kubernetes.persistentvolumeclaim.used
Bytes utilizados en el volumen de una persistent volume claim. Caso de uso: relacionada con builtin:kubernetes.persistentvolumeclaim.capacity, anticipa el volumen lleno de una base de datos o de un broker. Trampa: un volumen lleno no siempre hace caer el pod; la aplicación puede limitarse a dejar de escribir.
builtin:kubernetes.persistentvolumeclaim.used:sort(value(max,descending)):limit(10)Cómo comprobar que funciona
- Abre el Data Explorer, pasa al modo Code y pega un selector de una ficha: debe mostrarse un gráfico en pocos segundos.
- Si la respuesta está vacía, lee el descriptor:
GET /api/v2/metrics/builtin:tech.jvm.threads.countcon un token que lleve el scopemetrics.read. Lista unidad, agregaciones y dimensiones. - Para las métricas de runtime, comprueba en la pantalla del proceso que la monitorización en profundidad está activa y que el proceso se reinició tras instalar OneAgent.
- Para Kubernetes, confirma que el clúster está monitorizado por el operador de Dynatrace; sin él, las claves
builtin:kubernetes.*quedan vacías.
curl -s -H "Authorization: Api-Token $DT_TOKEN" \
  "https://managed.example.com/e/ENV-ID/api/v2/metrics/query?metricSelector=builtin:tech.jvm.threads.count:max&from=now-2h"
Buenas prácticas
- Parte del síntoma: CPU de host alta →
builtin:tech.generic.cpu.usage; JVM lenta → suspensión de GC; reinicios → OOM kills y restarts. - Alerta sobre la duración en lugar de sobre un pico: GC, cola de .NET y particiones infrarreplicadas tienen todos picos normales.
- Guarda los selectors en el repositorio de tus dashboards, como se describe en el artículo sobre los tiles JSON de los dashboards de Managed.
Preguntas frecuentes
¿Por qué una métrica de JVM sigue vacía en mi proceso Java?
Las claves builtin:tech.jvm.* exigen la monitorización en profundidad del proceso. Un proceso iniciado antes de OneAgent, o excluido por una regla, solo informa de las métricas genéricas builtin:tech.generic.*.
¿Qué diferencia hay entre builtin:containers.* y builtin:kubernetes.*?
Las primeras vienen de OneAgent en el host y describen el contenedor (CPU, memoria, limitación). Las segundas vienen de la monitorización de Kubernetes y describen los objetos del clúster (nodos, workloads, cuotas, volúmenes). Para diagnosticar un pod se cruzan ambas, como en el diagnóstico de CrashLoopBackOff y OOMKilled.
¿Funcionan estas claves en Dynatrace SaaS?
En la interfaz clásica de SaaS, sí. En Grail, los equivalentes llevan claves dt.* y se consultan con DQL, con diferencias de cálculo señaladas a veces por la documentación de migración.
Con estas 24 fichas puedes bajar del host al proceso, al runtime y al contenedor sin buscar la clave. El módulo siguiente cubre el cloud, la virtualización y las extensiones.
← Módulo 4: aplicaciones y sintético · Índice del curso · Módulo 6: cloud y extensiones →
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Este módulo es una selección comentada: la referencia sigue siendo la documentación oficial de tu versión de Dynatrace Managed, donde debes verificar cada clave, unidad y agregación.