Módulo 6 del curso de métricas de Dynatrace Managed: las métricas cloud de Managed, de vSphere a AWS, Azure, OpenStack y Cloud Foundry, y después las métricas aportadas por las extensiones y las integraciones tecnológicas, en 22 fichas.
Curso: Formación en métricas de Dynatrace Managed · Módulo 6/7 · Tipo: referencia · Plataforma: Dynatrace Managed (métricas clásicas)
En este módulo:
- una tabla resumen de las 22 claves
- una ficha por métrica, con caso de uso y trampa
- las condiciones de recogida: integración con vCenter, AWS, Azure, extensiones
Una VM lenta no siempre tiene el problema dentro de la VM. El CPU ready, el swap del hipervisor o la latencia de un datastore compartido son invisibles desde el sistema operativo invitado. Estas métricas dan el punto de vista de la capa inferior, la que explica los incidentes en los que «no ha cambiado nada» del lado de la aplicación.
El contenido vale para Dynatrace Managed y las métricas clásicas builtin:. Estas métricas solo aparecen si la integración correspondiente está configurada: conexión con vCenter, cuenta de AWS o suscripción de Azure, extensión activada. En Dynatrace SaaS con Grail, una parte existe con claves dt.cloud.*; otras, como la disponibilidad de los hosts ESXi, no se recogen allí.
Para la ingesta de CloudWatch, consulta también el artículo sobre AWS CloudWatch; para escribir tu propia extensión, el ejemplo de PostgreSQL.
Las métricas cloud de Managed en una tabla
Claves, unidades y agregaciones tomadas de la lista oficial de métricas integradas. El ámbito sigue la sección de la documentación; las dimensiones exactas figuran en el descriptor.
| Clave | Unidad | Agregaciones | Ámbito | Qué mide |
|---|---|---|---|---|
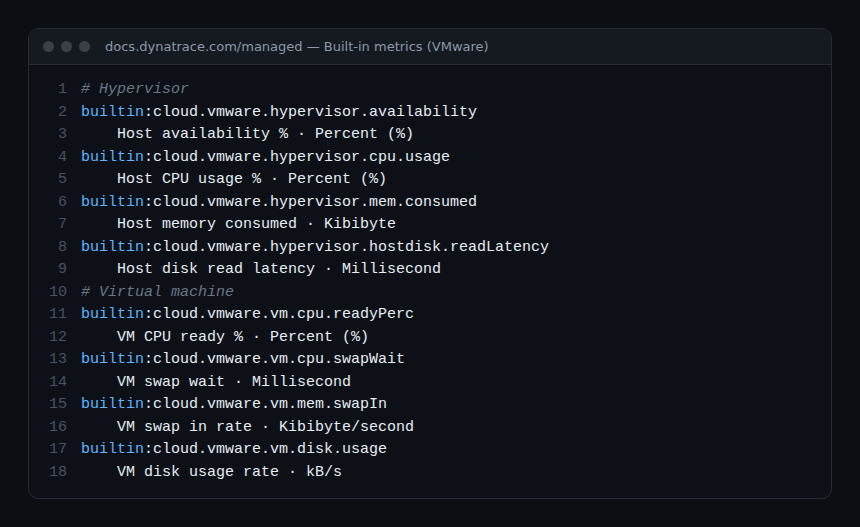
builtin:cloud.vmware.hypervisor.availability |
Percent (%) | avg | VMware (host ESXi) | Disponibilidad del host ESXi |
builtin:cloud.vmware.hypervisor.cpu.usage |
Percent (%) | avg, max, min | VMware (host ESXi) | CPU del host ESXi |
builtin:cloud.vmware.hypervisor.mem.consumed |
Kibibyte | avg, max, min | VMware (host ESXi) | Memoria consumida en el host ESXi |
builtin:cloud.vmware.hypervisor.mem.swapIn |
Kibibyte/second | avg, max, min | VMware (host ESXi) | Caudal de swap-in del host |
builtin:cloud.vmware.hypervisor.hostdisk.readLatency |
Millisecond | avg, max, min | VMware (disco del host) | Latencia de lectura de disco del host |
builtin:cloud.vmware.hypervisor.hostdisk.writeLatency |
Millisecond | avg, max, min | VMware (disco del host) | Latencia de escritura de disco del host |
builtin:cloud.vmware.hypervisor.nic.packetsRxDropped |
Count | value | VMware (tarjeta de red) | Paquetes recibidos descartados |
builtin:cloud.vmware.hypervisor.vms.count |
Count | avg, max, min | VMware (host ESXi) | Número de VM por host |
builtin:cloud.vmware.vm.cpu.readyPerc |
Percent (%) | avg, max, min | VMware (VM) | CPU ready de la VM |
builtin:cloud.vmware.vm.cpu.usagePerc |
Percent (%) | avg, max, min | VMware (VM) | CPU de la VM vista por el hipervisor |
builtin:cloud.vmware.vm.cpu.swapWait |
Millisecond | value | VMware (VM) | Espera de swap de la VM |
builtin:cloud.vmware.vm.mem.swapIn |
Kibibyte/second | avg, max, min | VMware (VM) | Caudal de swap-in de la VM |
builtin:cloud.vmware.vm.disk.usage |
kB/s | avg, max, min | VMware (VM) | Caudal de disco de la VM |
builtin:cloud.aws.az.running |
Count | avg, max, min | AWS (zona de disponibilidad) | Instancias EC2 en marcha por zona |
builtin:cloud.azure.region.vms.running |
Count | avg, max, min | Azure (región) | VM activas por región de Azure |
builtin:cloud.azure.vmScaleSet.vms.stopped |
Count | avg, max, min | Azure (scale set) | VM detenidas en un scale set |
builtin:cloud.openstack.vm.cpu.usage |
Percent (%) | avg, max, min | OpenStack (VM) | CPU de las VM de OpenStack |
builtin:cloud.cloudfoundry.http.responses5xx |
Count | value | Cloud Foundry | Respuestas 5xx del router de Cloud Foundry |
builtin:tech.customDevice.count |
Count | value | Extensiones (dispositivos) | Número de dispositivos personalizados |
builtin:tech.nginx.upstream.unhealthy |
Count | avg, max, min | Tecnología NGINX Plus | Servidores upstream de NGINX Plus en fallo |
builtin:tech.kafka.pg.kafka.server.ReplicaManager.UnderReplicatedPartitions.Value |
Count | avg, count, max, min, sum | Tecnología Kafka | Particiones infrarreplicadas (broker) |
builtin:tech.rabbitmq.cluster_messages_ready |
Count | avg, count, max, min, sum | Tecnología RabbitMQ | Mensajes listos en el clúster |
Cómo leer una ficha
Mismo orden que en los demás módulos: la medida, un caso de uso, una trampa, un selector. Los selectors no recurren a ninguna dimensión no documentada: ordenan y limitan, y tú añades un splitBy una vez leídas las dimensiones en el descriptor. Las métricas de recuento con agregación value se dan sin transformación de agregación.
VMware: hosts ESXi
builtin:cloud.vmware.hypervisor.availability
Disponibilidad del host ESXi vista por la integración con vCenter. Caso de uso: un SLO de infraestructura por clúster de vSphere, o la explicación de una oleada de VM no disponibles. Trampa: la documentación de SaaS clasifica esta clave entre las métricas de VMware no recogidas en Grail; sigue siendo propia de las métricas clásicas.
builtin:cloud.vmware.hypervisor.availability:avgbuiltin:cloud.vmware.hypervisor.cpu.usage
Utilización de CPU del hipervisor, con todas las VM juntas. Caso de uso: saber si una VM lenta sufre por un host físico saturado; léela junto con el CPU ready de las VM. Trampa: un host al 60 % puede penalizar ya a VM con muchos vCPU; la cifra global no basta.
builtin:cloud.vmware.hypervisor.cpu.usage:sort(value(max,descending)):limit(10)builtin:cloud.vmware.hypervisor.mem.consumed
Memoria física del host consumida por las VM y el hipervisor. Caso de uso: verificar el margen antes de añadir VM o de poner un host en mantenimiento (sus VM migran a los demás). Trampa: la unidad es el kibibyte; un gráfico sin conversión parece mil veces demasiado grande.
builtin:cloud.vmware.hypervisor.mem.consumed:sort(value(max,descending)):limit(10)builtin:cloud.vmware.hypervisor.mem.swapIn
Caudal al que el host vuelve a leer en memoria páginas que se habían intercambiado antes a disco. Caso de uso: un swap-in sostenido señala una sobreasignación de memoria que ralentiza todas las VM del host. Trampa: un swap-in puntual tras un pico pasado no es una urgencia; lo que cuenta es la duración.
builtin:cloud.vmware.hypervisor.mem.swapIn:maxbuiltin:cloud.vmware.hypervisor.hostdisk.readLatency
Latencia de las lecturas en los discos y datastores vistos por el host. Caso de uso: decidir si la lentitud de una base de datos se debe a una consulta mal escrita o a un almacenamiento compartido degradado. Trampa: un umbral fijo se calibra con tu cabina de almacenamiento; ninguna cifra universal vale para todos los soportes.
builtin:cloud.vmware.hypervisor.hostdisk.readLatency:sort(value(max,descending)):limit(10)builtin:cloud.vmware.hypervisor.hostdisk.writeLatency
La contrapartida de la anterior para las escrituras. Caso de uso: los logs de transacciones y las colas de mensajes son sensibles a la escritura; un aumento suele explicar confirmaciones lentas. Trampa: las cachés de escritura de la cabina ocultan los problemas hasta que se saturan, y entonces la latencia se dispara de golpe.
builtin:cloud.vmware.hypervisor.hostdisk.writeLatency:sort(value(max,descending)):limit(10)builtin:cloud.vmware.hypervisor.nic.packetsRxDropped
Paquetes recibidos y descartados después por las tarjetas de red físicas del host. Caso de uso: unas retransmisiones elevadas del lado de los procesos (módulo 5) encuentran a veces su causa aquí. Trampa: es un contador; léelo como un número de eventos por intervalo, no como un nivel.
builtin:cloud.vmware.hypervisor.nic.packetsRxDroppedbuiltin:cloud.vmware.hypervisor.vms.count
Número de máquinas virtuales alojadas en el host. Caso de uso: verificar el equilibrio de un clúster tras una operación de DRS o un mantenimiento. Trampa: el número no dice nada del tamaño de las VM; cruza con la CPU y la memoria del host.
builtin:cloud.vmware.hypervisor.vms.count:maxVMware: máquinas virtuales
builtin:cloud.vmware.vm.cpu.readyPerc
Parte del tiempo en que la VM estaba lista para ejecutarse sin obtener CPU física. Es la medida más directa de la contención. Caso de uso: una aplicación lenta cuya CPU en el invitado parece normal; un ready alto muestra que espera al hipervisor. Trampa: el sistema operativo invitado no ve este tiempo; solo lo expone la integración con VMware.
builtin:cloud.vmware.vm.cpu.readyPerc:sort(value(max,descending)):limit(10)builtin:cloud.vmware.vm.cpu.usagePerc
Utilización de CPU de la VM medida desde vSphere. Caso de uso: localizar las VM sobredimensionadas, casi ociosas, que conviene reducir para liberar el host. Trampa: el valor puede diferir de builtin:host.cpu.usage medido por OneAgent en el invitado; son dos puntos de vista.
builtin:cloud.vmware.vm.cpu.usagePerc:sort(value(avg,ascending)):limit(20)builtin:cloud.vmware.vm.cpu.swapWait
Tiempo que pasa la VM esperando páginas intercambiadas por el hipervisor. Caso de uso: confirma que una sobreasignación de memoria del host afecta de verdad a esta VM. Trampa: todo valor duradero es anormal en una VM de producción; no lo ahogues en una media diaria.
builtin:cloud.vmware.vm.cpu.swapWaitbuiltin:cloud.vmware.vm.mem.swapIn
Caudal de swap-in a nivel de VM. Caso de uso: identificar qué VM pagan la sobreasignación señalada por builtin:cloud.vmware.hypervisor.mem.swapIn. Trampa: se trata del swap del hipervisor, distinto del swap del sistema operativo invitado que ve OneAgent.
builtin:cloud.vmware.vm.mem.swapIn:sort(value(max,descending)):limit(10)builtin:cloud.vmware.vm.disk.usage
Caudal de entrada/salida de disco de la VM. Caso de uso: encontrar la VM «vecina ruidosa» que satura un datastore compartido en el momento en que sube la latencia del host. Trampa: la unidad mostrada es kB/s; verifícala en el descriptor antes de cualquier conversión.
builtin:cloud.vmware.vm.disk.usage:sort(value(max,descending)):limit(10)Cloud público y privado: AWS, Azure, OpenStack, Cloud Foundry
builtin:cloud.aws.az.running
Número de instancias EC2 en marcha por zona de disponibilidad, procedente de la integración con AWS. Caso de uso: verificar que un grupo de autoscaling sigue repartido entre zonas, condición de la resiliencia. Trampa: es la única clave de AWS de la lista builtin:; las métricas de CloudWatch de los servicios de AWS dependen de la integración cloud y tienen sus propias claves, que se leen en el navegador de métricas.
builtin:cloud.aws.az.running:maxbuiltin:cloud.azure.region.vms.running
Número de VM activas en una región de Azure. Caso de uso: seguir un plan de recuperación que traslada cargas de una región a otra. Trampa: solo se cuentan las suscripciones configuradas en la integración con Azure.
builtin:cloud.azure.region.vms.running:maxbuiltin:cloud.azure.vmScaleSet.vms.stopped
Número de VM detenidas en un grupo de máquinas virtuales idénticas (scale set). Caso de uso: un valor que sigue siendo no nulo fuera de la ventana de mantenimiento indica instancias que no vuelven a arrancar. Trampa: léela junto con builtin:cloud.azure.vmScaleSet.vms.running para obtener la proporción.
builtin:cloud.azure.vmScaleSet.vms.stopped:maxbuiltin:cloud.openstack.vm.cpu.usage
Utilización de CPU de las VM de una nube privada OpenStack, vista por la integración. Caso de uso: localizar las instancias saturadas de un proyecto sin agente en el invitado. Trampa: si OneAgent también se ejecuta en la VM, prefiere sus métricas de host, más ricas.
builtin:cloud.openstack.vm.cpu.usage:sort(value(max,descending)):limit(10)builtin:cloud.cloudfoundry.http.responses5xx
Número de respuestas 5xx, que según la documentación indican aplicaciones que se caen repetidamente o responden mal. Caso de uso: un indicador de salud de la plataforma, que conviene relacionar con los despliegues. Trampa: es un contador bruto; relaciónalo con builtin:cloud.cloudfoundry.http.totalRequests para obtener una tasa.
builtin:cloud.cloudfoundry.http.responses5xxExtensiones y tecnologías integradas
builtin:tech.customDevice.count
Número de dispositivos personalizados (custom devices) creados por las extensiones e integraciones: equipos de red, appliances, sistemas de terceros. Caso de uso: verificar tras una actualización de extensión que todos los dispositivos esperados siguen informando. Trampa: una bajada silenciosa suele ser un problema de autenticación de la extensión, no una avería del dispositivo.
builtin:tech.customDevice.countbuiltin:tech.nginx.upstream.unhealthy
Número de servidores upstream declarados en fallo por NGINX Plus. Caso de uso: saber que un balanceador sirve el tráfico con un pool mermado, antes de que los tiempos de respuesta lo noten. Trampa: la métrica concierne a NGINX Plus y supone activada la monitorización correspondiente; NGINX de código abierto no expone estos contadores.
builtin:tech.nginx.upstream.unhealthy:maxbuiltin:tech.kafka.pg.kafka.server.ReplicaManager.UnderReplicatedPartitions.Value
Número de particiones cuyas réplicas no están todas sincronizadas en el broker. Caso de uso: la métrica de Kafka más vigilada; un valor no nulo duradero significa que la caída de otro broker podría perder datos. Trampa: sube brevemente durante un reinicio planificado; alerta sobre la duración.
builtin:tech.kafka.pg.kafka.server.ReplicaManager.UnderReplicatedPartitions.Value:maxbuiltin:tech.rabbitmq.cluster_messages_ready
Número de mensajes listos para entregarse y a la espera de consumidores, a escala del clúster de RabbitMQ. Caso de uso: una cola que no deja de crecer señala consumidores demasiado lentos o detenidos. Trampa: un stock estable y alto puede ser deliberado (procesamiento por lotes); compara con la tendencia habitual.
builtin:tech.rabbitmq.cluster_messages_ready:maxCómo comprobar que funciona
- En los ajustes del entorno, comprueba que la integración está conectada (vCenter, AWS, Azure) o que la extensión está activa, sin error de autenticación.
- Lanza la consulta de listado filtrada por prefijo para ver las claves realmente disponibles en tu entorno:
curl -s -H "Authorization: Api-Token $DT_TOKEN" \
"https://managed.example.com/e/ENV-ID/api/v2/metrics?metricSelector=builtin:cloud.vmware.*&fields=unit,aggregationTypes"- Pega después un selector de una ficha en el Data Explorer (modo Code). Una serie vacía cuando la clave aparece en la lista significa, en general, que la entidad monitorizada no existe en el periodo elegido.
Buenas prácticas
- Combina las capas: CPU ready (VMware) +
builtin:host.cpu.usage(OneAgent) evita concluir demasiado pronto que hay un problema de aplicación. - Vigila la propia recogida: una integración que pierde sus permisos hace desaparecer series sin alerta; un seguimiento de
builtin:tech.customDevice.countlo revela. - Reduce el ruido alertando sobre la duración, como se explica en el artículo sobre el ruido de las alertas de Davis.
Preguntas frecuentes
¿Hace falta un ActiveGate para las métricas de VMware en Managed?
Sí: la monitorización de vCenter pasa por un ActiveGate de entorno que consulta la API de vSphere. Comprueba las versiones compatibles en la documentación de tu versión de Managed.
¿Por qué tan pocas claves de AWS builtin?
La lista builtin: solo contiene unos pocos contadores de inventario. Las métricas de los servicios de AWS proceden de la integración con CloudWatch y se descubren en el navegador de métricas del entorno.
¿Las métricas de extensión también son builtin?
Algunas tecnologías integradas (Kafka, RabbitMQ, NGINX Plus) publican claves builtin:tech.*. Las extensiones que instalas publican sus propias claves, definidas en su manifiesto.
Del host a la VM y al cloud, ya tienes una clave verificada para cada pregunta habitual de operaciones. El último módulo muestra cómo consultar estas claves con el metric selector y la API, y convertirlas en alertas.
← Módulo 5: procesos y contenedores · Índice del curso · Módulo 7: consultar y alertar →
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Este módulo es una selección comentada: la referencia sigue siendo la documentación oficial de tu versión de Dynatrace Managed, donde debes verificar cada clave, unidad y agregación.