Observabilidad vs monitorización: el debate vuelve en cada equipo que renueva sus herramientas, a menudo contaminado por el marketing. Unos presentan la observabilidad como un «monitoring 2.0», otros como una simple palabra nueva. Ambas lecturas hacen perder tiempo, porque ocultan una diferencia real de método, que se ve justo cuando un incidente no se parece a nada conocido.
La monitorización (monitoring) responde a preguntas formuladas de antemano: ¿la CPU supera el 90 %? ¿el sitio responde? La observabilidad permite hacer preguntas que no se habían previsto, a partir de los datos que emite el sistema. Las dos son necesarias; el error consiste en creer que una sustituye a la otra.
Esta guía da una definición clara de cada concepto, una tabla comparativa y después un método concreto en cinco pasos para pasar de una monitorización por umbrales a una práctica de observabilidad, con ejemplos para Dynatrace Managed y Dynatrace SaaS.
Definiciones: monitorización y observabilidad
La monitorización (monitoring)
La monitorización consiste en vigilar indicadores elegidos de antemano y avisar cuando salen de un rango esperado. Responde a la pregunta «¿funciona?». Se basa sobre todo en métricas: valores numéricos agregados en el tiempo, como la tasa de errores, el uso de CPU o el volumen de peticiones. Es eficaz para las averías conocidas: disco lleno, servicio detenido, certificado caducado.
La observabilidad
El primer de OpenTelemetry define la observabilidad como la capacidad de entender un sistema desde el exterior, haciéndole preguntas sin conocer su funcionamiento interno. Sirve para tratar los problemas inéditos, los «unknown unknowns», y para responder a «¿por qué ocurre esto?». Condición: la aplicación debe estar instrumentada y emitir señales, trazas, métricas y logs. El mismo texto considera que una aplicación está bien instrumentada cuando los desarrolladores no necesitan añadir instrumentación para diagnosticar un problema.
Observabilidad vs monitorización: la tabla comparativa
| Criterio | Monitorización | Observabilidad |
|---|---|---|
| Pregunta típica | ¿Funciona? | ¿Por qué no funciona, y para quién? |
| Preguntas | Definidas de antemano (umbrales, sondas) | Formuladas después, sobre datos ricos |
| Señales principales | Métricas, comprobaciones de disponibilidad | Trazas, métricas, logs y eventos relacionados entre sí |
| Contexto | Un valor por componente | Atributos por petición: servicio, ruta, versión, usuario |
| Punto fuerte | Detectar rápido una avería conocida | Explicar una avería desconocida |
| Límite | Ciega ante lo que no se ha previsto | Exige instrumentación y disciplina con los atributos |
La monitorización dice que hay un problema; la observabilidad ayuda a encontrar cuál. Un SRE necesita las dos: la primera reduce el tiempo de detección, la segunda el tiempo de diagnóstico, y juntas hacen bajar el MTTR.
Cómo se ve en pantalla
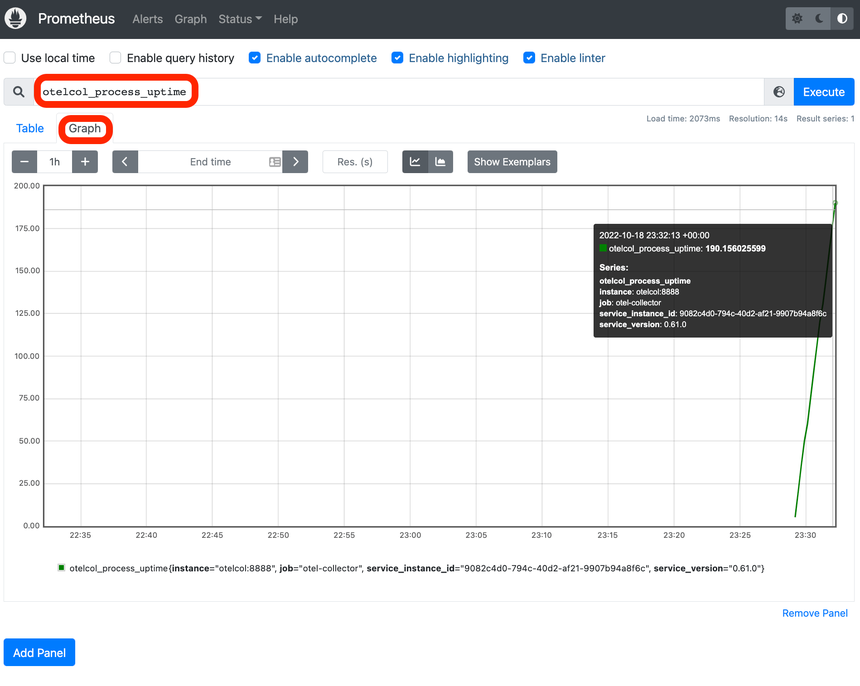
Una vista de monitorización típica: una métrica, una curva, un umbral. La captura siguiente procede de la demo de OpenTelemetry (documentación con licencia CC BY 4.0) y muestra una serie de Prometheus.
Una vista de observabilidad: una petición seguida de servicio en servicio. Cada barra es un span, con su duración, y el conjunto forma una traza distribuida.
La curva te dice que algo ha cambiado; la traza te dice qué servicio, qué llamada y cuánto tiempo tardó.
Pasar de la monitorización a la observabilidad en cinco pasos
Paso 1: partir del usuario, no del servidor
Define un SLI que mida el servicio desde el punto de vista del usuario: tasa de peticiones correctas, latencia de una página. Vincúlalo a un SLO. Eso es lo que da sentido a las alertas. El módulo SLI, SLO, SLA detalla el método.
Paso 2: mantener la monitorización útil y eliminar el ruido
Conserva las alertas sobre averías conocidas y accionables (disco, certificado, servicio detenido). Elimina las que nunca desencadenan una acción. Menos alertas es menos fatiga de guardia (on-call): consulta reducir el ruido de las alertas.
En Dynatrace Managed, un indicador de monitorización clásico se lee con el metric selector:
# Dynatrace Managed — API Metrics v2, token avec le scope metrics.read
curl -s -H "Authorization: Api-Token {token}" \
  "https://{votre-domaine}/e/{id-environnement}/api/v2/metrics/query?metricSelector=builtin:service.errors.total.rate"
Paso 3: instrumentar para producir trazas
Sin trazas no es posible hacer ninguna pregunta nueva sobre el recorrido de una petición. Hay dos vías, a menudo combinadas: OneAgent, que instrumenta automáticamente las tecnologías compatibles (Managed y SaaS), y OpenTelemetry para el resto, mediante un Collector (consulta configurar un Collector de OpenTelemetry hacia Dynatrace).
Paso 4: relacionar las señales entre sí
Un log aislado dice poco. El primer de OpenTelemetry lo recuerda: los logs resultan mucho más útiles cuando se asocian a una traza y a un span. Inyecta el identificador de traza en tus logs y comprueba que los atributos (servicio, versión, entorno) son coherentes de una señal a otra. La guía logs de OpenTelemetry y trace_id muestra cómo hacerlo.
Paso 5: hacer la pregunta que ninguna alerta había previsto
Durante un incidente, explora. En Dynatrace SaaS, una consulta DQL sobre Grail permite cruzar los logs por nivel a lo largo del tiempo:
fetch logs
| filter loglevel == "SEVERE" or loglevel == "ERROR"
| makeTimeseries count = count(), by:loglevel, interval:5m
En Dynatrace Managed, la exploración pasa por Distributed traces, Multidimensional analysis y Data Explorer (consulta Distributed traces en Managed).
Cómo comprobar que tu práctica evoluciona
- Para cada incidente reciente, anota si la causa se encontró con datos ya recopilados o si hubo que añadir instrumentación.
- Mide por separado el tiempo de detección y el tiempo de diagnóstico: la observabilidad debe hacer bajar sobre todo el segundo.
- Comprueba que la traza de una petición con error lleva a sus logs, y a la inversa.
Buenas prácticas
- No tires tus sondas de disponibilidad: la monitorización sigue siendo la primera línea de detección.
- Alerta sobre los síntomas que ve el usuario, explora las causas con las trazas.
- Estandariza los atributos (nombre de servicio, versión, entorno) desde la instrumentación.
- Haz post-mortems sin culpas que anoten los datos que faltaban, y añádelos después.
Preguntas frecuentes
¿La observabilidad sustituye a la monitorización?
No. La monitorización detecta las averías conocidas con umbrales y sondas; la observabilidad explica las averías desconocidas. Un equipo maduro conserva ambas y las relaciona.
¿Cuáles son los tres pilares de la observabilidad?
Suelen citarse trazas, métricas y logs, las señales que describe OpenTelemetry. El valor viene menos de su número que de su correlación: un mismo contexto (traza, servicio, recurso) que permite pasar de una a otra.
¿Dynatrace hace monitorización o observabilidad?
Ambas. Recopila métricas, trazas y logs, los relaciona mediante Smartscape y alerta a través de Davis. Las herramientas de exploración difieren según la plataforma: DQL y Grail en SaaS, metric selector y Data Explorer en Managed. Para empezar, lee ¿Qué es Dynatrace?
Conclusión
Observabilidad vs monitorización no es lo viejo contra lo nuevo: es detectar contra entender. Mantén una monitorización sobria y accionable, instrumenta para producir trazas, relaciona logs y trazas, y mide tu progreso por el tiempo de diagnóstico. El día en que un incidente no se parezca a nada conocido, se notará la diferencia.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las capturas proceden de la demo de OpenTelemetry (CC BY 4.0); comprueba las sintaxis en la documentación oficial.