Módulo 5 de la formación SLO SLA: redactar una política de presupuesto de error, es decir, dejar escrito de antemano lo que hace el equipo cuando el presupuesto se derrite. Umbrales, acciones como la congelación de despliegues, alertas de burn rate con varias ventanas y puertas de paso a producción: todo lo que convierte un SLO en una decisión.
Ruta: Formación SLO SLA · Módulo 5/6 · Duración: ~40 min · Nivel: Intermedio · Plataforma: conceptos válidos en cualquier parte; herramientas de Dynatrace SaaS y Dynatrace Managed indicadas en cada caso
Un SLO sin consecuencias es un indicador más en una pantalla. El día en que el presupuesto se agota, alguien tiene que decidir si todavía se entrega la nueva funcionalidad. Sin una regla escrita, la decisión se toma en una reunión, bajo presión, y a menudo termina en un conflicto entre el equipo de producto y la guardia (on-call).
Este módulo parte de los cálculos del módulo 2 (cálculo del presupuesto de error y burn rate) y de los SLO creados en los módulos 3 y 4. Objetivo: al final tienes un documento de una página firmado por producto y operaciones, dos alertas de burn rate y una puerta de paso a producción conectada al mismo SLO.
¿Qué es una política de presupuesto de error?
Es un acuerdo escrito que dice, para un SLO dado, qué acciones activa cada nivel de consumo del presupuesto. El Google SRE Workbook publica un ejemplo en su capítulo Error Budget Policy. En él se encuentran cuatro ideas útiles:
- Un desencadenante claro: si el servicio ha superado su presupuesto en la ventana de cuatro semanas anterior, se detienen todos los cambios y pases a producción, salvo las correcciones P0 y de seguridad, hasta volver a estar dentro del SLO.
- Un umbral de post-mortem: un único incidente que consuma más del 20 % del presupuesto en cuatro semanas exige un post-mortem.
- Excepciones: un presupuesto consumido por usuarios fuera del alcance del SLO (pruebas de carga, pruebas de intrusión) no activa la congelación.
- Un árbitro: si hay desacuerdo sobre el cálculo, la cuestión sube a un nivel de dirección designado de antemano (el CTO en el ejemplo del Workbook).
La clave es el momento de la redacción: la política se negocia en frío, cuando el presupuesto está lleno. El día del incidente se aplica, ya no se discute. Es también un enfoque blameless: la regla apunta al servicio, no a las personas.
Paso 1 — Fijar los umbrales y las acciones
Divide el presupuesto restante en tramos. Los valores siguientes son ejemplos de partida, que hay que ajustar con el equipo de producto:
| Presupuesto restante (ventana de 30 d) | Estado | Acciones |
|---|---|---|
| > 50 % | Normal | Entregas al ritmo habitual, experimentos permitidos. |
| 25 a 50 % | Vigilancia | Revisión de los incidentes del periodo, pases a producción fuera de las horas punta, despliegue progresivo obligatorio. |
| 0 a 25 % | Restricción | Solo pasan los cambios de bajo riesgo y las correcciones de fiabilidad; una parte de la capacidad del equipo se dedica a la fiabilidad. |
| Agotado (< 0 %) | Congelación | Congelación de despliegues salvo correcciones P0 y de seguridad, hasta volver al SLO; post-mortem de los incidentes graves. |
Con un SLO del 99,9 % en 30 días, el presupuesto vale 43,2 minutos (43 200 minutos × 0,1 %). El tramo del «25 %» corresponde, pues, a 10,8 minutos de indisponibilidad restantes. Escribe estos valores en minutos en la política: dicen más que un porcentaje.
Añade una regla de salida: la congelación se levanta cuando el SLI en la ventana deslizante vuelve a superar el objetivo, no cuando cambia el mes natural. Si no, un incidente del día 29 quedaría borrado el día 1.
Paso 2 — Alertar sobre el burn rate, no sobre la tasa de errores
El burn rate es la relación entre la tasa de errores observada y la tasa de errores permitida por el SLO. La documentación de Dynatrace SaaS lo formula así: burn rate = tasa de errores / presupuesto de error, medido en una ventana retrospectiva (look-back window). Un burn rate de 1 agota el presupuesto exactamente al final de la ventana del SLO.
El Workbook, en el capítulo Alerting on SLOs, recomienda para un SLO del 99,9 % tres alertas con varias ventanas. Cada una combina una ventana larga y una ventana corta igual a 1/12 de la larga; la alerta salta solo si las dos superan el umbral. El presupuesto consumido en el momento del disparo es burn rate × ventana larga / periodo.
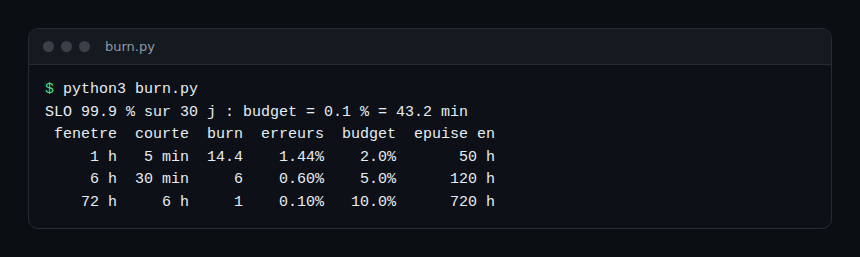
Cálculo de la primera línea: 14,4 × 1 h / 720 h = 0,02, es decir, el 2 % del presupuesto en una hora. A ese ritmo, el presupuesto entero dura 720 / 14,4 = 50 horas. Las dos primeras líneas despiertan a la guardia; la tercera abre un ticket.
Conecta estas alertas con la política: una alerta rápida significa «incidente en curso», una alerta lenta significa «se acerca el siguiente tramo». El detalle de la puesta en práctica está en las alertas de burn rate de SLO en Dynatrace.
En Dynatrace SaaS
La documentación de la aplicación Service-Level Objectives muestra cómo calcular el burn rate añadiendo una línea a la consulta DQL del SLI:
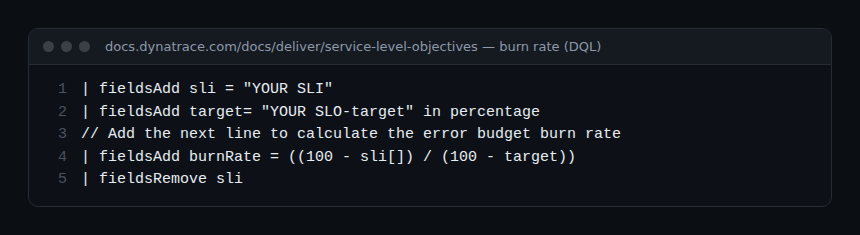
Esa consulta se pega después en Anomaly Detection para generar un evento cuando el burn rate supera un umbral estático. La documentación precisa que la ventana retrospectiva admitida es -1h, adecuada para la alerta rápida, y propone un umbral de partida entre 10 y 14. Recomienda añadir las propiedades de evento dt.source_entity, event.type, slo.name y dt.owner, esta última para enrutar la alerta al equipo adecuado. Los eventos obtenidos pueden activar un Workflow.
En Dynatrace Managed
Los SLO clásicos muestran, en la lista Service-level objectives, el estado, el presupuesto de error y el burn rate de cada SLO. No hay DQL ni Anomaly Detection sobre Grail: la configuración de las alertas pasa por los SLO clásicos, descritos en los SLO de Dynatrace Managed desde la interfaz y la API.
Paso 3 — Conectar una puerta de paso a producción
La política dice «congelación cuando el presupuesto se agota»; el pipeline debe saberlo sin que una persona mire un dashboard.
- Dynatrace SaaS: Site Reliability Guardian agrupa objetivos, cada uno medido por un indicador obtenido en DQL y comparado con un umbral de advertencia y un umbral de fallo. Un Workflow activado por el evento SDLC de fin de despliegue lanza la validación, cuyo estado vale, entre otros,
pass,warningofail. Un objetivo «presupuesto restante ≥ 25 %» aplica directamente el tramo de restricción. Tutorial completo: Site Reliability Guardian para validar una release. - Dynatrace Managed: no hay Site Reliability Guardian. El pipeline lee el SLO mediante la API y compara el presupuesto restante con el umbral, como en el presupuesto de error como release gate.
En ambos casos, un dato ausente debe cerrar la puerta: un SLI mudo nunca equivale a luz verde.
Ejercicio práctico
- Elige un SLO existente (módulo 3 o 4) y calcula su presupuesto en minutos sobre su ventana.
- Redacta la política en una página: tramos, acciones, excepciones, umbral de post-mortem, árbitro, fecha de revisión.
- Calcula los umbrales de alerta: burn rate 14,4 en 1 h y 6 en 6 h, presupuesto consumido en el disparo.
- En SaaS, añade la línea
burnRatea la consulta del SLI en un Notebook y comprueba que el valor es cercano a 0 en régimen normal. - Pide al responsable de producto que revise y firme la política.
Cómo comprobar que funciona
- SaaS: en Anomaly Detection, la vista previa de la alerta muestra la serie del burn rate por debajo del umbral; baja temporalmente el umbral en un entorno de pruebas para ver aparecer el evento con
slo.nameydt.owner. - SaaS: lanza una validación del guardian y localiza su resultado en la lista de validaciones.
- Managed: la columna del presupuesto de error de la lista de SLO debe coincidir con tu cálculo en minutos.
- Reproduce un incidente pasado sobre el papel: ¿la política habría activado la acción correcta en el momento correcto?
Cuestionario
- SLO 99,9 % en 30 días, burn rate 14,4 durante 1 h: ¿qué parte del presupuesto se consume? a) 0,1 % b) 2 % c) 14,4 % d) 50 %
- ¿Qué ventana corta acompaña a una ventana larga de 6 h? a) 5 min b) 30 min c) 1 h d) 6 h
- Según el ejemplo del Workbook, ¿qué incidente exige un post-mortem? a) Cualquier incidente b) Más del 20 % del presupuesto en cuatro semanas c) Más del 50 % del presupuesto d) Solo un incumplimiento del SLA
- ¿Existe Site Reliability Guardian en Dynatrace Managed? a) Sí b) No
Soluciones
- b) 14,4 × 1 / 720 = 2 %.
- b) La ventana corta vale 1/12 de la larga: 6 h / 12 = 30 min.
- b) Es el umbral del ejemplo de política del Workbook.
- b) Es una aplicación de Dynatrace SaaS; en Managed se usa la API de SLO.
Buenas prácticas
- Una política por servicio crítico, una página, una fecha de revisión.
- Umbrales en minutos y en solicitudes, no solo en porcentaje.
- Dos alertas de burn rate bastan para empezar; añade después el ticket a 3 días.
- La misma definición de SLI para el SLO, la alerta y la puerta de paso a producción.
Preguntas frecuentes
¿La política de presupuesto de error bloquea todos los despliegues?
No. Restringe de forma progresiva y solo congela cuando se supera el presupuesto, con excepciones escritas para las correcciones de fiabilidad y de seguridad.
¿Qué hacer si el presupuesto lo consume una dependencia externa?
Prevé el caso en la política. El Workbook cita, por ejemplo, una caída de red a escala de toda la empresa como motivo para no congelar las funcionalidades. Anótalo en el post-mortem y habla con el proveedor de un SLO más realista.
¿Hace falta un burn rate de 14,4 para todos los SLO?
No. Esos valores proceden de un ejemplo al 99,9 % en 30 días. Para otro objetivo u otra ventana, repite el cálculo; la documentación de Dynatrace propone de 10 a 14 como punto de partida en una ventana de una hora.
Tu SLO tiene ahora consecuencias escritas, alertas y una puerta. El último módulo pasa de lo interno a lo externo: convertir un SLO en un compromiso contractual.
← Módulo 4: crear un SLO en Managed · Índice de la ruta · Módulo 6: redactar un SLA →
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Esta ruta no sustituye las formaciones oficiales de Dynatrace University. Los umbrales de la política son ejemplos; comprueba siempre los valores y las funcionalidades de Dynatrace en la documentación oficial correspondiente a tu versión.