Módulo 4 de la formación SLO SLA: crear un SLO en Managed, es decir, un SLO clásico en Dynatrace Managed, definido por una metric expression, un entity selector, un periodo de evaluación y unos umbrales, desde el asistente o mediante la API /api/v2/slo.
Ruta: Formación SLO SLA · Módulo 4/6 · Duración: ~40 min · Nivel: Intermedio · Plataforma: Dynatrace Managed (SLO clásicos, metric expressions, API v2)
Objetivos:
- Crear un SLO con el asistente de cuatro pasos
- Escribir una metric expression de disponibilidad y de rendimiento
- Filtrar las entidades y elegir el periodo de evaluación
- Crear y leer un SLO mediante la API, con el scope de token correcto
Requisitos previos: los módulos 1 y 2, un entorno Managed y un token de API con los scopes slo.read y slo.write.
En Dynatrace Managed no hay Grail ni DQL: los SLO se llaman «clásicos» y se apoyan en las métricas builtin: y en el metric selector. El principio sigue siendo el del módulo 1: un SLI en porcentaje, un objetivo, un periodo. Solo cambia la forma de escribir el SLI.
Este módulo vale para Dynatrace Managed. El equivalente en Dynatrace SaaS, con la app Service-Level Objectives y DQL, se trata en el módulo 3. Para un repaso más amplio de la configuración y de la API, consulta también SLO en Dynatrace Managed: configuración y API.
Crear un SLO en Managed con el asistente
Ve a Service-Level Objectives, selecciona Add new SLO y sigue los cuatro pasos del asistente: Select your indicators, Define a filter, Add success criteria, Evaluate.
Paso 1: elegir el indicador
La documentación de Managed propone seis SLO preconfigurados:
- Service-level availability: llamadas correctas divididas entre el total de llamadas del servicio;
- Service-method availability: el mismo cálculo sobre las key requests;
- Service performance: minutos «buenos» (latencia por debajo del umbral) divididos entre el total de minutos;
- User experience: proporción de usuarios SATISFIED según el Apdex;
- Mobile crash-free users: proporción de usuarios móviles sin crash;
- Synthetic availability: ejecuciones sintéticas correctas sobre el total.
Introduce después el nombre del SLO y un Metric name, por ejemplo checkout_availability. Dynatrace deriva de él cuatro claves de métrica: func:slo.checkout_availability (estado), func:slo.errorBudget.checkout_availability, func:slo.normalizedErrorBudget.checkout_availability y func:slo.errorBudgetBurnRate.checkout_availability. Elige bien este nombre: la documentación precisa que ya no se puede modificar después de la creación.
Paso 2: filtro y periodo
El selector de periodo ofrece Presets o un valor Custom. El entity selector sigue la sintaxis de la API REST: zona de gestión (nombre o ID), etiquetas, nombre, ID o tipo de entidad, estado de salud, o una combinación. El botón Preview comprueba el selector antes de continuar. Ejemplo de la documentación:
type("SERVICE"),entityName("My service")Poner una zona de gestión en el entity selector vincula el SLO a esa zona: solo lo ven los usuarios que tienen acceso a ella. Un SLO sin zona es global y lo ven todos.
Paso 3: criterios de éxito
Rellena el objetivo (Failure) y la advertencia (Warning). La advertencia debe situarse entre el objetivo y el 100 %: para un objetivo del 99 %, elige por ejemplo 99,5 %. Activa Error budget burn rate y fija el umbral entre burn lento y burn rápido.
Paso 4: evaluar y crear
Evaluate calcula el SLO con los valores introducidos. Si no hay errores, Create lo guarda y aparece en la lista. Los usuarios avanzados también pueden ir por Settings > Cloud Automation > Definition > Add new SLO.
Escribir la metric expression
La metric expression produce el SLI en porcentaje. Para la disponibilidad de un servicio, la documentación da:
(100)*(builtin:service.errors.server.successCount:splitBy())/(builtin:service.requestCount.server:splitBy())El :splitBy() sin argumentos fusiona todas las entidades retenidas por el filtro en una sola serie: el SLO devuelve un único valor. La documentación enumera además el error «One resulting value is required, but the SLO definition delivers more than one» entre los problemas conocidos; suele aparecer cuando falta esa agrupación.
Para un SLO de rendimiento basado en tramos de tiempo, la documentación propone una expresión que cuenta los intervalos «buenos»:
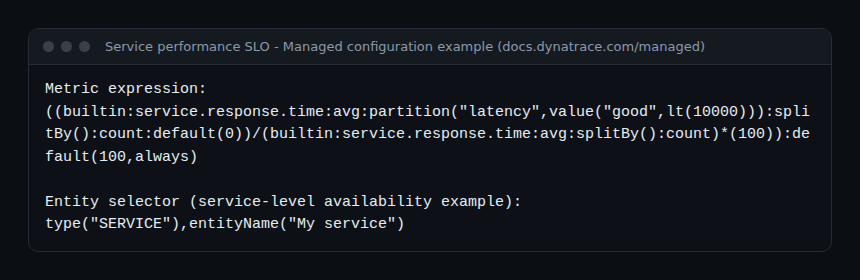
Líneas críticas: partition("latency",value("good",lt(10000))) clasifica cada punto según la latencia; la documentación precisa que la unidad exigida es el microsegundo, de modo que lt(10000) significa menos de 10 ms. :default(0) sustituye los valores nulos y :default(100,always) devuelve 100 % si no hay ningún dato. Para un umbral de 500 ms, escribe lt(500000).
Crear el SLO mediante la API
Para versionar los SLO, usa el endpoint POST /api/v2/slo del entorno. El token debe llevar el scope slo.write. Este es el modelo de cuerpo de la documentación, del que se han retirado los campos marcados como DEPRECATED (metricNumerator, metricDenominator, metricRate, useRateMetric):
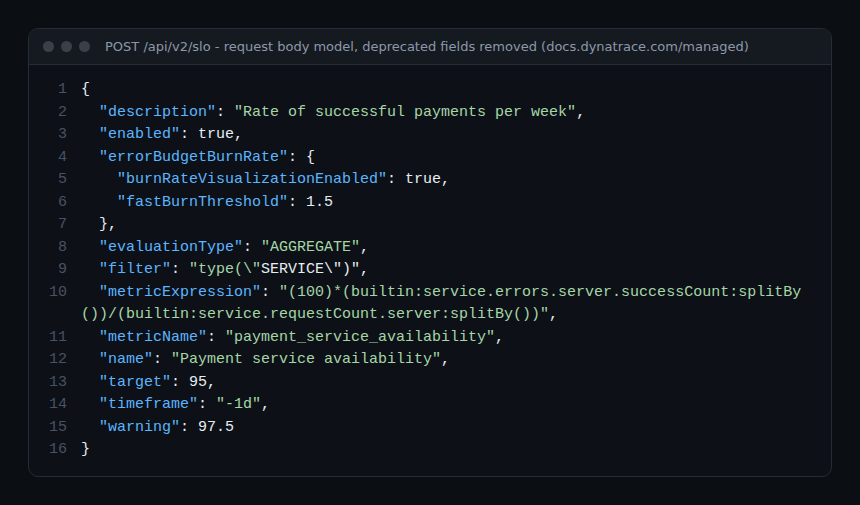
Puntos que conviene conocer, todos procedentes de la documentación:
name,target,warning,timeframeyevaluationType(único valor:AGGREGATE) son obligatorios;enabledvalefalsepor defecto: sin él, el SLO se crea desactivado;filtersigue la sintaxis del entity selector y no supera los 1000 caracteres;timeframesigue la sintaxis del selector de periodo global; el modelo usa-1d, adáptalo a tu periodo;- la respuesta 201 no tiene cuerpo: el ID del nuevo SLO está en la cabecera
Location.
curl -s -i -X POST "https://{votre-domaine}/e/{id-environnement}/api/v2/slo" \
  -H "Authorization: Api-Token $DT_TOKEN" \
  -H "Content-Type: application/json" \
  -d @slo.json
Para gestionar los SLO como código a largo plazo, consulta SLO de Dynatrace con Terraform.
Cómo comprobar que funciona
- Lee el SLO evaluado (scope
slo.read):curl -s "https://{votre-domaine}/e/{id-environnement}/api/v2/slo?sloSelector=name(%22Payment%20service%20availability%22)&evaluate=true" \ -H "Authorization: Api-Token $DT_TOKEN" - Controla los campos:
evaluatedPercentage(estado; -1 en caso de error, mira entonces el campoerror),errorBudget(positivo = todo va bien),status(SUCCESS,WARNINGoFAILURE) yerrorBudgetBurnRate.burnRateValue, calculado sobre la última hora. - Con
evaluate=true, el tamaño de página está limitado a 25. Para un periodo distinto del del SLO, añadetimeFrame=GTFconfromyto. - En la interfaz, abre Actions > View in Data Explorer para representar la clave
func:slo.….
Ejemplo de lectura: objetivo 95 y estado 96,25 dan errorBudget = 1,25. Si el presupuesto normalizado está activado (Settings > Cloud Automation > Setup), la documentación lo calcula así: (96,25 − 95) ÷ (100 − 95) × 100 = 25 % del presupuesto restante.
Alertar sobre el SLO
Desde la lista, More (…) > Create alert ofrece dos tipos: Status (el estado cae por debajo del objetivo) y Burn rate. Las alertas se basan en metric events evaluados sobre la última hora: un umbral de 10 se activa cuando el burn rate supera 10 en la hora transcurrida. La documentación precisa que Davis no alerta sobre el incumplimiento del propio objetivo, sino sobre las métricas y entidades subyacentes. Las estrategias de alerta se detallan en alertas de burn rate de SLO y en el módulo 5.
Ejercicio práctico
- Crea con el asistente un SLO Service-level availability en un servicio de pruebas, objetivo 99 %, advertencia 99,5 %, burn rate activado.
- Crea el mismo SLO mediante la API con otro
metricName, sin olvidar"enabled": true. - Resultado esperado: los dos SLO muestran el mismo
evaluatedPercentageenGET /api/v2/slo?evaluate=true.
Cuestionario
- ¿Qué scope hace falta para crear un SLO mediante la API? a)
metrics.readb)slo.readc)slo.writed)settings.read - En un SLO de rendimiento,
lt(10000)significa: a) 10 s b) 10 ms c) 10 µs d) 10 000 solicitudes - ¿Qué ocurre si se omite
enabled? a) Error 400 b) SLO activado c) SLO desactivado d) SLO eliminado
Soluciones
- c)
slo.write; la lectura requiereslo.read. - b) La unidad es el microsegundo: 10 000 µs = 10 ms.
- c) El valor por defecto es
false.
Buenas prácticas
- Elige el
metricNamecon cuidado: queda fijado y se usa en todos los gráficos. - Termina siempre la metric expression con una agrupación única (
:splitBy()). - Vincula los SLO de equipo a una zona de gestión; deja globales los de la dirección.
- Evalúa el SLO antes de crearlo y compáralo con el cálculo a mano.
Preguntas frecuentes
¿Puedo usar DQL en un SLO de Managed?
No. Dynatrace Managed no tiene Grail: el SLI se escribe como metric expression. DQL queda reservado a los SLO de Dynatrace SaaS (módulo 3).
¿Siguen siendo útiles los campos metricNumerator y metricDenominator?
Están marcados como DEPRECATED en la documentación de la API. Usa metricExpression, que cubre tanto la razón como las expresiones más complejas.
¿Cómo comparar estos SLO con los de otras herramientas?
Los conceptos son los mismos; cambia la forma de escribir el SLI. Hay una comparativa detallada en SLO en Dynatrace y Grafana.
Ya sabes crear un SLO en Managed, con el asistente o con la API, y comprobarlo. El siguiente módulo decide qué se hace cuando el presupuesto se derrite: la política de presupuesto de error.
← Módulo 3: SLO en Dynatrace SaaS · Índice de la ruta · Módulo 5: política de presupuesto de error →
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Las pantallas, campos y scopes citados proceden de la documentación oficial de Dynatrace Managed (Configure and monitor SLOs, POST an SLO); compruébalos en la versión de tu clúster.