Las reglas de alerta de Prometheus (alerting rules) convierten una expresión PromQL en una alerta: si la expresión devuelve series, se activa una alerta por cada una. Escribir la regla es rápido. Hacerla fiable lleva más tiempo: elegir el umbral adecuado, ajustar la duración for, adjuntar un runbook y demostrar en integración continua que la regla se dispara cuando debe y solo entonces. Este artículo sigue ese camino con un archivo de reglas, una prueba con promtool y los puntos de atención de un equipo SRE.
Continúa el artículo sobre las recording rules, cuya serie de ratio de errores sirve aquí de base para la alerta. Las alertas descritas las evalúa el propio Prometheus, no Dynatrace.
En resumen
- Una regla de alerta lleva
alert,expry, de forma opcional,for,keep_firing_for,labelsyannotations. - Con
for, una serie debe permanecer activa durante el tiempo indicado antes de pasar del estado pending al estado firing. promtool check rulesvalida los archivos;promtool test rulescomprueba que una alerta se dispara (o no) con series fabricadas.- Prometheus no envía notificaciones por sí mismo: transmite el estado de las alertas a Alertmanager.
Reglas de alerta de Prometheus: la estructura de una regla
Según la documentación de Prometheus sobre reglas de alerta, las reglas se declaran en un grupo, igual que las recording rules. Cada regla de alerta incluye:
alert: el nombre de la alerta;expr: la expresión PromQL, con una alerta activa por cada conjunto de labels que devuelva;for: el tiempo que un elemento debe permanecer activo antes de pasar a firing;keep_firing_for: el tiempo que la alerta sigue disparada después de la última vez que se cumplió la condición;labelsyannotations: información añadida a la alerta, que puede usar plantillas ($labels,$value,$externalLabels).
El archivo siguiente define dos alertas. La primera reutiliza el ratio de fallos del artículo anterior; la segunda vigila la falta de respuesta de un objetivo.
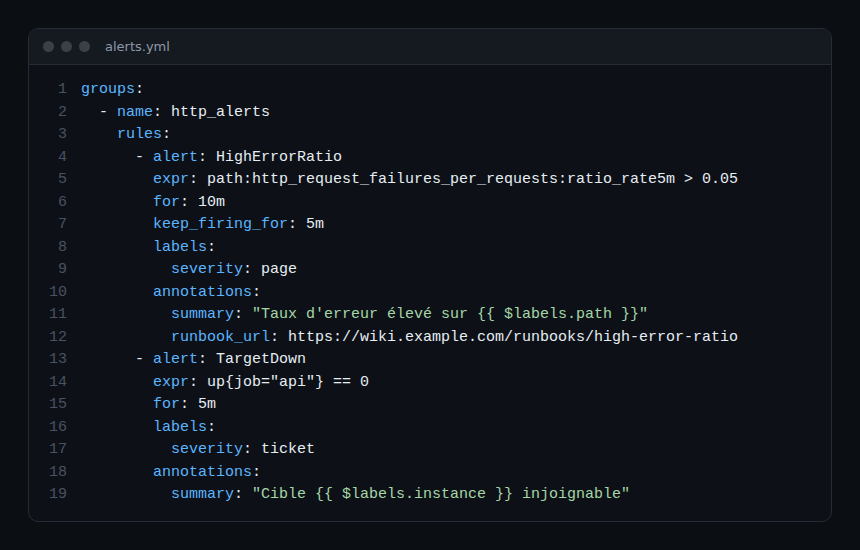
El umbral de 0,05, el nombre del job api y la URL del runbook son valores de ejemplo del artículo. Los labels severity son también una convención libre, no un campo impuesto por Prometheus.
Ajustar for y keep_firing_for
La documentación describe dos estados. Un elemento activo que aún no ha alcanzado la duración for está en pending. Sin for, la alerta se activa desde la primera evaluación. Eso basta para explicar por qué un umbral a secas despierta a la guardia (on-call) por un pico de unos segundos.
for: filtrar los picos breves
La página indica que for elimina las alertas que solo cumplen la condición brevemente. Una duración de 10 minutos sobre una tasa de errores calculada en 5 minutos exige, por tanto, un problema sostenido. La elección es un compromiso: cuanto más largo es for, menos falsos positivos, pero mayor es el retraso de detección (y, con él, el MTTR). Relaciónalo con tu SLO. Para una alerta basada en el ritmo de consumo del presupuesto de errores, consulta las alertas de burn rate sobre SLO.
keep_firing_for: evitar el vaivén
Según la misma página, keep_firing_for ayuda a evitar que una alerta oscile y las falsas resoluciones debidas a huecos de datos. Con 5 minutos, una alerta que cae por debajo del umbral durante un minuto no se declara resuelta de inmediato. Sin este campo, la alerta se desactiva en la primera evaluación en la que la condición deja de cumplirse, una vez satisfecha la duración for.
¿Qué almacena Prometheus?
Por cada alerta pending o firing, Prometheus registra una serie ALERTS con los labels alertname, alertstate (pending o firing) y los labels de la alerta, con valor 1. La serie se marca como obsoleta cuando la alerta abandona ese estado. Así puedes consultar el historial de alertas con PromQL, por ejemplo para contar las alertas firing por nombre durante una semana y localizar las reglas ruidosas.
Prometheus no gestiona por sí mismo las notificaciones. Según la documentación, envía el estado de las alertas a un Alertmanager, que se ocupa de la agrupación, la limitación de frecuencia, los silencios y el envío. La calidad de una alerta depende, por tanto, también del enrutado: para el ruido del lado de Dynatrace, consulta la reducción del ruido de las alertas de Davis.
Diseñar una alerta útil
La página de buenas prácticas de alerting recomienda alertar sobre síntomas y no sobre causas, es decir, sobre lo que afecta al usuario: latencia y tasa de errores, lo más arriba posible en la pila. También aconseja dejar margen para los pequeños accidentes y hacer que las alertas apunten a las consolas útiles para identificar el componente responsable. Trata el caso de una capacidad casi agotada como una advertencia, no como una página.
Aplicado al ejemplo: HighErrorRatio es una alerta de síntoma con severidad page, mientras que TargetDown corresponde más bien a un ticket. Esta distinción reduce el toil de guardia, porque cada página debe exigir una acción humana.
Probar las reglas de alerta con promtool
La página Unit testing for rules describe el comando promtool test rules test.yml. El archivo de prueba declara los rule_files, el evaluation_interval (1 minuto por defecto) y una lista de pruebas. Cada prueba aporta input_series y, para una alerta, un bloque alert_rule_test:
eval_time: el momento, desde el inicio de la prueba, en que se comprueban las alertas;alertname: la alerta probada;exp_alerts: las alertas esperadas, conexp_labels(los labels de la serie, sin__name__nialertname) yexp_annotations. Una lista vacía comprueba que la alerta no se dispara.
La notación 0.08+0x20 empieza en 0,08 y suma 0 durante 20 pasos: la serie se mantiene, pues, constante por encima del umbral.
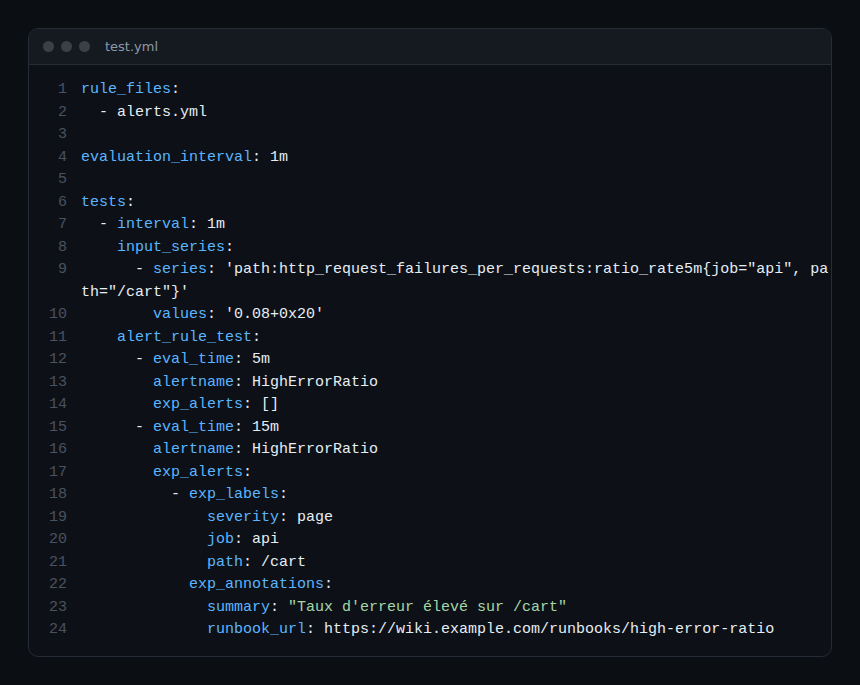
La prueba verifica dos cosas: a los 5 minutos no se ha alcanzado la duración for de 10 minutos, así que no hay alerta; a los 15 minutos, la alerta está activa con los labels y las annotations esperados. Este archivo no se ha ejecutado para este artículo, porque promtool no estaba disponible en el entorno de redacción. Ejecútalo antes de fiarte de él y corrígelo si tu versión muestra otra cosa.
Validar las reglas en CI
Según la referencia de promtool, check rules comprueba la validez de los archivos de reglas. Su opción --lint acepta all, duplicate-rules o none (por defecto duplicate-rules) y --lint-fatal hace que el comando termine con el código 3 si hay un error de lint. En las pruebas, --run limita la ejecución a los grupos cuyo nombre coincide con una expresión regular, y --diff (marcada como experimental) muestra las diferencias entre lo esperado y lo recibido.
Un paso de pipeline típico encadena los dos comandos:
promtool check rules alerts.yml rules.yml --lint=all --lint-fatal
promtool test rules test.yml --diff
La página no ofrece una tabla general de códigos de retorno, salvo el código 3 de --lint-fatal. En la mayoría de los sistemas de CI, un código distinto de cero hace fallar el paso: comprueba este comportamiento en tu herramienta antes de contar con él.
Un paso de revisión posible: toda modificación de alerts.yml debe ir acompañada de una prueba que falle sin ella. Una alerta nunca probada cae pronto en desuso. Para situar este enfoque en el conjunto de la observabilidad, consulta la diferencia entre observabilidad y monitorización.
Buenas prácticas
- Alerta sobre síntomas visibles para el usuario, con una severidad que decida entre página y ticket.
- Fija un
forcoherente con la ventana de la consulta y con tu SLO, y añadekeep_firing_forsi la alerta oscila. - Pon un enlace al runbook en las annotations y pruébalas con
exp_annotations. - Versiona las reglas y sus pruebas juntas y valídalas en CI.
- Prueba también el caso en que la alerta no debe dispararse.
Preguntas frecuentes
¿Qué ocurre si falta for?
Según la documentación, la alerta se activa en la primera evaluación en la que la expresión devuelve series. Con una métrica ruidosa, esto produce alertas breves; un for evita ese comportamiento.
¿Hace falta una recording rule antes de una alerta?
No es obligatorio. Una alerta puede llevar una expresión directa. Usar una serie registrada evita duplicar una consulta costosa entre dashboards y alertas, y simplifica la prueba, como en el ejemplo.
¿Se pueden enviar estas alertas a Dynatrace?
Las reglas las sigue evaluando Prometheus y las transmite a un Alertmanager. Este artículo no documenta ninguna integración directa con Dynatrace: para encaminar las métricas de Prometheus, consulta Prometheus y Kubernetes con Dynatrace, y revisa la documentación de la plataforma de destino para las alertas.
Conclusión
Una regla de alerta se compone de una expresión, una duración for, labels y annotations. Solo vale si está probada: promtool check rules y promtool test rules en CI evitan tanto las alertas silenciosas como las páginas inútiles. Empieza por una regla de síntoma, una prueba de disparo y una prueba de no disparo.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Dynatrace es una marca de su propietario. Prometheus es un proyecto de la Cloud Native Computing Foundation. Los procedimientos evolucionan: comprueba siempre la documentación oficial antes de un cambio en producción.