Las métricas de herramientas MCP responden a tres preguntas que las trazas por sí solas plantean mal: cuántas llamadas recibe cada herramienta, qué latencia típica tiene y qué parte de las llamadas falla. Un servidor MCP expone herramientas que un modelo de lenguaje llama en bucle; sin agregados, la primera señal de una herramienta defectuosa es la queja de un usuario, no una alerta.
El artículo observar los agentes MCP con OpenTelemetry trata los spans. Este se centra en las métricas: qué definen las convenciones semánticas de OpenTelemetry para MCP, qué no definen (no existe un contador dedicado) y cómo obtener una tasa de fallos por herramienta sin disparar la cardinalidad. El contenido es independiente del backend; vale tanto para Dynatrace SaaS como para Managed siempre que las métricas lleguen por OTLP.
Objetivo desde el lado SRE: convertir «el agente va lento» en un SLI medible por herramienta, sobre el que puedan apoyarse un SLO y un presupuesto de error, y reducir el MTTR identificando la herramienta culpable con una sola consulta.
Métricas de herramientas MCP: qué prevé la convención
Las convenciones MCP viven en el repositorio open-telemetry/semantic-conventions-genai (la página histórica del sitio de OpenTelemetry remite a él). El archivo model/mcp/metrics.yaml, leído en el estado del repositorio del 30 de octubre de 2026, declara cuatro métricas, todas histogramas en segundos, de nivel «recommended» y estabilidad «development»:
mcp.client.operation.duration: duración de una solicitud o notificación, medida en el emisor, desde el envío hasta la recepción de la respuesta;mcp.server.operation.duration: duración medida en el receptor, desde la recepción hasta el envío del resultado;mcp.client.session.durationymcp.server.session.duration: duración de una sesión.
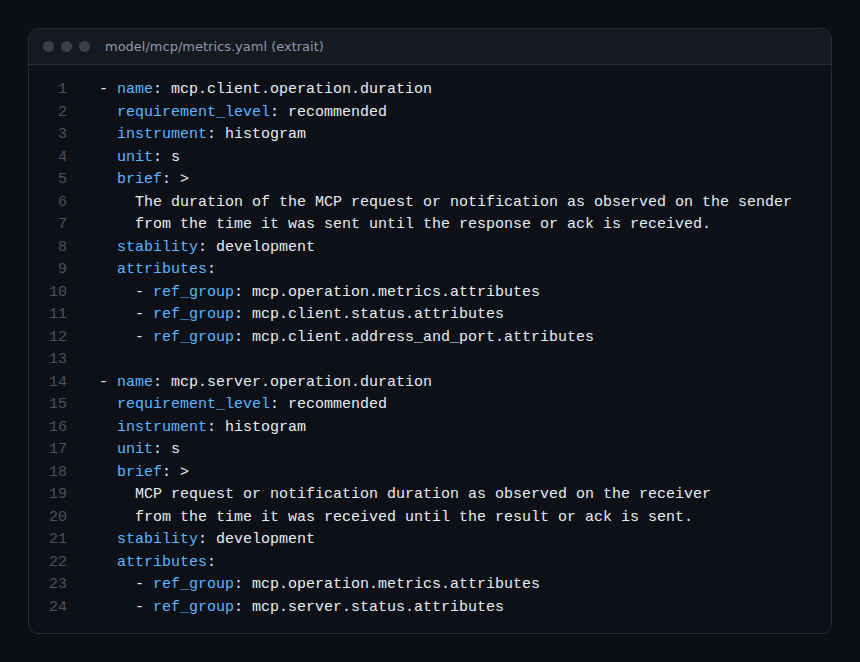
Dos consecuencias prácticas. Primero, la estabilidad «development» significa que los nombres y atributos todavía pueden cambiar: fija la versión de la convención que sigues y lee el changelog antes de actualizar. Segundo, la convención no define ningún contador de llamadas ni de errores: el número de llamadas y el de fallos se deducen del contador integrado en cada histograma (su «count»), filtrado por el atributo error.type.
Los atributos que dan valor a la medida
Para las métricas de operación, la página docs/gen-ai/mcp.md del mismo repositorio enumera estos atributos:
mcp.method.name: obligatorio (por ejemplotools/call,tools/list,initialize);gen_ai.tool.name: requerido bajo condición, cuando la operación afecta a una herramienta concreta;error.type: requerido si, y solo si, la operación falla;rpc.response.status_code: requerido si la respuesta contiene un código de error JSON-RPC;gen_ai.operation.name: recomendado, con el valorexecute_toolpara una llamada a una herramienta;mcp.resource.uri: solo como «opt-in».
El último punto merece atención. El URI de un recurso puede tomar millones de valores: la convención lo deja desactivado por defecto a propósito. El nombre de la herramienta, en cambio, está acotado por el catálogo del servidor. Es la dimensión adecuada: mcp.method.name × gen_ai.tool.name × error.type sigue siendo de baja cardinalidad. Para el método de medición y de reducción de series inútiles, consulta la cardinalidad de las métricas de Kubernetes.
Contar los fallos: tres casos que distinguir
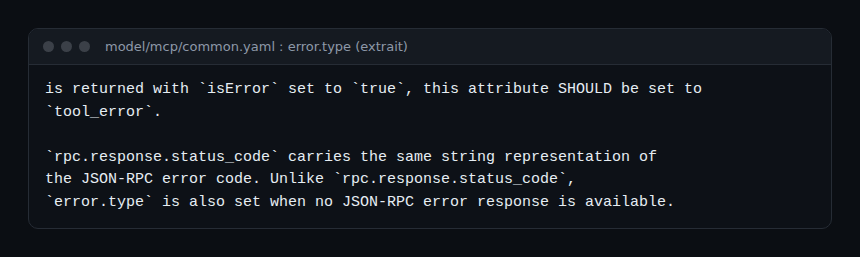
El cálculo de la tasa de fallos depende de lo que la convención clasifica como error. La definición de error.type en model/mcp/common.yaml distingue:
- una respuesta con un código de error JSON-RPC:
error.typerecibe ese código en forma de cadena; - una respuesta HTTP en error sin código JSON-RPC: el código de estado HTTP;
- un tiempo de espera agotado o un error de transporte: el nombre canónico de la excepción o del error.
Existe también un cuarto caso, propio de las herramientas: la llamada JSON-RPC tiene éxito, pero el resultado (CallToolResult) lleva isError a true. La convención pide entonces error.type igual a tool_error. Sin esta regla, una herramienta que falla «limpiamente» quedaría invisible en una tasa de fallos basada en códigos de estado.
En el lado del servidor, la convención precisa que ciertos códigos señalan una solicitud que el receptor no podía atender y no deben contarse como errores: -32700 (Parse error), -32600 (Invalid Request), -32601 (Method not found), -32602 (Invalid params, que también se devuelve cuando la herramienta pedida no existe) y -32002 (Resource not found). Cualquier otro código es un error. En el lado del cliente cuentan todos los códigos de error JSON-RPC. Consecuencia: la tasa de fallos vista por el cliente suele ser mayor que la vista por el servidor, y ambas no se comparan sin esta precisión.
Paso 1: registrar el histograma con los límites recomendados
Si el servidor se instrumenta a mano, la convención indica que cada métrica de duración debería declararse con los límites explícitos [0.01, 0.02, 0.05, 0.1, 0.2, 0.5, 1, 2, 5, 10, 30, 60, 120, 300] (en segundos).
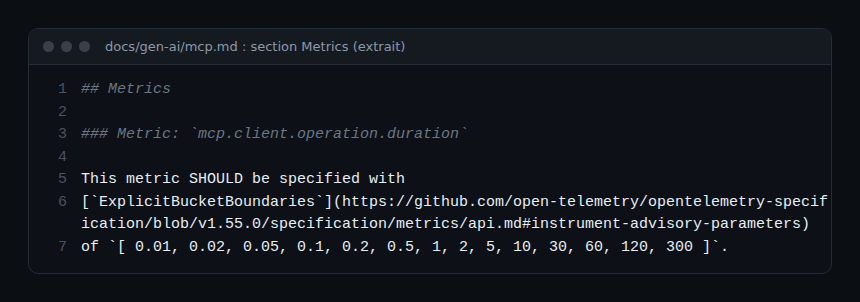
La API de Python de OpenTelemetry acepta estos límites mediante el parámetro explicit_bucket_boundaries_advisory de create_histogram (presente en el repositorio opentelemetry-python leído durante la redacción). Ejemplo mínimo del lado del servidor:
import time
from opentelemetry import metrics

meter = metrics.get_meter("mon-serveur-mcp")
duration = meter.create_histogram(
    "mcp.server.operation.duration",
    unit="s",
    description="MCP request or notification duration as observed on the receiver",
    explicit_bucket_boundaries_advisory=[0.01, 0.02, 0.05, 0.1, 0.2, 0.5,
                                         1, 2, 5, 10, 30, 60, 120, 300],
)

def appeler(nom_outil, fonction, **arguments):
    attrs = {"mcp.method.name": "tools/call",
             "gen_ai.tool.name": nom_outil,
             "gen_ai.operation.name": "execute_tool"}
    debut = time.perf_counter()
    try:
        resultat = fonction(**arguments)
        if getattr(resultat, "isError", False):
            attrs["error.type"] = "tool_error"
        return resultat
    except Exception as exc:
        attrs["error.type"] = type(exc).__name__
        raise
    finally:
        duration.record(time.perf_counter() - debut, attrs)
Las líneas críticas: la unidad es el segundo (y no el milisegundo), error.type solo se fija en caso de fallo, y ningún argumento de la llamada entra en los atributos. El nombre de una herramienta no contiene ni identificador de usuario ni valor libre.
Paso 2: derivar contadores e histogramas de las trazas con el Collector
Cuando los spans MCP ya existen, no hace falta duplicar la instrumentación: el conector span_metrics del Collector (distribución contrib) agrega los spans en métricas. Según su README, produce un contador de llamadas (traces.span.metrics.calls) y un histograma de duración (traces.span.metrics.duration), con una dimensión status.code para distinguir los errores. Su estado es «alpha» y la unidad por defecto es el milisegundo, según ese mismo README: compruébalo en la versión desplegada.
connectors:
  span_metrics:
    histogram:
      unit: s
      explicit:
        buckets: [10ms, 20ms, 50ms, 100ms, 200ms, 500ms, 1s, 2s, 5s, 10s, 30s, 60s]
    dimensions:
      - name: mcp.method.name
      - name: gen_ai.tool.name
    aggregation_cardinality_limit: 500

service:
  pipelines:
    traces:
      receivers: [otlp]
      exporters: [span_metrics]
    metrics:
      receivers: [span_metrics]
      exporters: [otlp]
Las claves histogram.unit, histogram.explicit.buckets, dimensions y aggregation_cardinality_limit figuran en el README del conector. El valor 500 es un ejemplo que hay que adaptar. El README describe este límite como un cortacircuitos: más allá, las combinaciones adicionales se agrupan bajo otel.metric.overflow="true". Los nombres resultantes (traces.span.metrics.*) difieren de mcp.server.operation.duration: elige una de las dos familias para tus paneles, no las dos. Para la puesta en marcha del Collector, consulta el Collector de OpenTelemetry en Kubernetes.
Cómo comprobar que funciona
Llama a propósito a una herramienta con un argumento no válido y después a una herramienta que devuelva isError: true. En el backend, la serie error.type="tool_error" debe aparecer para la segunda, y el contador del histograma de la primera debe aumentar. Si el Collector se ejecuta con el exportador debug, los puntos de métrica aparecen en sus logs incluso antes de llegar al backend.
Paso 3: definir el SLI por herramienta
Dos indicadores bastan para empezar:
- Disponibilidad por herramienta: llamadas sin
error.typedivididas entre todas las llamadas detools/call, porgen_ai.tool.name; - Latencia por herramienta: un percentil (por ejemplo el 95) estimado a partir de los buckets; la estimación solo es precisa hasta la anchura del bucket, de ahí el interés de los límites recomendados.
Fija el objetivo con el equipo propietario de la herramienta y alerta sobre el consumo del presupuesto de error en lugar de un pico aislado, como se describe en alertar sobre los síntomas y no sobre las causas. La diferencia entre estas medidas y una simple supervisión se detalla en observabilidad y monitorización.
Buenas prácticas
- Un solo punto de medida por lado: el servidor para la carga real, el cliente para la experiencia del agente (red incluida).
- Ningún valor libre como dimensión: ni URI de recurso, ni argumento, ni identificador de sesión.
- Documentar en el runbook la regla «
-32602no es un error en el lado del servidor», para evitar debates durante un incidente. - Limitar la cardinalidad aguas arriba (
aggregation_cardinality_limit) y vigilar el desbordamiento. - Revisión sin culpables: una tasa de fallos alta señala una herramienta que mejorar, no a una persona.
Preguntas frecuentes
¿Hace falta un contador de llamadas además del histograma?
No. La convención MCP no define ningún contador: el número de observaciones de un histograma da el número de llamadas. En cambio, el conector span_metrics proporciona un contador dedicado, deducido de los spans.
¿Una herramienta que devuelve isError a true cuenta como fallo?
Sí, según la convención: error.type debe valer tool_error. Sin este atributo, la llamada parece correcta en el lado del protocolo.
¿Son estables estas métricas?
No, están marcadas como «development» en el repositorio leído. Fija la versión que sigues y lee el changelog antes de cada actualización.
Conclusión
Las métricas de herramientas MCP se resumen en cuatro histogramas en segundos, tres atributos útiles (método, herramienta, tipo de error) y una regla precisa para tool_error. Lo demás se deriva: llamadas, fallos, percentiles. Fuentes: el repositorio de las convenciones GenAI y MCP y el README del conector span_metrics. Para la seguridad de estos servidores, consulta la auditoría de los servidores MCP.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Dynatrace es una marca de Dynatrace LLC. Estas convenciones están en desarrollo: comprueba siempre nombres, atributos y parámetros en la documentación oficial correspondiente a tu versión.