Le Cloudflare security audit skill est un skill pour agents de code qui transforme l’agent en auditeur de sécurité : il orchestre des agents isolés à travers six phases, de la reconnaissance du code au rapport. Le dépôt cloudflare/security-audit-skill compte environ 30 200 étoiles à la mi-octobre 2026. Le README le présente comme le point de départ, pour un seul dépôt, d’un système plus vaste de découverte de vulnérabilités décrit dans un billet du blog Cloudflare.
Un tel outil intéresse un SRE pour une raison pratique : un audit multi-agents est une charge de travail comme une autre, avec des tokens, du temps d’exécution et du code exécuté. Cet article explique ce que le dépôt documente, comment un skill s’installe, ses limites (faux positifs, périmètre) et ce qu’un audit automatisé ne remplace pas. Précision d’honnêteté : span.observer n’a pas lancé cet audit ; les commandes viennent du README et les captures sont des extraits rendus à partir des fichiers du dépôt. Aucune promesse de détection n’est faite ici.
Cloudflare security audit skill : ce que documente le dépôt
- Éditeur et licence : Cloudflare, licence MIT (fichier LICENSE, copyright 2025-2026 Cloudflare, Inc.).
- Chiffres relus le 16 octobre 2026 : environ 30 200 étoiles, environ 1 900 forks, 14 commits sur la branche principale, aucune release publiée.
- Contenu : un dossier
skills/security-audit/avec unSKILL.md, des fichiers d’instructions par phase et par famille de cibles (IA et LLM, protocoles web, chaîne d’approvisionnement, cloud…), un schéma JSON et deux validateurs Node.js sans dépendance.
Le dépôt est peu versionné (14 commits, aucune release) et le README parle d’un « point de départ » dont le système interne a évolué. Traitez-le comme une base de travail à relire, pas comme un produit éprouvé. Il ne dépend d’aucun produit Dynatrace ; la partie supervision s’applique à Dynatrace SaaS et à Dynatrace Managed car elle repose sur OpenTelemetry côté agent.
Les six phases d’un audit automatisé
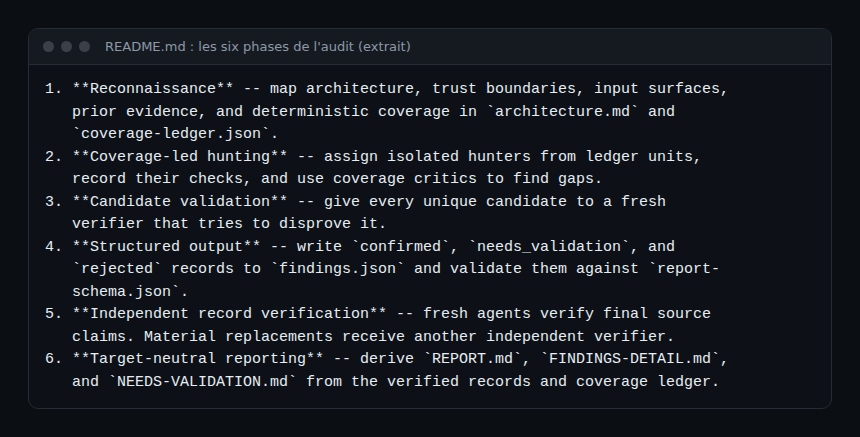
Trois idées structurent le workflow. Chaque candidat est confié à un vérificateur neuf qui tente de le réfuter : l’agent qui contrôle n’est jamais celui qui a trouvé. Les résultats portent un verdict distinct : confirmed (trace complète depuis la source et effet observé borné), needs_validation (un fait exact reste à établir, sans sévérité) ou rejected. Enfin, un registre de couverture (coverage-ledger.json) rend visible ce qui a été examiné et ce qui ne l’a pas été.
Installation d’un skill : pas à pas
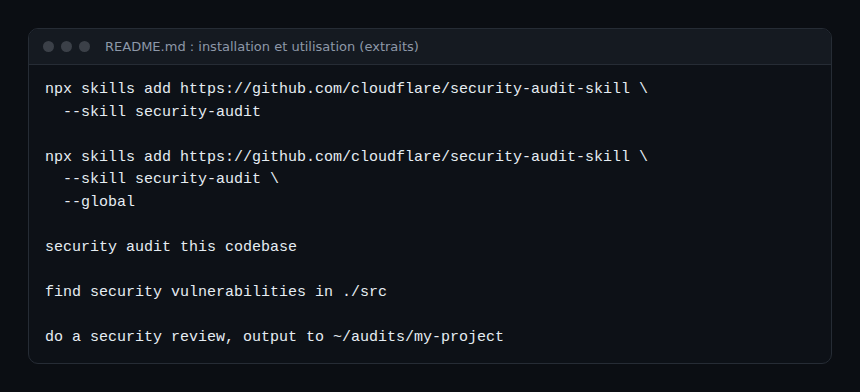
Un skill est un dossier dont le fichier SKILL.md porte un nom et une description. L’agent le charge quand la demande correspond. Le README installe celui-ci avec la CLI Skills (skills.sh) :
Étape 1 — Vérifier les prérequis
Il faut un agent dont le modèle gère les outils et les sous-agents en parallèle, Node.js pour les validateurs, et surtout un bac à sable appliqué par le système d’exploitation pour tout build, test ou processus venant de la cible. Le README en précise les exigences : pas de réseau externe, environnement assaini, limites de ressources et écriture limitée à un dossier de travail. Sans ces contrôles, le workflow garde la piste en needs_validation au lieu d’exécuter le code. L’isolation d’un agent est abordée dans garde-fous des agents IA en production et le runtime du projet NVIDIA OpenShell.
Étape 2 — Installer
Lancez la commande de la capture ci-dessus : npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit. L’option --global installe au niveau de l’utilisateur. npx skills --help liste le choix des agents et les options non interactives. Pour la structure d’un dépôt de skills dans un autre contexte, voir Dynatrace for AI : des skills pour agents de code.
Étape 3 — Lancer
Démarrez l’agent dans le code à auditer et demandez par exemple « security audit this codebase ». Le skill distingue deux modes : le mode guidance, par défaut pour les questions de sécurité, et le mode audit complet pour une demande explicite d’audit ou de rapport. En audit complet, le répertoire de sortie par défaut est ~/security-audit-skill/<repo-name>/run-<N>, hors du dépôt cible.
Limites : faux positifs, périmètre et reproductibilité
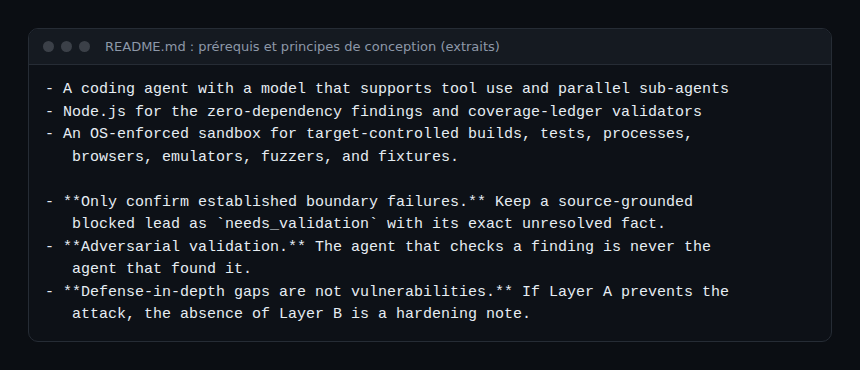
- Faux positifs. Le dépôt en limite le risque par construction (vérificateur adverse, verdict
needs_validation, « les lacunes de défense en profondeur ne sont pas des vulnérabilités »), mais le README ne publie aucun taux de faux positifs ni benchmark. À vous de mesurer sur votre code. - Faux négatifs. Le README indique que, dans les essais de l’équipe, un seul passage a trouvé environ la moitié de ce que des passages répétés ont trouvé au total. Un audit « propre » n’est pas une preuve d’absence de failles ; le skill demande d’ailleurs de ne jamais laisser croire qu’un passage épuise la cible.
- Périmètre. Approche source d’abord : pas de sondage de points d’accès déployés, pas de test sur un service partagé. Un fait qui dépend de la configuration de production, d’un proxy ou d’une politique d’identité absente du dépôt reste
needs_validation. - Profils et coût. Le skill définit des profils
quick,standardetdeepet un budget exprimé en nombre maximal d’invocations d’agents, noté dansrun-metadata.json.
Observer un audit multi-agents
Le budget du skill compte des invocations d’agents, pas des tokens ni des euros : à vous de relier les deux. Avec Claude Code, la métrique claude_code.token.usage exportée en OpenTelemetry permet de totaliser les tokens d’une session ; la documentation indique que le compteur porte aussi une attribution par agent, skill, plugin et MCP (vérifiez les noms d’attributs exacts dans la documentation avant de bâtir un tableau de bord). La mise en place est dans superviser un agent de code en entreprise, le raisonnement sur les tokens dans le coût d’un agent IA, et le choix d’un modèle capable d’outils et de sous-agents dans choisir son LLM. Si le code ne doit pas quitter votre infrastructure, voir la stack IA open source auto-hébergée.
Un autre risque est propre à l’exercice : l’agent lit du code non fiable. Un commentaire piégé dans la cible peut essayer de lui donner des instructions, ce qui rejoint l’empoisonnement d’outils MCP. D’où l’exigence de bac à sable du README, et l’intérêt de tracer les appels d’outils de la session.
Ce qu’un audit automatisé ne remplace pas
- La relecture humaine des constats : seul un enregistrement
confirmeda une sévérité, et un propriétaire du code doit le valider. - Les tests sur l’environnement déployé (configuration, réseau, identité), que le skill s’interdit par principe.
- L’analyse des dépendances et le suivi des correctifs, qui sont d’autres outils.
- La modélisation de menaces et l’exploitation : détection, supervision et réponse aux incidents restent nécessaires.
Comment vérifier que ça fonctionne
- Après l’installation, l’agent signale le skill
security-auditdans sa liste de skills. - Une demande d’audit crée un dossier
run-1contenantrun-metadata.json,architecture.mdetcoverage-ledger.json. - Un run terminé écrit
findings.json,REPORT.md,FINDINGS-DETAIL.mdetNEEDS-VALIDATION.md, ou bien noterun_status: "incomplete"avec sa raison.
Bonnes pratiques
- Commencez par un périmètre réduit et le profil
quicksur un dépôt de test. - Lancez plusieurs passages avant de conclure, et gardez les runs précédents.
- Traitez chaque constat comme une hypothèse à valider, sans chercher de coupable.
- Gardez les rapports hors du dépôt, avec des droits d’accès restreints.
Questions fréquentes
Ce skill remplace-t-il un test d’intrusion ?
Non. Il travaille sur le code source, sans sonder les systèmes déployés, et ses constats demandent une validation humaine.
Faut-il un abonnement Cloudflare ?
Le README n’en mentionne aucun : il demande un agent de code, Node.js et un bac à sable. Le skill est sous licence MIT.
Comment limiter le coût d’un audit ?
Choisissez un profil et un périmètre, fixez un budget d’invocations d’agents dans la demande, et mesurez les tokens consommés avec OpenTelemetry.
Conclusion
Le Cloudflare security audit skill formalise un audit en phases, avec vérification indépendante et verdicts distincts. C’est une base de travail intéressante et un bon exemple de ce qu’est un skill, à condition d’en connaître les limites : pas de taux de faux positifs publié, périmètre source, bac à sable indispensable. Mesurez-le comme n’importe quelle charge de travail. Sources : dépôt cloudflare/security-audit-skill.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets cités. Les marques citées appartiennent à leurs propriétaires. Les outils évoluent vite : vérifiez les commandes et options dans leur documentation officielle.