Une anomalie APM Elastic se règle en une règle d’alerte : Kibana compare la latence, le débit ou le taux d’échec d’un service à ce que ses modèles de machine learning jugent normal, puis notifie l’équipe d’astreinte. Le piège habituel est le bruit : une règle trop sensible réveille quelqu’un pour une variation sans conséquence, et une règle trop lâche rate la dégradation.
Ce tutoriel décrit la règle APM Anomaly pas à pas, d’après la documentation Elastic (version 8.16 et page actuelle). Il explique comment elle décide d’une anomalie, quels réglages limitent les fausses alertes et comment vérifier le résultat. L’objectif SRE : protéger l’error budget et réduire le MTTR sans multiplier les alertes inutiles.
Périmètre : Elastic Observability, hors Dynatrace. Pour comparer avec la détection d’anomalies de Dynatrace (Davis), voir la réduction du bruit d’alertes avec Davis.
Anomalie APM Elastic : comment la règle décide
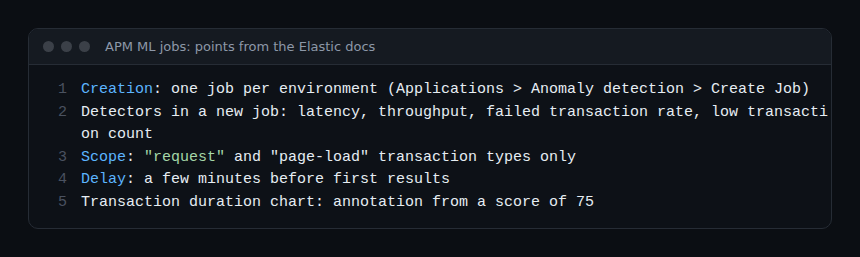
La règle ne calcule rien elle-même. Elle lit les résultats de jobs de machine learning, créés par environnement. D’après la documentation, les nouveaux jobs APM embarquent quatre détecteurs : latency, throughput, failed transaction rate et low transaction count. La détection ne s’applique qu’aux transactions de type « request » ou « page-load ».
Chaque anomalie reçoit un score. La documentation générale du machine learning indique que les scores vont de 0 à 100. La page APM précise un seul seuil chiffré : à partir de 75, le graphique de durée des transactions affiche une annotation. Elle ne définit pas la correspondance exacte entre score et niveaux de gravité ; je ne donne donc pas de bornes pour warning, minor, major et critical.
La règle compare donc la gravité de l’anomalie détectée au minimum que vous fixez. C’est un autre mécanisme qu’un seuil fixe : aucune valeur en millisecondes n’est à deviner. En contrepartie, le modèle a besoin de données : la documentation signale que les premiers résultats arrivent après quelques minutes, et que les services récents demandent plus de trafic tracé.
Prérequis
- Des traces APM dans Elasticsearch (les index
traces-apm*,apm-*ettraces-*.otel-*sont lus par la règle ; il n’est pas possible de les changer règle par règle). - Une licence adaptée : la documentation indique que le machine learning exige « an appropriate license ».
- Pour la version Stack, des privilèges pour les jobs de machine learning et pour l’application APM ; en Serverless, le rôle Editor ou supérieur.
- Un job d’anomalie créé pour l’environnement visé.
Créer le job de machine learning
- Ouvrez Applications, puis Anomaly detection.
- Sélectionnez Create Job et choisissez les environnements (par exemple production).
- Attendez quelques minutes les premiers résultats.
Un nouveau service dans un environnement déjà couvert n’exige pas de nouveau job. Un job existant garde ses détecteurs d’origine : pour obtenir low transaction count, la documentation demande d’ajouter le détecteur low_count ou de recréer le job.
Créer la règle APM Anomaly pas à pas
Le chemin dépend de la version. Pour Elastic Stack 9.0 à 9.5, la page décrit : Alerts, Manage Rules, Create rule, type APM Anomaly. À partir de 9.6, la création passe par l’interface Alerts et le bouton Create anomaly rule de la page Applications. Dans tous les cas, on peut aussi partir de Alerts and rules sur une page Applications.
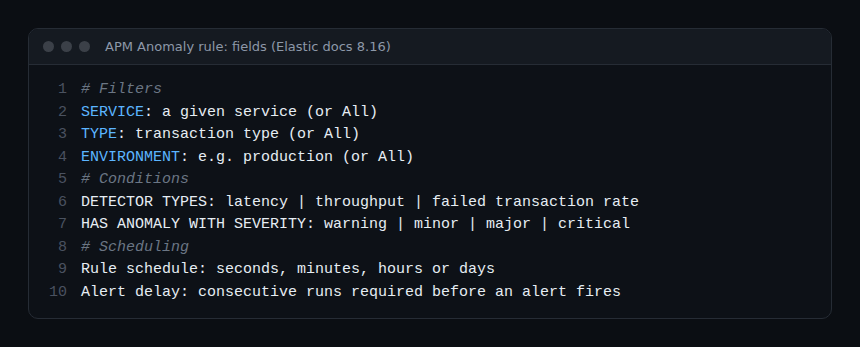
- Filtrer le périmètre. Choisissez Service, Type (type de transaction) et Environment, ou laissez All. Une règle par service critique donne des alertes plus lisibles qu’une règle globale.
- Choisir les détecteurs. Latence, débit, taux de transactions en échec, et (page actuelle) nombre de transactions bas.
- Fixer la gravité minimale (Has anomaly with severity) : warning, minor, major ou critical.
- Planifier. Indiquez la fréquence de contrôle ; la page 8.16 accepte secondes, minutes, heures ou jours.
- Ajouter une action avec un connecteur (e-mail, Slack, webhook, PagerDuty, Jira…), puis nommez la règle.
Réduire le bruit : les réglages qui comptent
Trois leviers, tous documentés, limitent les fausses alertes.
- La gravité minimale. Commencez par major pour réveiller quelqu’un, et gardez warning pour une notification non urgente dans un canal de discussion.
- Le délai d’alerte (Alert delay). Option avancée de la page 8.16 : l’alerte ne se déclenche qu’après le nombre d’exécutions consécutives indiqué. Un pic isolé ne suffit plus.
- La fréquence d’action. Choisissez un résumé des alertes à intervalle personnalisé plutôt qu’un message par alerte. Les actions peuvent aussi être limitées par une requête KQL (If alert matches query) ou par une plage horaire.
Ne retenez pas tous les détecteurs partout. Le débit d’un service batch nocturne varie par nature ; sur celui-ci, la latence et le taux d’échec suffisent. Et gardez en tête que low transaction count signale aussi les chutes à zéro : utile pour un service censé recevoir du trafic en continu, bruyant pour une API appelée une fois par jour.
Écrire l’action avec les variables de contexte
Un message utile contient le service, l’environnement, la raison et le lien de diagnostic. La documentation liste les variables disponibles, avec la syntaxe Mustache (doubles accolades autour du nom, par exemple pour context.serviceName).
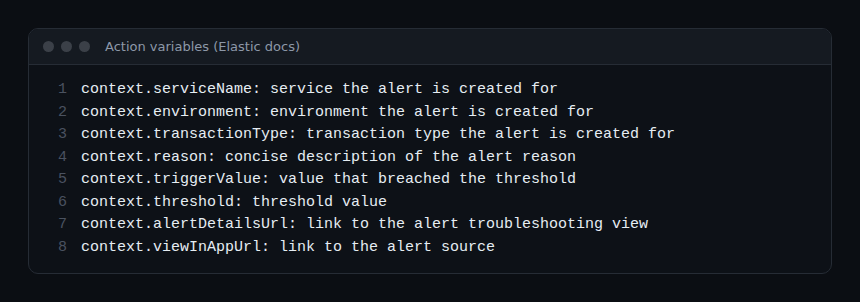
Attention à context.alertDetailsUrl : d’après la page 8.16, la variable reste vide si server.publicBaseUrl n’est pas configuré dans Kibana. Une alerte sans lien d’ouverture rallonge le MTTR : vérifiez ce réglage avant d’envoyer la règle en production. Un connecteur peut être payant ou gratuit selon son type, ce que précise la documentation.
Comment vérifier que ça fonctionne
- Dans Applications, ouvrez le service : le graphique de durée des transactions montre les bornes attendues et une annotation à partir d’un score de 75.
- Sur la carte des services et l’inventaire, un service avec anomalie active est coloré (inventaire : Stack 9.5 et suivants, Serverless).
- Dans Alerts, contrôlez que la règle est active et que l’exécution se fait à l’intervalle choisi.
- Sur une alerte, ouvrez la page de détail : pour une alerte APM Anomaly, la documentation décrit des graphiques RED, la carte des services et un encadré de gravité.
Faites le test sur un environnement de préproduction, avec une gravité minimale basse, puis relevez après une semaine combien d’alertes ont mené à une action. Si la majorité n’en demande aucune, montez la gravité ou ajoutez un délai.
Lien avec OpenTelemetry et Dynatrace
La règle lit les index traces-*.otel-* : des traces OpenTelemetry ingérées dans Elastic entrent donc dans son périmètre (voir l’agent Elastic et le collecteur OpenTelemetry). Pour la migration d’un agent propriétaire, voir la migration vers OpenTelemetry, et pour relier traces et logs, la corrélation logs et traces Elastic APM. Côté Dynatrace, l’équivalent repose sur Davis ; la différence de principe est traitée dans observabilité et monitoring. Aucune intégration entre cette règle et Dynatrace n’est documentée : un webhook est le seul pont simple.
Bonnes pratiques
- Une règle par service critique et par environnement, avec un responsable nommé.
- Une gravité minimale haute pour l’astreinte, basse pour l’information.
- Un Alert delay de plusieurs exécutions plutôt qu’une alerte au premier pic.
- Un lien
alertDetailsUrltoujours rempli. - Après chaque mise à jour, relisez les règles existantes : elles conservent leurs détecteurs enregistrés.
Questions fréquentes
Faut-il un job de machine learning pour la règle APM Anomaly ?
Oui. La règle lit les résultats des jobs (index .ml-anomalies-*) : sans job pour l’environnement, elle n’a rien à évaluer.
Quelle différence entre cette règle et un seuil de latence ?
Un seuil fixe compare une valeur à un nombre que vous choisissez. La règle APM Anomaly compare à un comportement appris. Elle s’adapte aux cycles du service, mais demande des données et ne dit pas pourquoi la valeur a changé.
Les règles existantes reçoivent-elles les nouveaux détecteurs ?
Non. Selon la documentation, elles gardent leurs sélections enregistrées : modifiez-les pour ajouter low transaction count, après avoir vérifié que le job contient low_count.
Conclusion
La règle APM Anomaly remplace des seuils devinés par un modèle appris. Le résultat tient à trois réglages : un job par environnement, une gravité minimale cohérente avec l’astreinte et un délai d’alerte. Vérifiez la chaîne complète, du score au lien de l’alerte, avant d’y confier un service critique.
Sources
- Create an APM anomaly rule, documentation Elastic (consultée le 30 octobre 2026)
- APM anomaly rule, documentation Elastic 8.16
- Machine learning APM, documentation Elastic
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Les noms de produits cités appartiennent à leurs propriétaires respectifs ; les valeurs viennent de la documentation Elastic, à vérifier pour votre version.