Una anomalía APM de Elastic se configura con una regla de alerta: Kibana compara la latencia, el rendimiento o la tasa de fallos de un servicio con lo que sus modelos de machine learning consideran normal y luego avisa al equipo de guardia. La trampa habitual es el ruido: una regla demasiado sensible despierta a alguien por una variación sin consecuencias, y una regla demasiado laxa no detecta la degradación.
Este tutorial describe la regla APM Anomaly paso a paso, según la documentación de Elastic (versión 8.16 y página actual). Explica cómo decide que hay una anomalía, qué ajustes limitan las falsas alertas y cómo comprobar el resultado. El objetivo SRE: proteger el error budget y reducir el MTTR sin multiplicar las alertas inútiles.
Alcance: Elastic Observability, fuera de Dynatrace. Para comparar con la detección de anomalías de Dynatrace (Davis), consulta la reducción del ruido de alertas con Davis.
Anomalía APM de Elastic: cómo decide la regla
La regla no calcula nada por sí misma. Lee los resultados de jobs de machine learning, creados por entorno. Según la documentación, los nuevos jobs APM incluyen cuatro detectores: latency, throughput, failed transaction rate y low transaction count. La detección solo se aplica a las transacciones de tipo «request» o «page-load».
Cada anomalía recibe una puntuación. La documentación general del machine learning indica que las puntuaciones van de 0 a 100. La página de APM precisa un único umbral numérico: a partir de 75, el gráfico de duración de las transacciones muestra una anotación. No define la correspondencia exacta entre puntuación y niveles de gravedad; por eso no doy límites para warning, minor, major y critical.
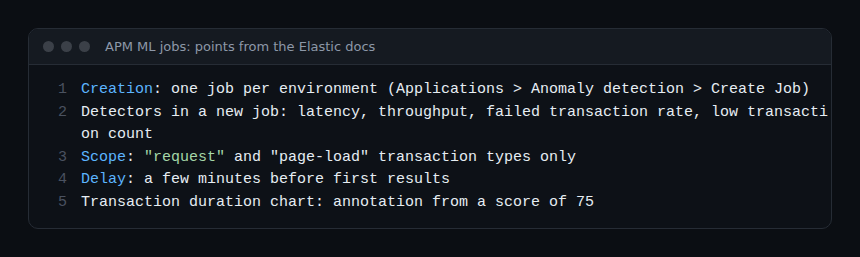
La regla compara, por tanto, la gravedad de la anomalía detectada con el mínimo que fijes. Es un mecanismo distinto de un umbral fijo: no hay que adivinar ningún valor en milisegundos. A cambio, el modelo necesita datos: la documentación señala que los primeros resultados llegan al cabo de unos minutos y que los servicios recientes requieren más tráfico trazado.
Requisitos previos
- Trazas APM en Elasticsearch (la regla lee los índices
traces-apm*,apm-*ytraces-*.otel-*; no se pueden cambiar regla por regla). - Una licencia adecuada: la documentación indica que el machine learning exige «an appropriate license».
- Para la versión Stack, privilegios para los jobs de machine learning y para la aplicación APM; en Serverless, el rol Editor o superior.
- Un job de anomalías creado para el entorno que quieres vigilar.
Crear el job de machine learning
- Abre Applications y luego Anomaly detection.
- Selecciona Create Job y elige los entornos (por ejemplo, production).
- Espera unos minutos a los primeros resultados.
Un servicio nuevo en un entorno ya cubierto no exige un job nuevo. Un job existente conserva sus detectores originales: para obtener low transaction count, la documentación pide añadir el detector low_count o volver a crear el job.
Crear la regla APM Anomaly paso a paso
La ruta depende de la versión. Para Elastic Stack 9.0 a 9.5, la página describe: Alerts, Manage Rules, Create rule, tipo APM Anomaly. A partir de 9.6, la creación pasa por la interfaz Alerts y el botón Create anomaly rule de la página Applications. En todos los casos, también se puede empezar desde Alerts and rules en una página de Applications.
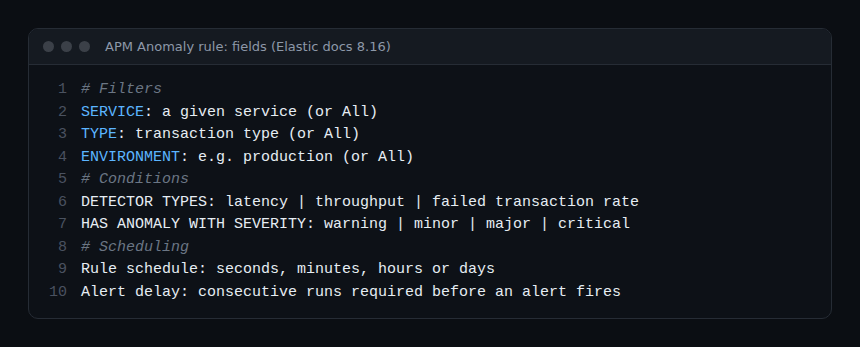
- Filtrar el alcance. Elige Service, Type (tipo de transacción) y Environment, o deja All. Una regla por servicio crítico da alertas más legibles que una regla global.
- Elegir los detectores. Latencia, rendimiento, tasa de transacciones fallidas y (página actual) recuento bajo de transacciones.
- Fijar la gravedad mínima (Has anomaly with severity): warning, minor, major o critical.
- Programar. Indica la frecuencia de comprobación; la página 8.16 admite segundos, minutos, horas o días.
- Añadir una acción con un conector (correo, Slack, webhook, PagerDuty, Jira…) y ponle nombre a la regla.
Reducir el ruido: los ajustes que cuentan
Tres palancas, todas documentadas, limitan las falsas alertas.
- La gravedad mínima. Empieza por major para despertar a alguien y reserva warning para una notificación no urgente en un canal de chat.
- El retraso de alerta (Alert delay). Opción avanzada de la página 8.16: la alerta solo se activa tras el número indicado de ejecuciones consecutivas. Un pico aislado ya no basta.
- La frecuencia de acción. Elige un resumen de las alertas a intervalo personalizado en lugar de un mensaje por alerta. Las acciones también pueden limitarse con una consulta KQL (If alert matches query) o con un intervalo horario.
No actives todos los detectores en todas partes. El rendimiento de un servicio batch nocturno varía por naturaleza; en ese caso bastan la latencia y la tasa de fallos. Y ten presente que low transaction count también señala las caídas a cero: útil para un servicio que debe recibir tráfico de forma continua, ruidoso para una API que se llama una vez al día.
Escribir la acción con las variables de contexto
Un mensaje útil contiene el servicio, el entorno, el motivo y el enlace de diagnóstico. La documentación enumera las variables disponibles, con la sintaxis Mustache (dobles llaves alrededor del nombre, por ejemplo para context.serviceName).
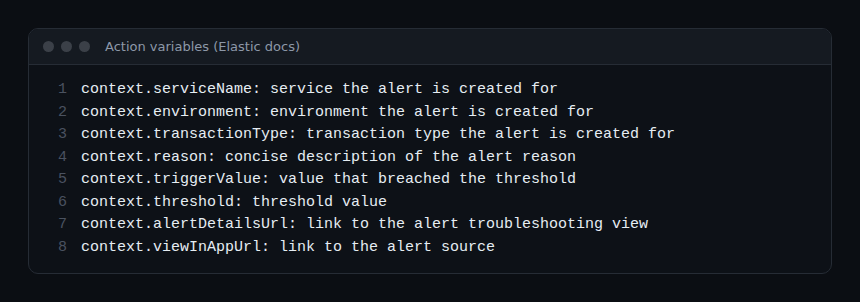
Atención a context.alertDetailsUrl: según la página 8.16, la variable queda vacía si server.publicBaseUrl no está configurado en Kibana. Una alerta sin enlace de apertura alarga el MTTR: comprueba este ajuste antes de enviar la regla a producción. Un conector puede ser de pago o gratuito según su tipo, algo que precisa la documentación.
Cómo comprobar que funciona
- En Applications, abre el servicio: el gráfico de duración de las transacciones muestra los límites esperados y una anotación a partir de una puntuación de 75.
- En el mapa de servicios y en el inventario, un servicio con una anomalía activa aparece coloreado (inventario: Stack 9.5 y posteriores, Serverless).
- En Alerts, comprueba que la regla está activa y que se ejecuta con el intervalo elegido.
- En una alerta, abre la página de detalle: para una alerta APM Anomaly, la documentación describe gráficos RED, el mapa de servicios y un recuadro de gravedad.
Haz la prueba en un entorno de preproducción, con una gravedad mínima baja, y después de una semana cuenta cuántas alertas llevaron a una acción. Si la mayoría no requiere ninguna, sube la gravedad o añade un retraso.
Relación con OpenTelemetry y Dynatrace
La regla lee los índices traces-*.otel-*: las trazas de OpenTelemetry ingeridas en Elastic entran, por tanto, en su alcance (consulta el agente de Elastic y el collector de OpenTelemetry). Para la migración desde un agente propietario, consulta la migración a OpenTelemetry y, para relacionar trazas y logs, la correlación de logs y trazas en Elastic APM. En Dynatrace, el equivalente se basa en Davis; la diferencia de principio se trata en observabilidad y monitorización. No hay documentada ninguna integración entre esta regla y Dynatrace: un webhook es el único puente sencillo.
Buenas prácticas
- Una regla por servicio crítico y por entorno, con un responsable designado.
- Una gravedad mínima alta para la guardia, baja para la información.
- Un Alert delay de varias ejecuciones en lugar de una alerta al primer pico.
- Un enlace
alertDetailsUrlsiempre relleno. - Tras cada actualización, revisa las reglas existentes: conservan sus detectores guardados.
Preguntas frecuentes
¿Hace falta un job de machine learning para la regla APM Anomaly?
Sí. La regla lee los resultados de los jobs (índices .ml-anomalies-*): sin un job para el entorno, no tiene nada que evaluar.
¿Qué diferencia hay entre esta regla y un umbral de latencia?
Un umbral fijo compara un valor con un número que eliges tú. La regla APM Anomaly compara con un comportamiento aprendido. Se adapta a los ciclos del servicio, pero necesita datos y no dice por qué cambió el valor.
¿Las reglas existentes reciben los nuevos detectores?
No. Según la documentación, conservan sus selecciones guardadas: edítalas para añadir low transaction count, después de comprobar que el job contiene low_count.
Conclusión
La regla APM Anomaly sustituye umbrales adivinados por un modelo aprendido. El resultado depende de tres ajustes: un job por entorno, una gravedad mínima coherente con la guardia y un retraso de alerta. Comprueba la cadena completa, de la puntuación al enlace de la alerta, antes de confiarle un servicio crítico.
Fuentes
- Create an APM anomaly rule, documentación de Elastic (consultada el 30 de octubre de 2026)
- APM anomaly rule, documentación de Elastic 8.16
- Machine learning APM, documentación de Elastic
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Los nombres de productos citados pertenecen a sus respectivos propietarios; los valores proceden de la documentación de Elastic y conviene comprobarlos en la de tu versión.