La taille shard Elasticsearch décide de la vitesse de vos recherches, de la mémoire consommée par le cluster et de la facilité de vos opérations. Trop petits, les shards s’accumulent et saturent le nœud maître. Trop gros, ils ralentissent la récupération après incident. Cet article rassemble les repères officiels et vous guide pour les appliquer avec le rollover ILM.
Objectif : fixer une taille cible, l’automatiser dans une politique ILM, puis contrôler le résultat. Les chiffres ci-dessous viennent de la page Size your Elasticsearch shards (page consultée le 30 octobre 2026, sans numéro de version affiché). Ce sont des repères d’Elastic, pas des mesures de span.observer : testez-les avec vos données.
En bref
- Selon Elastic, visez des shards de 10 Go à 50 Go et moins de 200 millions de documents par shard.
- Le piège classique est le sur-découpage (oversharding) : beaucoup de petits shards coûtent plus cher qu’un seul gros.
- Le rollover par taille (
max_primary_shard_size) évite les index minuscules créés « à heure fixe ». - Les shards sont immuables : corriger une mauvaise taille impose de copier l’index (Split ou Reindex).
Taille shard Elasticsearch : les repères officiels
La documentation donne trois repères. D’abord la taille : « aim for shard sizes between 10GB and 50GB ». Ensuite le nombre de documents : gardez-le sous 200 millions par shard. Enfin la limite dure de Lucene, 2 147 483 519 documents par shard (documents supprimés compris), très au-dessus de la recommandation.
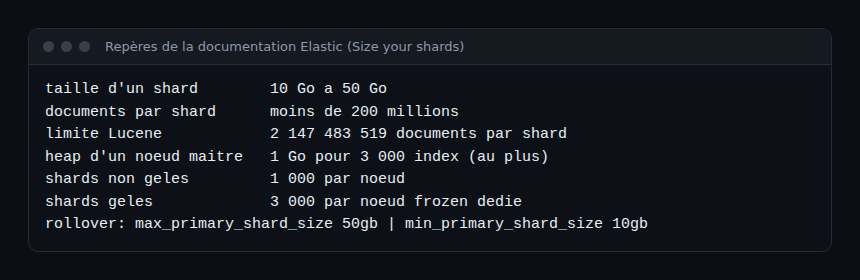
Le même document fixe des limites de cluster : 1 000 shards non gelés par nœud, et 3 000 shards gelés par nœud frozen dédié. Côté nœuds maîtres, il indique au plus 3 000 index par Go de heap. Un maître avec 4 Go de heap supporte donc moins de 12 000 index, avant de compter la mémoire de base.
Pour un SRE, le lien avec la fiabilité est direct. Un cluster qui dépasse ces limites ralentit à chaque changement d’état, et ce ralentissement dégrade vos SLO de recherche avant que l’alerte ne sonne. Voyez aussi notre guide pour superviser Elasticsearch avec Dynatrace.
Pourquoi trop de petits shards coûtent cher
Chaque shard a un coût fixe en mémoire et en travail de recherche. L’exemple d’Elastic parle de lui-même : chercher dans mille shards de 50 Mo coûte « substantiellement » plus que chercher dans un shard de 50 Go contenant les mêmes données.
Plusieurs remèdes existent, selon la page : réduire le nombre de shards avec Shrink, réindexer des index de courte période vers des index de période plus longue, et supprimer les index vides. Le force merge diminue aussi le nombre de segments, mais il consomme beaucoup de ressources. Lancez-le hors heures de pointe, sur des index où vous n’écrivez plus.
À l’inverse, des shards trop gros n’apparaissent pas dans ces limites : la page ne chiffre pas leur effet sur la récupération. Nous ne l’affirmons donc pas ici ; mesurez le temps de relocalisation sur votre cluster.
Piloter la taille avec le rollover ILM
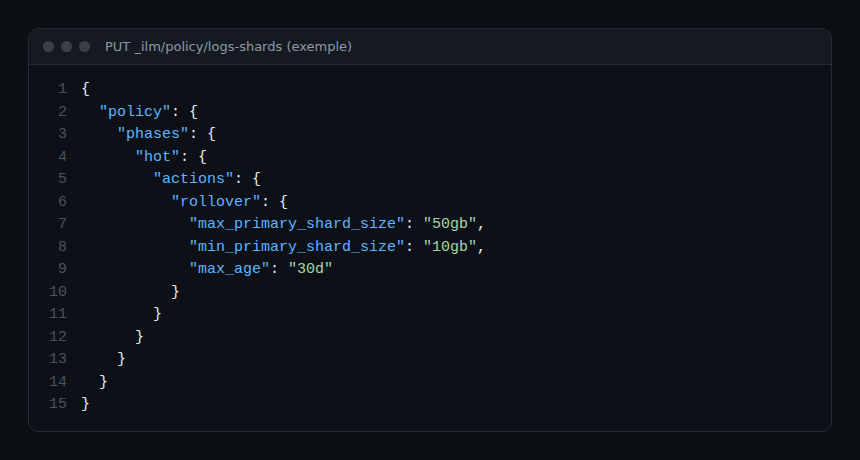
Le moyen le plus simple de tenir la cible est le rollover dans la phase hot d’une politique ILM. D’après la référence de l’action rollover, l’action exige au moins une condition max_*, et le rollover se produit quand une condition max_* est atteinte et que toutes les conditions min_* le sont aussi.
PUT _ilm/policy/logs-shards
{
  "policy": {
    "phases": {
      "hot": {
        "actions": {
          "rollover": {
            "max_primary_shard_size": "50gb",
            "min_primary_shard_size": "10gb",
            "max_age": "30d"
          }
        }
      }
    }
  }
}
Cette politique est un exemple construit à partir des options documentées ; la valeur 30 jours est un choix de l’auteur, pas une recommandation d’Elastic. Les deux seuils de taille reprennent ceux de la page « Size your shards » : 50 Go en maximum, 10 Go en minimum pour éviter des shards trop petits.
Points d’attention sur les options
max_primary_shard_sizevise le plus gros shard primaire, réplicas ignorés.max_size, lui, est signalé comme déprécié depuis la version 9.3, avecmax_primary_shard_sizecomme remplaçant.- Un shard qui atteint 200 000 000 de documents déclenche un rollover implicite. Un
max_primary_shard_docssupérieur n’a aucun effet. - Un index vide n’est pas basculé par défaut, même si
max_ageest atteint. Ajoutez"min_docs": 0pour l’autoriser. - Elastic déconseille de baser le rollover seulement sur le temps : cela produit souvent de nombreux petits index.
Étapes : auditer vos shards puis corriger
- Inventorier les shards, des plus gros aux plus petits, avec l’API cat shards.
- Repérer les index sous 10 Go et ceux au-dessus de 50 Go.
- Appliquer une politique ILM de rollover par taille aux nouveaux index.
- Corriger l’existant par Shrink, Reindex ou Split selon le cas.
- Surveiller le nombre de shards par nœud dans la durée.
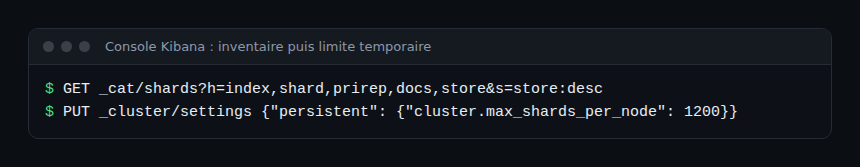
GET _cat/shards?h=index,shard,prirep,docs,store&s=store:descLes colonnes index, shard, prirep (primaire ou réplica), docs et store figurent dans la référence de l’API. Le paramètre s trie la sortie. Cherchez les lignes dont store est très petit, signe de sur-découpage.
Si le cluster atteint la limite par nœud, Elastic cite l’exemple d’un cluster.max_shards_per_node relevé à 1200, mais précise que ce réglage doit rester temporaire. Il masque le problème sans le résoudre.
Corriger des shards déjà mal dimensionnés
Les shards sont immuables. Pour changer leur nombre ou leur taille, il faut copier l’index : Split pour ajouter des shards primaires, Reindex vers un index bien configuré pour regrouper. Selon la page, Restore Snapshot et Clone Index ne suffisent pas pour cet usage.
Comment vérifier que ça fonctionne
Après quelques cycles de rollover, relancez la requête _cat/shards. Les nouveaux index doivent se situer entre 10 Go et 50 Go par shard primaire. Si beaucoup d’index restent minuscules, vérifiez la condition max_age et ajoutez un seuil min_primary_shard_size. Dans Dynatrace, vous pouvez suivre le nombre de shards et la latence de recherche via l’extension décrite dans l’article ci-dessus (SaaS ou Managed selon l’extension déployée).
Lien avec OpenTelemetry et vos données d’observabilité
Les traces, métriques et logs d’OpenTelemetry arrivent en volume variable : un pic de trafic produit un pic d’indexation. Un rollover par taille s’adapte à ce rythme, alors qu’un index quotidien non. Pour réduire le volume avant l’index, voyez le tail sampling OpenTelemetry, et pour la différence entre signaux, observabilité et monitoring. Pour comparer les plateformes, notre comparatif Dynatrace et Datadog pose les critères d’exploitation.
Bonnes pratiques
- Partez d’une cible de 10 à 50 Go et ajustez avec vos propres tests de charge.
- Préférez le rollover par taille ou par nombre de documents au rollover purement temporel.
- N’utilisez le relèvement de
max_shards_per_nodeque comme mesure temporaire. - Planifiez le force merge hors pointe, sur des index en lecture seule.
- Documentez la taille cible dans votre runbook, sans blâmer l’équipe qui a créé les index existants.
Questions fréquentes
Quelle est la taille idéale d’un shard Elasticsearch ?
Elastic recommande entre 10 Go et 50 Go, avec moins de 200 millions de documents par shard. C’est un repère : le bon chiffre dépend de vos requêtes et de votre matériel.
Que se passe-t-il si mes shards sont trop petits ?
Le cluster porte un coût fixe par shard, et les recherches parcourent plus de shards. Regroupez-les avec Shrink ou Reindex, et évitez le rollover purement temporel.
Puis-je changer la taille d’un shard existant ?
Non, un shard est immuable. Il faut copier l’index avec Split ou Reindex vers un index correctement configuré.
Conclusion
Retenez une règle : 10 à 50 Go par shard, un rollover par taille, un audit régulier avec _cat/shards. Les valeurs exactes restent à valider sur vos données. Les limites et options citées viennent des pages officielles d’Elastic consultées le 30 octobre 2026.
Cet article provient d’un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Elasticsearch est une marque d’Elastic N.V. Les chiffres cités sont ceux de la documentation officielle, pas des mesures de span.observer.