Choisir son LLM en octobre 2026 en se fiant aux classements publics revient à choisir un serveur sur sa fiche commerciale. Les benchmarks mesurent un modèle seul, sur des questions qui ne sont pas les vôtres, sans réseau, sans quotas et sans contrainte de localisation des données. Ce qui fait tomber un service en production est ailleurs : une latence de premier token qui double aux heures de pointe, un fournisseur qui traite les données hors de l’Union européenne, une instrumentation impossible à brancher sur la supervision existante.
Cet article propose une grille de choix centrée sur l’exploitation : latence, hébergement, RGPD, observabilité et coût. Il ne donne pas de classement et ne cite aucun prix : les tarifs changent trop souvent et doivent se lire sur les pages des fournisseurs le jour de la décision. Les caractéristiques citées viennent des documentations officielles consultées en octobre 2026.
La méthode proposée se termine par un pilote instrumenté avec OpenTelemetry, qui compare les modèles candidats sur vos propres requêtes. Pour le cadre général, voir notre article pilier sur l’observabilité de l’IA.
Pourquoi les benchmarks ne suffisent pas
Un benchmark répond à la question « ce modèle sait-il faire ? ». L’exploitation pose d’autres questions : répond-il assez vite au 95e centile, que se passe-t-il quand le fournisseur limite le débit, où sont traitées les données, peut-on voir chaque appel dans une trace, combien coûte une tâche complète et pas seulement un million de tokens ? Deux modèles proches au classement peuvent avoir des profils d’exploitation très différents. Les exigences SRE des charges IA s’appliquent dès le choix du modèle.
Choisir son LLM : la grille de critères d’exploitation
1. Latence : premier token, débit, file d’attente
Pour une interface conversationnelle, le temps jusqu’au premier token (TTFT) compte davantage que la durée totale. Pour un agent qui enchaîne dix appels, c’est la durée de bout en bout qui compte. Mesurez les deux, au 95e centile, à l’heure de pointe.
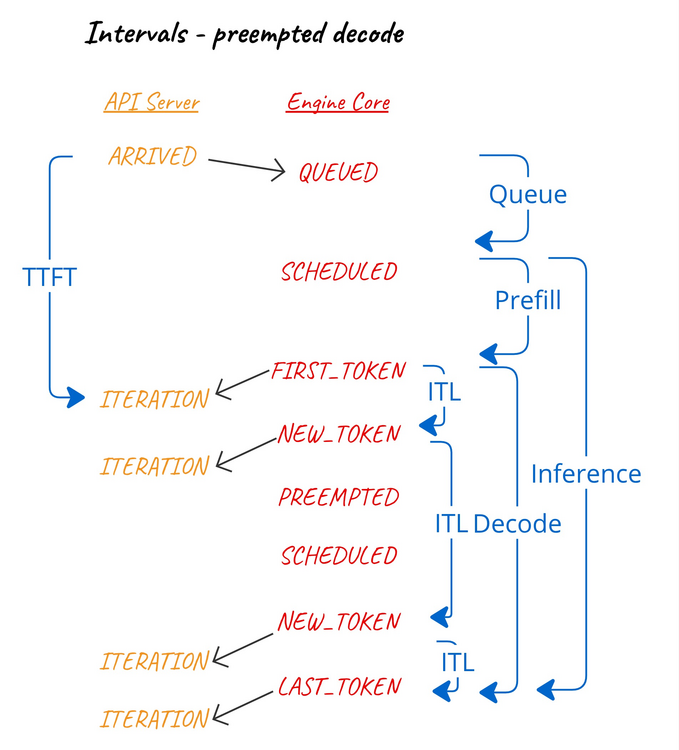
Le schéma ci-dessus, tiré de la documentation de conception de vLLM, montre ce qu’un TTFT contient : file d’attente, prefill, puis génération. Sur un modèle auto-hébergé, vLLM expose ces intervalles en métriques Prometheus (vllm:time_to_first_token_seconds, vllm:inter_token_latency_seconds, vllm:request_queue_time_seconds, vllm:e2e_request_latency_seconds). Voir vLLM en production.
2. Hébergement : API, cloud ou auto-hébergé
- API du fournisseur : rien à exploiter côté GPU, mais une dépendance externe avec ses quotas et ses incidents.
- Modèle via un hyperscaler : la région est fixée par le point de terminaison. La documentation d’Anthropic précise par exemple que, sur Amazon Bedrock et Google Cloud, la région d’inférence est déterminée par l’URL du point de terminaison ou le profil d’inférence.
- Auto-hébergé : nécessite un modèle à poids ouverts et une licence compatible. Mistral publie, dans sa liste de modèles, la licence de chacun : Mistral Small 4 et la famille Ministral 3 (3B, 8B, 14B) sont sous Apache 2.0, Mistral Medium 3.5 sous une licence MIT modifiée. vLLM sert ces modèles derrière un serveur compatible avec l’API OpenAI (
vllm serve), et Ollama couvre les usages plus légers.
3. RGPD et localisation des données
Les trois fournisseurs consultés proposent des contrôles, avec des conditions différentes :
- Mistral AI : selon son centre d’aide, les données sont hébergées par défaut dans l’Union européenne ; l’utilisation explicite du point de terminaison américain les héberge aux États-Unis. Certaines fonctions peuvent transférer temporairement des données hors UE, vers les sous-traitants listés dans son Trust Center.
- OpenAI : les contrôles de résidence des données sont une option de projet, soumise à éligibilité auprès de l’équipe commerciale. La région Europe (EEE + Suisse) utilise
eu.api.openai.com. La documentation mentionne une majoration de 10 % sur ces points de terminaison pour les modèles éligibles sortis à partir du 5 mars 2026, et exclut les données système (compte, facturation, statistiques d’usage). - Anthropic : le paramètre
inference_geochoisit où s’exécute l’inférence (globalpar défaut, ouus), sur les modèles Claude 4.6 et suivants ; la géographie de stockage de l’espace de travail est aujourd’hui uniquementus.
Vérifiez ces conditions dans le contrat et l’accord de traitement des données (DPA) : une page de documentation ne remplace pas l’avis de votre DPO.
4. Observabilité
Un modèle qu’on ne peut pas tracer est un modèle qu’on ne peut pas exploiter. Questions à poser : existe-t-il une instrumentation OpenTelemetry pour son SDK (OpenLLMetry, OpenLIT, instrumentation du framework) ? La réponse de l’API renvoie-t-elle l’usage en tokens ? Anthropic renvoie même, dans l’objet usage, un champ inference_geo qui indique où l’inférence a tourné : utile pour prouver la localisation. Les conventions OpenTelemetry GenAI prévoient des valeurs connues pour gen_ai.provider.name, dont openai, anthropic, mistral, aws.bedrock, gcp.vertex_ai et azure.ai.openai. Côté Dynatrace, l’application AI Observability cite OpenAI, Anthropic, Gemini, Amazon Bedrock, Azure AI Foundry et Vertex AI parmi les plateformes couvertes.
5. Coût par tâche, pas par token
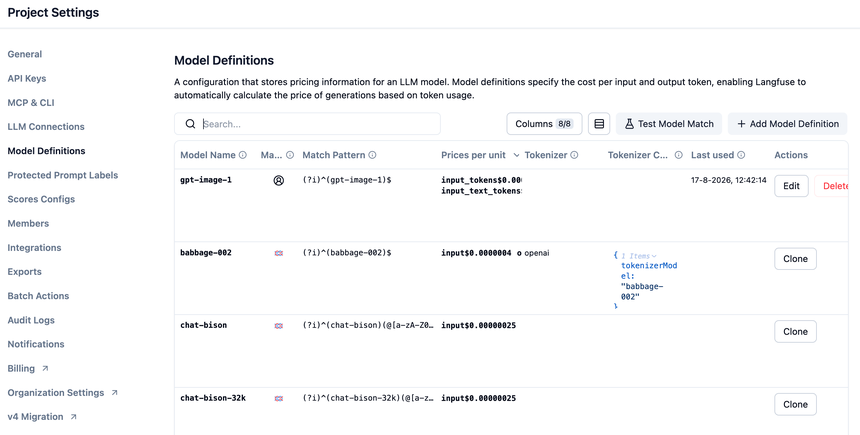
Le prix public est exprimé par million de tokens ; votre coût réel dépend du nombre de tokens qu’un modèle consomme pour accomplir une tâche, des tokens de raisonnement, du cache et des majorations régionales. Un outil comme Langfuse stocke les prix par modèle dans des définitions et calcule le coût de chaque génération à partir de l’usage réel.
En pratique : un pilote instrumenté en cinq étapes
Étape 1 — Constituer un jeu de requêtes réel
Extrayez 100 à 300 requêtes représentatives de votre usage, anonymisées. C’est votre benchmark à vous.
Étape 2 — Instrumenter une seule fois
Passez les requêtes par le même code, instrumenté avec OpenTelemetry, en ne changeant que le modèle. Chaque span porte gen_ai.request.model, gen_ai.provider.name et gen_ai.usage.input_tokens / output_tokens.
Étape 3 — Comparer les modèles dans Dynatrace SaaS
fetch spans
| filter gen_ai.operation.name == "chat"
| summarize requetes = count(),
            p95 = percentile(duration, 95),
            erreurs = countIf(span.status_code == "error"),
            entree_moy = avg(gen_ai.usage.input_tokens),
            sortie_moy = avg(gen_ai.usage.output_tokens),
            by:{gen_ai.request.model}
Cette requête DQL vaut pour Dynatrace SaaS (Grail). Sur Dynatrace Managed, sans DQL, faites la même comparaison dans un outil open source comme Langfuse ou via les métriques de votre pile Prometheus.
Étape 4 — Noter la qualité
Faites relire un échantillon de réponses par les utilisateurs métier, ou utilisez une évaluation automatique. Un modèle rapide et bon marché qui répond faux n’est pas un bon choix.
Étape 5 — Décider avec une grille pondérée
Attribuez un poids à chaque critère selon le service : conformité éliminatoire pour des données de santé, TTFT prioritaire pour un assistant, coût par tâche prioritaire pour un traitement par lots. Consignez le résultat : le choix sera à refaire dans six mois.
Comment vérifier que le pilote est fiable
- Chaque modèle a reçu le même nombre de requêtes (colonne
requetes). - Les totaux de tokens concordent avec la console d’usage de chaque fournisseur.
- Les mesures ont été prises à plusieurs moments, dont l’heure de pointe.
Bonnes pratiques
- Gardez une couche d’abstraction (API compatible OpenAI, passerelle) pour pouvoir changer de modèle sans réécrire l’application.
- Prévoyez un modèle de repli et testez la bascule.
- Fixez la version exacte du modèle en production ; surveillez
gen_ai.response.model. - Relisez la politique de cycle de vie du fournisseur : un modèle retiré impose une migration.
- Rejouez le pilote à chaque nouvelle version importante.
Questions fréquentes
Faut-il forcément un modèle auto-hébergé pour respecter le RGPD ?
Non. Plusieurs fournisseurs proposent un traitement en Europe, sous conditions. L’auto-hébergement donne le contrôle total mais transfère l’exploitation des GPU à votre équipe : voir une pile IA auto-hébergée.
Pourquoi ne pas donner de prix ?
Parce qu’ils changent souvent et dépendent de la région, du cache et du volume. Mesurez le coût par tâche pendant le pilote, avec les prix du jour.
Combien de modèles comparer ?
Deux ou trois suffisent : un modèle de pointe, un modèle plus léger et, si les données l’exigent, un modèle à poids ouverts auto-hébergé.
Conclusion
Choisir son LLM, c’est choisir un composant de production. La latence au 95e centile, la localisation des données, la capacité à tracer chaque appel et le coût par tâche décident plus sûrement que le rang dans un classement. Un pilote instrumenté avec OpenTelemetry, sur vos propres requêtes, transforme ce choix en décision mesurée et facile à refaire.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC ni aux projets ou fournisseurs cités. Les marques citées appartiennent à leurs propriétaires. Les offres évoluent vite : vérifiez les conditions et options dans leur documentation officielle.