Le DQL group by n’existe pas sous ce nom : dans Dynatrace Query Language, le regroupement se fait avec la commande summarize et son paramètre by:{}. Si vous venez de SQL, vous cherchez le réflexe SELECT … GROUP BY … ; en DQL, vous écrivez une agrégation, puis la liste des clés de regroupement, dans une seule commande placée dans le pipeline.
Ce guide montre la traduction pas à pas : une clé, plusieurs clés, les alias, le groupe null qui apparaît quand un champ manque, le regroupement par tranche de temps ou de valeur avec bin(), et l’équivalent du HAVING. Chaque syntaxe vient de la documentation DQL officielle, consultée en octobre 2026.
Le contenu vaut pour Dynatrace SaaS (plateforme Grail). Dynatrace Managed n’a ni Grail ni DQL : on y regroupe avec les métriques et le Data Explorer. Pour une vue d’ensemble des commandes, voir les commandes DQL commentées ; pour des requêtes prêtes à copier, voir nos requêtes DQL d’exploitation.
DQL group by : la correspondance avec SQL
La syntaxe documentée de la commande est la suivante :
summarize [field =] aggregation, ... [, by: {[field =] expression, ...}]Trois différences avec SQL comptent au quotidien :
- Pas de SELECT séparé : le résultat contient uniquement les clés du
byet les agrégats. Les autres champs disparaissent. - L’ordre est celui du pipeline : le
filterplacé avantsummarizejoue le rôle duWHERE, celui placé après joue le rôle duHAVING. - Les accolades sont facultatives pour une seule clé : la page de comparaison DQL/SQL de la documentation écrit
summarize count(), by:event.type.
La même page donne cet exemple d’agrégation :
fetch events
| filter event.type == "travel.funnel.booking-payment"
| summarize sum = sum(amount), by:travelAgency
En SQL, on écrirait SELECT sum(amount) AS sum FROM events WHERE … GROUP BY travelAgency.
Étape par étape : regrouper avec summarize
Étape 1 — Une clé et un agrégat
Compter les logs par niveau de sévérité :
fetch logs
| summarize nb = count(), by:{loglevel}
Chaque ligne du résultat correspond à une valeur distincte de loglevel. Les fonctions d’agrégation documentées incluent notamment count, countIf, countDistinct, sum, avg, min, max, percentile et takeFirst.
Étape 2 — Nommer les colonnes avec des alias
Un alias se place devant l’agrégat et devant la clé. Sans alias, la colonne porte le texte de l’expression, par exemple sum(value), peu pratique pour la suite du pipeline.
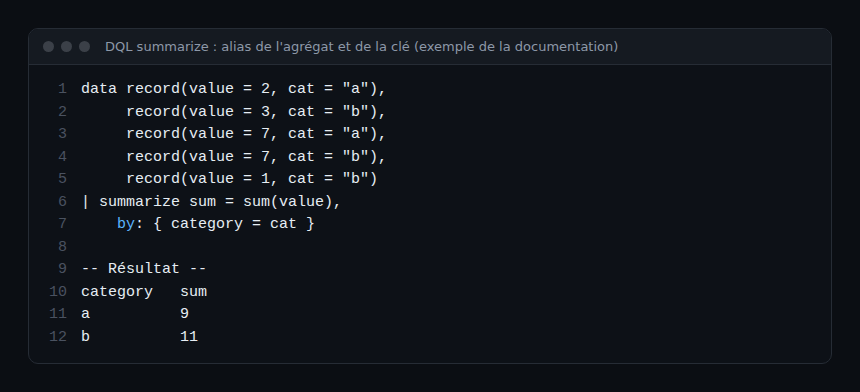
Dans cet exemple tiré de la documentation, l’agrégat devient sum et la clé cat devient category. Les alias rendent les tris et les filtres suivants lisibles : | sort sum desc plutôt que de répéter l’expression.
Étape 3 — Regrouper sur plusieurs clés
Listez les clés entre accolades, séparées par des virgules. La documentation compte ainsi les niveaux de log par hôte et par groupe de processus :
fetch logs
| summarize {
      errors = countIf(loglevel == "ERROR"),
      warnings = countIf(loglevel == "WARN")
    },
    by: {
      dt.entity.host,
      dt.entity.process_group
    }
Notez les accolades autour des agrégats : elles regroupent plusieurs agrégations nommées. countIf remplace le classique SUM(CASE WHEN … THEN 1 ELSE 0 END) de SQL et produit plusieurs compteurs en une seule passe.
Étape 4 — Comprendre le groupe null
Si le champ de regroupement n’existe pas sur tous les enregistrements, summarize ajoute un groupe null au résultat. C’est le piège le plus fréquent : un total qui semble juste, mais une ligne null qui concentre une partie des données.
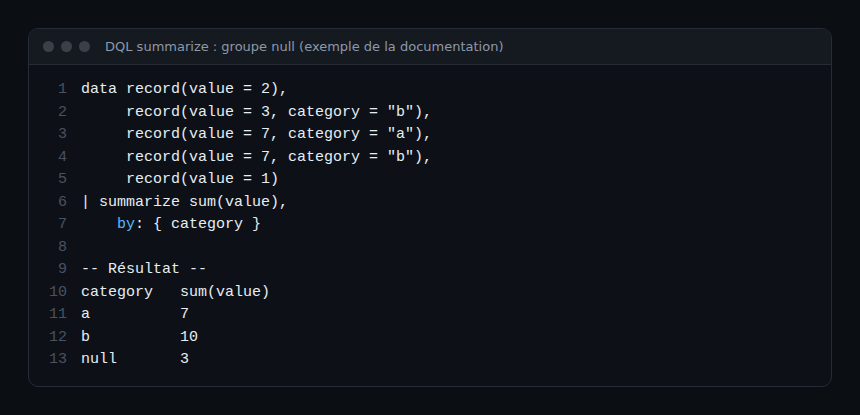
Deux réponses possibles, selon le besoin :
// exclure les enregistrements sans clé
fetch logs
| filter isNotNull(k8s.namespace.name)
| summarize nb = count(), by:{k8s.namespace.name}

// ou garder la ligne null et l'investiguer
fetch logs
| summarize nb = count(), by:{k8s.namespace.name}
| sort nb desc
En exploitation, la ligne null révèle souvent un défaut d’enrichissement : des logs qui arrivent sans métadonnées Kubernetes, par exemple. L’exclure sans regarder masque le problème.
Étape 5 — Regrouper par tranche avec bin()
La fonction bin(expression, interval) arrondit une valeur vers le bas au multiple de l’intervalle. La documentation précise qu’elle est souvent utilisée avec summarize et by. Elle accepte un nombre, une durée ou un horodatage :
fetch logs
| summarize nb = count(), by:{minute = bin(timestamp, 1m), loglevel}
| sort minute asc
Pour une valeur numérique, bin(x, 10) range 27 dans la tranche 20 ; le paramètre optionnel at: décale les tranches (bin(x, 10, at:5) range 27 dans la tranche 25). C’est l’équivalent DQL d’un histogramme GROUP BY FLOOR(x / 10) * 10.
Pour des séries temporelles destinées à un graphique, la commande makeTimeseries, avec son propre paramètre by, produit des séries homogènes avec des intervalles réguliers. summarize avec bin() reste plus simple pour un tableau.
Étape 6 — L’équivalent du HAVING
Ajoutez un filter après le summarize :
fetch logs
| filter loglevel == "ERROR"
| summarize erreurs = count(), by:{dt.entity.host}
| filter erreurs > 100
| sort erreurs desc
| limit 10
Le premier filter réduit les données lues (le WHERE), le second garde les groupes qui dépassent le seuil (le HAVING). La commande sort accepte asc ou desc pour chaque champ.
Comment vérifier que le regroupement est juste
- Contrôlez le total : lancez la même requête sans
by. La somme des groupes doit égaler le total, groupenullcompris. - Cherchez la ligne null :
| filter isNull(ma_cle)après lesummarizemontre immédiatement si elle existe. - Vérifiez le cas vide : sans
byet sans enregistrement en entrée,summarizerenvoie quand même une ligne (count()à 0, les autres agrégats ànull). Un tableau de bord doit afficher correctement ce cas, ainsi que le tableau vide d’une requête avecbyquand aucun groupe ne ressort.
Bonnes pratiques
- Filtrez avant de regrouper : moins de données lues, requête plus rapide et moins coûteuse.
- Nommez systématiquement agrégats et clés : la requête reste lisible six mois plus tard, pendant une astreinte.
- Évitez de regrouper sur un champ à forte cardinalité (identifiant de requête, contenu de log complet). La documentation limite la taille combinée des clés de regroupement à 128 kB par enregistrement et conseille de tronquer, par exemple avec
substring(content, 0, 100). - Gardez la ligne
nullvisible dans les requêtes de diagnostic ; ne la filtrez que dans les vues destinées aux utilisateurs. - Pour un SLI, regroupez par service et par statut, puis calculez le ratio dans une étape
fieldsAdd: voir le parcours métriques Dynatrace SaaS.
Questions fréquentes
Existe-t-il une commande group by en DQL ?
Non. Le regroupement passe par summarize … by:{}. Pour obtenir seulement les valeurs distinctes, comme un SELECT DISTINCT, la documentation montre summarize count(), by:event.type suivi de fields event.type ; la commande dedup est une autre option.
Pourquoi mon résultat contient-il une ligne null ?
Parce qu’au moins un enregistrement ne porte pas le champ de regroupement. summarize le range dans un groupe null au lieu de l’ignorer. Filtrez avec isNotNull() avant le regroupement si ces enregistrements ne vous intéressent pas.
Quelle différence avec l’article sur les requêtes DQL d’exemple ?
Ce guide se concentre sur le regroupement et ses pièges. Les requêtes DQL d’exemple couvrent des cas complets d’exploitation, et la fonction DQL in() sert à filtrer sur une liste avant de regrouper.
Conclusion
Le DQL group by se résume à une habitude : écrire l’agrégat, puis by:{}, dans le même summarize. Nommer les colonnes, surveiller le groupe null, découper avec bin() et filtrer après le regroupement pour le HAVING suffisent à couvrir l’essentiel des requêtes d’exploitation. Pour aller plus loin sur la topologie, voir DQL et Smartscape.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Les marques citées appartiennent à leurs propriétaires. La syntaxe DQL évolue : vérifiez-la dans la documentation officielle avant de l’utiliser en production.