ارتفاع مفاجئ في أخطاء السجلات، ويتكرر السؤال نفسه: كم عددها، وما مستواها، ومنذ متى؟ في أخطاء سجلات DQL تقوم الطريقة على خطوتين: جدول حسب المستوى أولًا بالأمر summarize، ثم منحنى بالأمر makeTimeseries. يقدّم هذا المقال الاستعلامات، ويشرح ما يعيده كل أمر، وكيف تتجنب الأخطاء الشائعة.
الهدف: معرفة خلال دقائق هل ترتفع الأخطاء، ومتى، وعلى أي مستوى من الخطورة، دون تصدير السجلات. النطاق: يستعلم DQL من Grail، لذا فكل ما يلي ينطبق على Dynatrace SaaS فقط. أما Dynatrace Managed فلا يتضمن Grail. يكمّل هذا المقال استعلامات DQL الخمسة عشر للتشغيل بالتركيز على حالة استخدام واحدة.
باختصار
- يعيد
summarizeجدولًا: صف لكل مجموعة، وهنا حسبloglevel. - يعيد
makeTimeseriesسلسلة زمنية: مصفوفة قيم لكل شريحة زمنية، جاهزة للرسم البياني. - لا يُسلسَل الأمران للحصول على النتيجة نفسها: يُختار أحدهما بحسب السؤال.
- للحصول على سلسلة بلا فجوات نجمع بين
defaultوnonempty.
المتطلبات
- بيئة Dynatrace SaaS مع Grail وسجلات مستوعَبة (OneAgent أو OpenTelemetry Collector أو واجهة API).
- صلاحية قراءة السجلات وفتح Notebook أو Dashboard.
- أساسيات
fetchوfilter؛ وإلا فراجع أساسيات DQL.
يصف الحقل loglevel مستوى خطورة حدث السجل. تصفه صفحة القاموس الدلالي في Dynatrace بأنه «the log event severity level» وتذكر ERROR وINFO وTRACE أمثلةً، ولا تقدّم قائمة مغلقة. لذا تحقق من القيم الموجودة لديك بالاستعلام الأول أدناه قبل نسخ أي استعلام.
أخطاء سجلات DQL: العدّ حسب المستوى باستخدام summarize
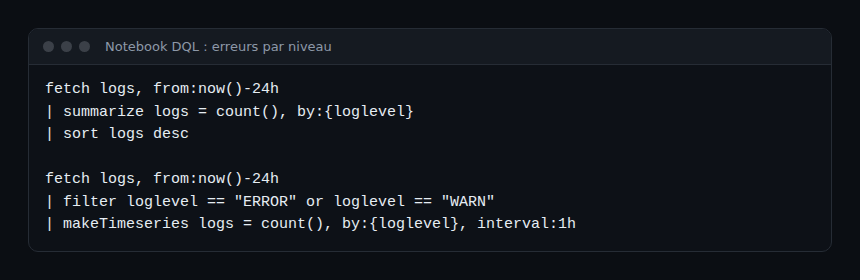
يقبل الأمر fetch المعاملين from وto بصيغة مدد نسبية. تعطي الوثائق المثال fetch logs, from: -24h, to: -2h. يقرأ استعلامنا الأول آخر 24 ساعة ويعدّ السجلات حسب المستوى.
fetch logs, from:now()-24h
| summarize logs = count(), by:{loglevel}
| sort logs desc
صيغة الوثائق هي summarize [field =] aggregation, ... [, by: {[field =] expression, ...}]. هنا يقوم count() بـ«عدّ العدد الإجمالي للسجلات» في كل مجموعة. والنتيجة جدول بصف لكل قيمة من قيم loglevel.
قراءة الجدول بمنهجية
- حدّد المستويات الموجودة: ERROR وWARN وINFO، وكذلك أي قيم فارغة أو غير متوقعة.
- قارن ERROR بالحجم الإجمالي. مضاعفة حجم الأخطاء أهم من قيمته المطلقة.
- تحقق من المجموعة
null. توضح الوثائق أن السجلات التي لا تحتوي حقلbyتُجمَّع تحتnull. السجلات بلا مستوى تُشوّه نسبة الأخطاء.
إذا لم يطابق أي سجل ولم يوجد by، يعيد summarize مع ذلك صفًا واحدًا، وقيمة count() فيه 0. فقد تعني القيمة «0» «لا سجلات» بقدر ما تعني «لا أخطاء»: راجع النافذة الزمنية.
الانتقال إلى منحنى باستخدام makeTimeseries
يخبرك الجدول بالعدد، لكنه لا يخبرك بالتوقيت. يجيب makeTimeseries عن هذا السؤال الثاني بتقسيم الزمن إلى شرائح.
fetch logs, from:now()-24h
| filter loglevel == "ERROR" or loglevel == "WARN"
| makeTimeseries logs = count(), by:{loglevel}, interval:1h
يقسّم المعامل by السلسلة: تحصل على منحنى لكل مستوى. ويحدد المعامل interval مدة كل شريحة. لمرشحات أكثر إيجازًا راجع الدالة in في DQL.
ما الذي يعيده الأمر
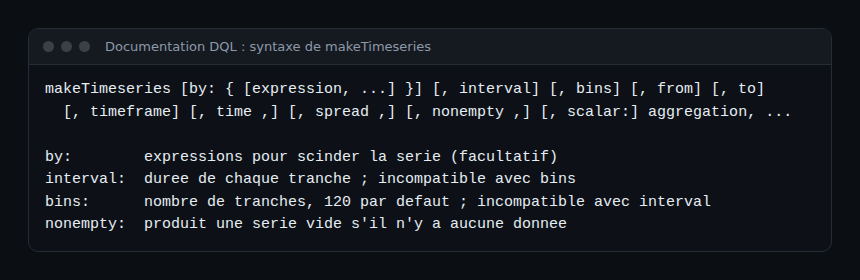
بحسب الوثائق، تحتوي النتيجة على حقل timeframe (البداية والنهاية) وحقل interval (مثل «1 min») وعمود التجميع. هذا العمود مصفوفة بقيمة لكل شريحة، مثل [1, 2, 1] في المثال الرسمي. يختلف هذا التنسيق عن جدول الصفوف: وهو ما يتيح عرض رسم بياني مباشرة.
interval أو bins
يضبط معاملان دقة السلسلة. يعطي interval مدة الشريحة. ويعطي bins عدد الشرائح، وقيمته الافتراضية 120. لا يمكن استخدامهما معًا. وتشير الوثائق أيضًا إلى أن الفاصل الفعلي يُعدَّل إلى قيمة معتادة، وأن السلسلة لا يمكن أن تتجاوز 1 500 عنصر، وأن الشرائح تُحاذى مع منتصف الليل في المنطقة الزمنية المطلوبة: وقد تكون الفترة المعادة أوسع من المطلوبة.
عمليًا، اختر الفاصل بحسب السؤال. تكفي شريحة من ساعة واحدة على مدى 24 ساعة لرصد انحراف؛ ولتحديد وقت حادثة بالدقيقة، قلّص النافذة بدل الفاصل.
ملء الفجوات: default وnonempty
افتراضيًا، تحتوي الشريحة التي لا بيانات فيها على null. يستبدل المعامل default في دالة التجميع هذه القيمة، مثلًا بالقيمة 0. أما المعامل nonempty فيعالج الحالة الأخرى: إذا لم يُعالَج أي سجل إطلاقًا، فبدونه لا يعيد الأمر شيئًا. تعرض الوثائق count(default: 0) مع interval: 30m وnonempty: true للحصول على سلسلة من الأصفار.
fetch logs, from:now()-24h
| filter loglevel == "ERROR"
| makeTimeseries errors = count(default:0), interval:30m, nonempty:true
تهم هذه التفصيلة في رسم التنبيه: منحنى يختفي عندما يسير كل شيء على ما يرام يسبب الالتباس، بينما يؤكد خط عند الصفر أن الجمع يعمل.
مقارنة عدة مستويات باستخدام countIf
عندما نريد عدة منحنيات في استعلام واحد، دون by، يقوم countIf(condition) بـ«عدّ عدد السجلات التي تطابق الشرط».
fetch logs, from:now()-24h
| makeTimeseries
    errors = countIf(loglevel == "ERROR"),
    warnings = countIf(loglevel == "WARN"),
    interval:1h
تتجنب هذه الصيغة التصفية قبل التجميع. وتعطي أيضًا مقامًا: بإضافة total = count() يمكنك مقارنة الأخطاء بالحجم الإجمالي. لم أتحقق في الوثائق من وجود عملية حسابية بين السلاسل في هذا الأمر؛ احسب النسبة في Notebook أو Dashboard.
كيف تتحقق من أن الأمر يعمل
- نفّذ
fetch logs, from:now()-1h | limit 5وتحقق من وجودloglevelفي سجلاتك. - نفّذ استعلام
summarizeوقارن مجموع الصفوف بالإجمالي المتوقع. - نفّذ استعلام
makeTimeseriesواعرضه كرسم خطي: يجب أن يطابق عدد المنحنيات المستويات المصفّاة. - قلّص النافذة إلى فترة تعرف أن حادثة وقعت فيها: يجب أن يرتفع المنحنى هناك.
أفضل الممارسات
- حدّد
fromدائمًا: الاستعلام بلا نافذة صريحة يكلّف قراءة أكثر ويُربك المقارنة. - اجعل حالة واحدة في كل استعلام: جدول للحصيلة، وسلسلة للتسلسل الزمني.
- لربط منحنى بـ SLO انطلق من مؤشرات SLI معرّفة في DQL.
- للحصول على Dashboard كامل راجع أمثلة لوحات DQL.
- إذا كانت سجلاتك بصيغة JSON فاستخرج الحقول أولًا، كما في هذا المقال عن fieldsMove وjsonExtract.
- من جهة OpenTelemetry، يقع السجل بلا مستوى في المجموعة
null: تحقق من الخطورة عند الإرسال، وراجع سجلات OpenTelemetry في Dynatrace.
الأسئلة الشائعة
هل يمكن سلسلة summarize ثم makeTimeseries؟
هذا ليس الاستخدام الصحيح. ينتج summarize جدولًا مجمّعًا، بينما ينطلق makeTimeseries من السجلات وطابعها الزمني (الحقل timestamp افتراضيًا) لبناء السلسلة. للحصول على منحنى، طبّق makeTimeseries مباشرة بعد filter.
لماذا يحتوي منحناي على قيم null؟
تُملأ الشريحة التي لا سجلات فيها بالقيمة null افتراضيًا. استخدم count(default: 0) للحصول على أصفار، وnonempty: true للإبقاء على سلسلة حتى دون أي سجل.
ما الفرق عن الأمر timeseries؟
يستعلم timeseries عن المقاييس، أما makeTimeseries فيبني سلسلة من سجلات مثل السجلات النصية. وللمقاييس راجع DQL timeseries والتنبيهات. الأوامر الأساسية مذكّر بها في filter وsummarize وtimeseries.
الخلاصة
جدول لكل مستوى للحصيلة، وسلسلة لكل مستوى للتسلسل الزمني: يكفي استعلامان قصيران لتوصيف ارتفاع الأخطاء. بالنسبة لمهندس SRE، هذا مكسب مباشر في MTTR، لأن التشخيص الأولي لم يعد يعتمد على تصدير. وللتعمق في التجميع اقرأ DQL group by وsummarize.
المصادر
- DQL، أوامر التجميع (summarize وmakeTimeseries)، وثائق Dynatrace
- DQL، أوامر مصدر البيانات (fetch)، وثائق Dynatrace
- DQL، دوال التجميع (count وcountIf)، وثائق Dynatrace
- القاموس الدلالي، نموذج السجل (loglevel)، وثائق Dynatrace
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace علامة تجارية لشركة Dynatrace LLC. أسماء المنتجات المذكورة تعود إلى مالكيها؛ الاستعلامات مقدَّمة لأغراض تعليمية ويجب تكييفها مع بياناتك. تحقق دائمًا من القيم في الوثائق الرسمية الخاصة بإصدارك.