En DQL, la función in de DQL y el operador in responden a la misma pregunta: ¿forma este valor parte de una lista? La función comprueba una lista escrita en la consulta o un array que lleva el registro; el operador compara un valor con el resultado de una subconsulta. Elegirlos bien evita las cadenas de or ilegibles y las listas de identificadores copiadas a mano durante un incidente.
Esta guía detalla la sintaxis documentada, los arrays, la negación, las subconsultas y el caso particular de classicEntitySelector, con casos de uso de operación. Todas las sintaxis citadas proceden de la documentación oficial de DQL, consultada en octubre de 2026.
El contenido vale para Dynatrace SaaS (Grail). Dynatrace Managed no tiene DQL: allí se filtra con el selector de entidades y el metric selector. Para el panorama de los comandos, consulta los comandos DQL comentados, que presentan in() en unos pocos ejemplos; esta guía va más lejos.
Función in de DQL: sintaxis y valor devuelto
La firma documentada es:
in(needle, haystack, …)needle: el elemento buscado (o los elementos, si es un array);haystack: los valores en los que buscar. La función acepta varios haystacks y arrays en todos los argumentos;- el resultado es un booleano, por lo que se puede usar directamente en
filter,filterOut,fieldsAddocountIf.
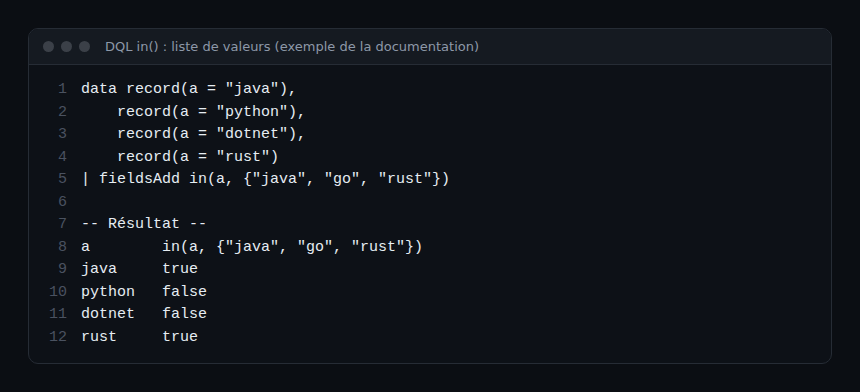
Los tipos aceptados cubren cadenas, números, duraciones, direcciones IP, marcas de tiempo, booleanos y registros: se puede comprobar una lista de direcciones IP igual que una lista de nombres de servicio.
Paso a paso: filtrar por una lista
Paso 1: sustituir una cadena de or
// avant
fetch logs
| filter loglevel == "ERROR" or loglevel == "WARN"

// après
fetch logs
| filter in(loglevel, {"ERROR", "WARN"})
La lista entre llaves es la forma que usa la documentación. Una sucesión de valores también funciona: in(technologies, "Python", "Hibernate") figura en los ejemplos oficiales.
Paso 2: excluir una lista
La negación se escribe con not delante de la función, o con el comando filterOut:
fetch logs
| filterOut in(k8s.namespace.name, {"kube-system", "monitoring"})
| summarize nb = count(), by:{k8s.namespace.name}
Útil para quitar el ruido de los namespaces técnicos antes de buscar el origen de un aumento de volumen.
Paso 3: comprobar un campo array
Cuando el needle es un array, in() devuelve true si al menos uno de sus elementos figura en el haystack. El ejemplo oficial:
data record(technologies = array("Java", "Spring", "Jetty")),
     record(technologies = array("Python", "Flask")),
     record(technologies = array("Java", "Hibernate"))
| fieldsAdd in(technologies, "Python", "Hibernate"),
            in(technologies, array("Spring", "Flask"))
El primer registro da false y después true: ninguno de sus elementos es Python ni Hibernate, pero Spring figura en el segundo haystack.
Para comprobar que un array está enteramente contenido en otro, la documentación de los operadores propone una doble negación con iAny:
| fieldsAdd not iAny(not in(needle[], haystack))not in(needle[], haystack) vale true para cada elemento ausente; iAny detecta si existe alguno; el not exterior devuelve por tanto true solo si no falta ningún elemento. La documentación precisa que un array cuyos elementos son todos null da null y, por tanto, nunca pasa un filtro.
Subconsultas: el operador in
Cuando la lista no se conoce de antemano, usa el operador in con una subconsulta entre corchetes. Sintaxis documentada:
expression in [execution block]Restricción: la subconsulta debe devolver un solo campo, que aporta la lista de valores.
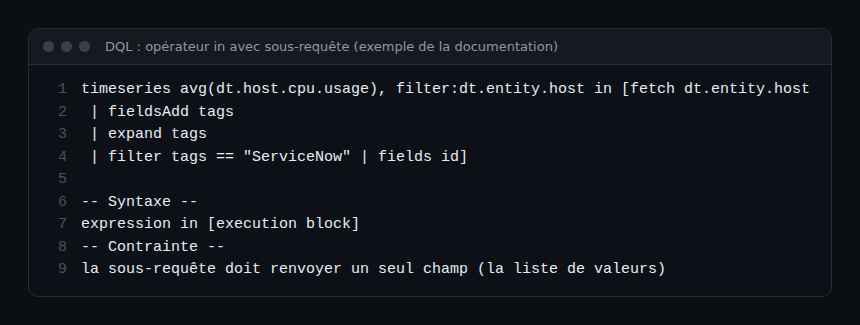
El ejemplo oficial filtra la métrica de CPU de los hosts que llevan un tag determinado. El mismo principio se aplica a los logs:
fetch logs
| filter loglevel == "ERROR"
| filter dt.entity.host in [fetch dt.entity.host
    | fieldsAdd tags
    | expand tags
    | filter tags == "ServiceNow"
    | fields id]
| summarize erreurs = count(), by:{dt.entity.host}
La subconsulta devuelve el campo id de las entidades host; el fields id final garantiza que haya un solo campo. El resultado se agrupa después con summarize: consulta DQL group by.
El caso classicEntitySelector
La función classicEntitySelector() devuelve los identificadores de entidades que corresponden a un selector de entidades clásico. La documentación precisa que solo se admite en la forma in(field, classicEntitySelector("..")) y que exige el permiso storage:entities:read. Permite reutilizar un selector existente, con sus relaciones:
fetch logs
| filter in(dt.entity.cloud_application_instance,
    classicEntitySelector("type(CLOUD_APPLICATION_INSTANCE),toRelationShip.IS_NAMESPACE_OF_CAI(type(CLOUD_APPLICATION_NAMESPACE), entityId(CLOUD_APPLICATION_NAMESPACE-1B6CFC8C542A2273))"))
Smartscape sobre Grail no admite classicEntitySelector: la documentación sustituye allí la selección por relaciones por el comando traverse, que recorre la topología directamente en DQL: consulta DQL Smartscape.
Casos de uso en operaciones
- Perímetro de un incidente: limitar los logs a los servicios afectados, enumerados una vez en la consulta.
- Lista de exclusión: quitar las sondas de monitorización o las direcciones IP internas con
filterOut in(...). - Filtro dinámico: una subconsulta que selecciona los hosts por tag, en lugar de una lista de identificadores que envejece mal.
- Contador condicional:
countIf(in(loglevel, {"ERROR", "WARN"}))dentro de unsummarizepara un indicador de errores.
Cada lista escrita a fuego es una fuente de toil: hay que actualizarla con cada servicio nuevo. Una subconsulta basada en un tag sigue al entorno sin intervención, lo que reduce el riesgo de un filtro erróneo justo cuando el MTTR importa.
Cómo comprobar que el filtro es correcto
- Muestra el booleano antes de filtrar:
| fieldsAdd match = in(champ, {...})y después| summarize count(), by:{match}. Verás cuántos registros pasan. - Ejecuta la subconsulta sola: debe devolver una sola columna y los valores esperados.
- Lista los valores reales del campo con
| summarize count(), by:{champ}: un valor mal escrito en la lista no coincide con nada y no provoca ningún error.
Buenas prácticas
- Prefiere
in()a más de dosorsobre el mismo campo: la consulta se relee y se modifica en una línea. - Termina toda subconsulta con
fieldssobre un solo campo. - Sustituye las listas de identificadores por una subconsulta sobre un tag o una propiedad estable.
- Reserva
classicEntitySelectorpara la migración de selectores existentes; para la topología, usa Smartscape. - Documenta en un comentario
//por qué se excluye un valor.
Preguntas frecuentes
¿Qué diferencia hay entre la función in() y el operador in?
La función in(needle, haystack) comprueba una lista conocida o un array. El operador expression in [subconsulta] comprueba el resultado de otra consulta DQL, que debe devolver un solo campo.
¿Cómo se escribe «not in» en DQL?
Con not in(champ, {...}) dentro de un filter, o con filterOut in(champ, {...}). Ambas formas excluyen los valores de la lista.
¿Funciona in() en Dynatrace Managed?
No: DQL se apoya en Grail, disponible en Dynatrace SaaS. En Managed, filtra con el selector de entidades y el metric selector; consulta la ruta de aprendizaje de Dynatrace Managed.
Conclusión
En DQL, la función in para una lista o un array y el operador in para una subconsulta: estas dos herramientas sustituyen las condiciones interminables y las listas fijas. Combinadas con summarize, dan consultas cortas, correctas y que siguen la evolución del entorno. Para más consultas listas para usar, consulta nuestras consultas DQL de operación.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.