ES|QL métriques Elasticsearch : les requêtes sur les métriques passent désormais par une commande dédiée, TS. Elle lit des index de séries temporelles et permet d’y calculer des taux et des moyennes sans écrire d’agrégation Query DSL. Elastic l’a présentée en octobre 2025 dans un billet de ses Observability Labs (Elastic Observability 9.2, « tech preview »), avec une exploration des métriques dans Discover.
Cet article fait le point pour une équipe SRE ou plateforme : ce que fait TS, où en est son statut aujourd’hui, comment écrire une première requête, et ce que la commande PROMQL d’ES|QL change pour qui vient de Prometheus. Les faits viennent des pages officielles d’Elastic consultées le 30 octobre 2026. Ils concernent Elasticsearch, pas Dynatrace ; le lien avec Dynatrace est traité plus bas.
En bref
TSest une commande source, proche deFROM, qui ne lit que les index en modetime_series.- Selon la documentation, elle est en disponibilité générale sur Elastic Cloud Serverless et, pour la Elastic Stack, en disponibilité générale depuis la 9.4 (aperçu de la 9.2 à la 9.3). Le billet d’octobre 2025 est donc en retard sur le statut actuel.
- Une requête a deux niveaux : une fonction interne par série (
RATE,AVG_OVER_TIME), puis une fonction externe (SUM,AVG) qui regroupe. - Pour les compteurs, la doc recommande
TSplutôt queFROM | STATS.
ES|QL métriques Elasticsearch : ce que fait la commande TS
Une métrique est une série de points horodatés. Un compteur de requêtes HTTP ne fait que croître, sauf remise à zéro au redémarrage d’un processus. Additionner ses valeurs brutes n’a donc guère de sens. La page de référence de la commande explique que RATE() ou INCREASE() calculent d’abord des variations par série, en gérant les remises à zéro, avant toute agrégation.
Le principe est celui des deux niveaux. La fonction interne s’exécute pour chaque série temporelle, souvent par tranche de temps. La fonction externe combine ensuite les résultats par groupe. Si vous omettez la fonction interne, LAST_OVER_TIME() est appliquée implicitement aux champs numériques. Le billet d’Elastic donne cette équivalence.
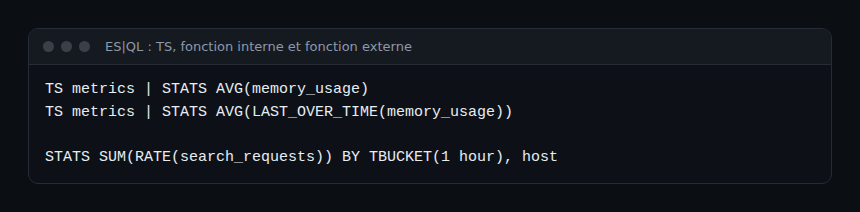
La deuxième utilité tient aux métriques publiées à intervalles irréguliers. En réduisant d’abord chaque série à une valeur par tranche, un hôte très bavard ne domine plus la moyenne, selon la documentation Elastic.
Statut et version : où en est la fonctionnalité
Le titre du billet parle de « tech preview ». Il date d’octobre 2025 et visait la 9.2. La page de référence actuelle indique autre chose : disponibilité générale depuis la 9.4 pour la Elastic Stack, aperçu de la 9.2 à la 9.3, et disponibilité générale sur Serverless. Vérifiez donc votre version avant de bâtir un runbook sur cette commande.
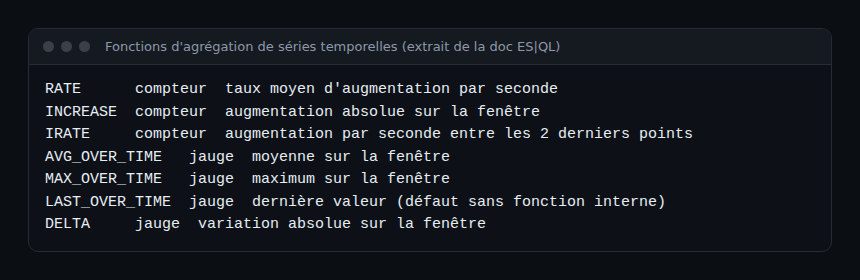
Le détail varie selon les fonctions. D’après la page des fonctions d’agrégation de séries temporelles, RATE, INCREASE, AVG_OVER_TIME ou LAST_OVER_TIME sont en disponibilité générale depuis la 9.4. PERCENTILE_OVER_TIME, STDDEV_OVER_TIME et DERIV apparaissent en aperçu en 9.3, et CHANGES est indiquée comme planifiée. Relisez ce tableau à chaque montée de version.
Écrire une première requête avec TS
Prérequis : un index ou un data stream en mode time_series (TSDS), dans une version d’Elasticsearch qui propose TS. Les noms de champs ci-dessous sont des exemples à remplacer par les vôtres.
- Ciblez les index de métriques. Selon la doc, les jokers ne correspondent qu’aux index de séries temporelles et ignorent silencieusement les autres.
- Bornez le temps. La documentation conseille un filtre sur
@timestamp. - Choisissez la fonction interne selon le type de métrique :
RATEpour un compteur,AVG_OVER_TIMEpour une jauge. - Choisissez la fonction externe et le regroupement, par exemple par tranche de temps avec
TBUCKETet par service.
TS metrics-*
| WHERE @timestamp >= NOW() - 1 hour
| STATS requetes_par_seconde = SUM(RATE(http_requests_total))
        BY TBUCKET(5 minutes), service.name
| SORT requetes_par_seconde DESC
Cette requête est un exemple écrit à partir de la syntaxe de la documentation, pas une capture de production. Un point d’attention : la doc précise que SORT et FORK ne peuvent pas se placer entre TS et le premier STATS. Ici, SORT vient après, ce qui est permis.
Les pièges documentés
- Imbriquer une fonction de série temporelle dans une autre provoque une erreur.
- Les fonctions vérifient le
metric_typedu champ :RATEexige un compteur. - Après le premier
STATS,COUNT(*)compte des lignes par série et non des documents. UtilisezCOUNT(champ)ouCOUNT_OVER_TIME. - Par défaut, le résultat est tronqué à 10 000 lignes.
- Mélanger des métriques de cardinalités de dimensions différentes dans une même expression propage des valeurs nulles.
Discover et explorateur de métriques
Le billet décrit aussi une vue en grille dans Discover. Elle part de TS metrics-*, choisit une agrégation selon le type (rate pour les compteurs, avg pour les jauges), permet de chercher une métrique par nom et de grouper par dimension. Chaque métrique affiche sa requête ES|QL, générée automatiquement et ajoutable à un tableau de bord. Pour un SRE, l’intérêt est pratique : on part de la requête produite par l’interface et on l’affine à la main.
Le même billet mentionne un point d’entrée OTLP natif pour les métriques, orienté surtout vers les déploiements auto-gérés, avec des gains de débit annoncés par Elastic (jusqu’à 60 % via _otlp, 25 % via _bulk). Ce sont des chiffres de l’éditeur, non vérifiés par span.observer.
ES|QL ou PromQL : la commande PROMQL
Si votre équipe vient de Prometheus, ES|QL propose une seconde voie. D’après la page de la commande, PROMQL fonctionne comme TS mais accepte une expression PromQL. Elle est en disponibilité générale depuis la 9.5 et en aperçu en 9.4.
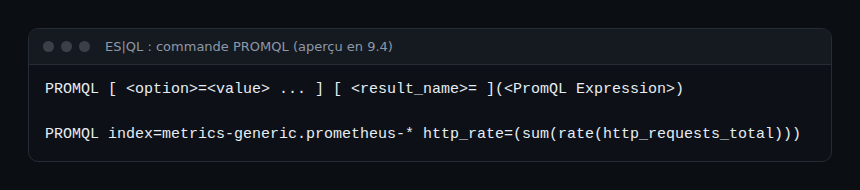
La page précise que PROMQL « supporte la plupart » de PromQL, mais pas tout. Les opérateurs and et unless, les modificateurs de groupe (on, ignoring, group_left), l’opérateur @ et les sous-requêtes renvoient une erreur client. Testez donc vos règles existantes une par une au lieu de présumer une compatibilité complète. Pour situer PromQL face à OpenTelemetry, voyez OpenTelemetry et Prometheus : complémentaires.
Ce que cela change pour une équipe SRE, avec OpenTelemetry et Dynatrace
Pour des métriques stockées dans Elasticsearch, TS rapproche le calcul de taux de ce que font les outils orientés métriques. Les SLI à base de compteurs (taux d’erreurs, requêtes par seconde) deviennent des requêtes lisibles, avec un budget d’erreur calculable. Le coût de l’opération reste à mesurer : dimensionnez vos index de séries temporelles et vos shards avec vos propres tests.
Côté OpenTelemetry, le billet cite l’ingestion OTLP de métriques ; rappelons que traces, métriques et logs sont des signaux distincts, et que TS ne traite que les métriques. Pour vos métriques OpenTelemetry côté Dynatrace, l’équivalent conceptuel se trouve dans la commande timeseries de DQL, présentée dans notre guide des commandes DQL. Ce rapprochement est une analogie, pas une intégration documentée. Dynatrace SaaS exploite DQL sur Grail ; pour Managed, vérifiez les fonctions disponibles. Pour comparer plus largement les plateformes, lisez notre comparatif Dynatrace et Datadog.
Comment vérifier que ça fonctionne
- Lancez
TS metrics-* | LIMIT 5dans Discover en mode ES|QL : vous devez voir des lignes triées par@timestampdécroissant. Aucune ligne signale souvent des index qui ne sont pas en modetime_series. - Exécutez la requête avec
RATEsur un compteur. Une erreur surmetric_typeindique que le champ n’est pas déclaré comme compteur dans le mapping. - Comparez le résultat avec un graphique existant sur la même période avant de migrer un tableau de bord.
Bonnes pratiques
- Notez la version d’Elastic dans le runbook : le statut des fonctions change entre 9.2, 9.3, 9.4 et 9.5.
- Utilisez
RATEouINCREASEpour les compteurs, jamais une somme brute. - Filtrez toujours
@timestampavant d’agréger. - Gardez les requêtes générées par Discover sous contrôle de version si elles alimentent des alertes.
- Évitez de chercher un coupable : un résultat surprenant vient le plus souvent du mapping, pas de l’équipe.
Questions fréquentes
La commande TS est-elle encore en tech preview ?
Le billet d’octobre 2025 la présentait ainsi. La page de référence consultée le 30 octobre 2026 indique une disponibilité générale depuis la 9.4 pour la Elastic Stack et sur Serverless.
Quelle différence entre TS et FROM pour les métriques ?
TS ne lit que les index de séries temporelles et active les fonctions comme RATE ou AVG_OVER_TIME dans STATS. Pour les compteurs, Elastic le recommande à la place de FROM | STATS.
Puis-je réutiliser mes requêtes PromQL ?
En partie : la commande PROMQL accepte du PromQL, mais pas tous les opérateurs. Testez chaque règle avant de migrer.
Conclusion
La commande TS donne à ES|QL un vocabulaire de métriques : taux, deltas, deux niveaux d’agrégation. Vérifiez votre version, partez d’une requête simple et validez sur un graphique connu. Pour aller plus loin côté Prometheus, voyez Prometheus et Dynatrace sur Kubernetes.
Cet article provient d’un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Elasticsearch et Elastic sont des marques d’Elastic N.V. Les chiffres et statuts cités viennent de la documentation et du blog d’Elastic, pas de mesures de span.observer.