Le coût Elastic Observability Serverless dépend de deux volumes seulement : ce que vous envoyez au projet chaque mois, et ce que vous y conservez. Pour une équipe SRE ou plateforme, le travail consiste donc à estimer ces deux nombres avant de brancher les sources, puis à les surveiller. Cet article donne la méthode, les chiffres lus dans la documentation d’Elastic et un calcul d’exemple que vous pouvez refaire avec vos propres volumes.
Ici, aucun prix ne vient d’un site tiers. Les tarifs cités sont lus sur la page officielle d’Elastic le 30 octobre 2026 et peuvent changer : relisez-les avant tout budget.
En bref
- Deux dimensions de volume : l’ingestion (Go envoyés dans le mois) et la rétention (Go stockés).
- Le volume facturé est celui des données enrichies et normalisées en fin de pipeline d’ingestion, avant compression Elasticsearch.
- Le choix de l’agent de collecte, y compris OpenTelemetry, ne change pas le coût selon la documentation.
- La rétention se règle par flux de données (
data_retention) : c’est le levier le plus simple.
Comment le coût Elastic Observability Serverless est calculé
La page Observability billing dimensions décrit deux dimensions de données. L’ingestion est « mesurée par le nombre de Go de données que vous envoyez à votre projet Observability au cours d’un mois ». La rétention est « mesurée par la quantité totale de données ingérées stockées » dans le projet. Les journaux et les traces suivent le tarif standard ; ils ne forment pas de ligne de facturation à part.
Il existe une exception pour les métriques. Selon la même page, les métriques stockées en mode d’index de séries temporelles sont facturées à 25 % du tarif standard de rétention par Go, et le même facteur s’applique à leur ingestion. Les tarifs de métriques publiés ont évolué : la page de prix mentionne une nouvelle tarification effective au 1er juillet 2026.
Ce que mesure exactement le volume d’ingestion
D’après cette documentation, le volume est calculé sur la taille des données « entièrement enrichies et normalisées » à la fin du pipeline d’ingestion, avant la compression d’Elasticsearch. Conséquence pratique : le volume facturé peut dépasser la taille de l’index sur disque, ainsi que les volumes relevés dans les journaux d’un proxy du fournisseur cloud. Ne dimensionnez donc pas à partir de la taille des index d’un ancien cluster ni du trafic réseau.
Un point rassurant pour les équipes qui standardisent sur OpenTelemetry : la page indique que l’architecture d’ingestion (Elastic Agent, Logstash, OpenTelemetry ou autres collecteurs) n’influe pas sur le coût. Nous avons traité ces chemins dans notre article sur Elastic Agent et le collecteur OpenTelemetry.
Les tarifs publiés, avec date et réserves
La page Serverless Observability pricing, consultée le 30 octobre 2026, affiche deux paliers de fonctionnalités. Les montants sont en dollars (« $ »), la page ne nomme pas la devise.
| Palier | Ingestion (journaux, traces, autres) | Rétention (journaux, traces, autres) |
|---|---|---|
| Logs Essentials | à partir de 0,07 $ par Go | à partir de 0,017 $ par Go et par mois |
| Complete | à partir de 0,09 $ par Go | 0,019 $ par Go et par mois |
Pour les métriques, la page affiche 0,023 $ par Go à l’ingestion et 0,005 $ par Go et par mois de rétention dans le palier Complete. Attention au libellé « à partir de » : il s’agit de planchers affichés, pas d’un prix garanti pour votre volume. Tout calcul fait avec ces chiffres est donc une estimation basse. Pour un budget ferme, passez par le calculateur ou l’équipe commerciale d’Elastic.
Dimensionner ingestion et rétention pas à pas
Voici une méthode en quatre étapes. Elle vaut pour un projet Observability sur Elastic Cloud Serverless ; elle ne concerne ni Dynatrace Managed ni Dynatrace SaaS.
- Mesurez le volume brut par source. Comptez les Go par jour de chaque source (journaux d’application, traces, métriques) avant compression, en tenant compte de l’enrichissement que vos pipelines ajoutent.
- Multipliez par 30 pour obtenir l’ingestion mensuelle.
- Décidez la rétention par type de données. Les traces de débogage n’ont pas besoin de la même durée que les journaux d’audit.
- Calculez le stock stocké : volume quotidien multiplié par le nombre de jours conservés, une fois le régime stable atteint.
Exemple avec 50 Go par jour de journaux dans le palier Complete, aux tarifs plancher ci-dessus. L’ingestion représente 1 500 Go par mois, soit 135 $. Avec 30 jours de rétention, le stock atteint 1 500 Go, soit 28,5 $ par mois ; avec 90 jours, 4 500 Go, soit 85,5 $ par mois.
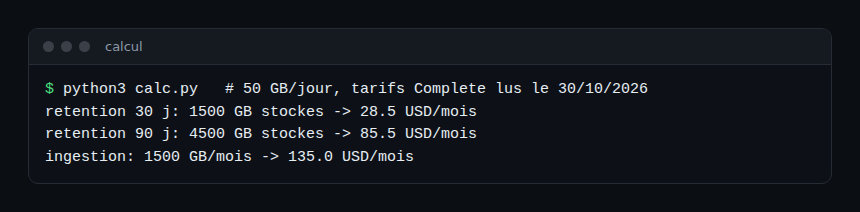
Le calcul montre un ordre de grandeur utile : passer de 30 à 90 jours triple le stock stocké, mais ne touche pas à l’ingestion. Ici, l’ingestion pèse davantage que la rétention. Réduire le volume envoyé reste donc le premier levier, la rétention le second. Ce résultat vient de notre arithmétique sur des tarifs plancher, pas d’une mesure.
Nous n’avons pas vérifié si la rétention compte le même volume « enrichi » que l’ingestion ou la taille compressée : la documentation lue ne le précise pas. Prévoyez une marge et comparez la première facture à votre estimation.
Régler la rétention dans un modèle d’index
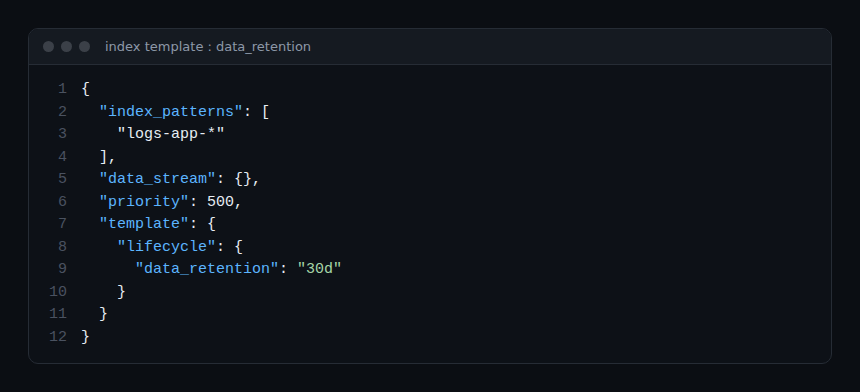
Selon la documentation sur la rétention des flux de données, le paramètre data_retention se fixe par flux de données. Pour les nouveaux flux, on le place dans un modèle d’index ; le nom logs-app-* ci-dessous est un exemple.
{
  "index_patterns": ["logs-app-*"],
  "data_stream": {},
  "priority": 500,
  "template": {
    "lifecycle": {
      "data_retention": "30d"
    }
  }
}
Modifier un flux existant
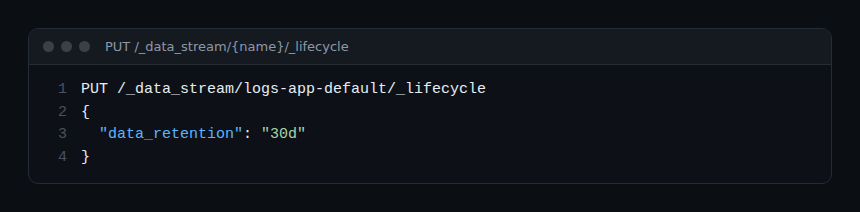
Pour un flux déjà créé, la référence de l’API Elasticsearch Serverless donne la requête PUT /_data_stream/{name}/_lifecycle. Le paramètre data_retention fixe la durée minimale de conservation des documents ; une valeur vide les garde indéfiniment.
PUT /_data_stream/logs-app-default/_lifecycle
{
  "data_retention": "30d"
}
Dans Kibana, la page Streams propose aussi un onglet Retention pour consulter et ajuster la rétention d’un flux. Sans réglage, la rétention effective est infinie : c’est la valeur par défaut documentée, et donc un risque de coût qui grossit en silence. Les réglages à l’échelle du cluster data_streams.lifecycle.retention.default et data_streams.lifecycle.retention.max existent dans la page de la documentation ; nous n’avons pas vérifié leur disponibilité sur un projet Serverless, qui n’expose pas forcément les réglages de cluster. Elle indique par ailleurs que les instantanés consultables (frozen_after) ne sont pas disponibles en Serverless : le palier gelé décrit dans notre article sur le frozen tier ne s’applique pas ici.
Comment vérifier que ça fonctionne
- Interrogez le flux avec l’API Get data stream lifecycle : la réponse doit montrer
"lifecycle": {"enabled": true}et votredata_retention. - Comparez, une fois par semaine, le volume envoyé à votre estimation du jour. Un écart durable signale une source trop verbeuse.
- Après le premier mois complet, confrontez la facture à votre calcul et ajustez le facteur de marge.
Bonnes pratiques de maîtrise du coût
- Filtrez à la source. Supprimez les journaux de niveau debug en production dans le collecteur, avant l’ingestion. Un échantillonnage des traces, comme le tail sampling, réduit aussi le volume envoyé.
- Définissez une rétention par flux plutôt que de laisser la valeur infinie par défaut.
- Surveillez les enrichissements. Chaque champ ajouté par un pipeline augmente la taille facturée.
- Traitez le coût comme un SLI interne. Un budget d’ingestion par service, relié à vos SLO, évite les surprises.
Si vous comparez avec d’autres plateformes, gardez la même méthode : volume, rétention, unité de facturation. Notre comparatif Dynatrace et Datadog montre qu’elles ne facturent pas les mêmes unités. Pour les notions de fond, voir aussi observabilité et monitoring, et notre guide sur la rétention et le stockage des données côté Dynatrace.
Questions fréquentes
Le coût Elastic Observability Serverless dépend-il de l’agent utilisé ?
Non, d’après la page de facturation d’Elastic : l’architecture d’ingestion (Elastic Agent, Logstash, OpenTelemetry ou autres collecteurs) n’affecte pas le coût. Seul le volume mesuré en fin de pipeline compte.
Pourquoi ma facture dépasse-t-elle la taille de mes index ?
Parce que le volume facturé est celui des données enrichies et normalisées avant compression Elasticsearch. Il peut donc dépasser la taille de l’index et les volumes vus par un proxy cloud.
Quelle est la rétention par défaut ?
Sans réglage, la documentation indique que la rétention effective est infinie et que les données sont conservées indéfiniment. Fixez data_retention sur chaque flux pour borner le stock.
Conclusion
Pour estimer le coût Elastic Observability Serverless, mesurez le volume brut enrichi, multipliez par la durée de rétention voulue, puis appliquez les tarifs lus sur la page officielle, en les datant. Réduisez d’abord l’ingestion, puis bornez la rétention flux par flux.
Sources
- Observability billing dimensions, documentation Elastic
- Serverless Observability pricing, Elastic (consulté le 30 octobre 2026)
- Data stream retention, documentation Elastic
- Put data stream lifecycle, API Elasticsearch Serverless
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Elastic N.V. Les noms de produits cités appartiennent à leurs propriétaires respectifs ; les tarifs sont ceux affichés par l’éditeur à la date indiquée, et les exemples de noms de flux sont fictifs.