Métricas ES|QL Elasticsearch: las consultas sobre métricas pasan ahora por un comando dedicado, TS. Lee índices de series temporales y permite calcular tasas y medias sin escribir agregaciones de Query DSL. Elastic lo presentó en octubre de 2025 en una entrada de sus Observability Labs (Elastic Observability 9.2, «tech preview»), con una exploración de métricas en Discover.
Este artículo hace balance para un equipo SRE o de plataforma: qué hace TS, en qué estado se encuentra hoy, cómo escribir una primera consulta y qué cambia el comando PROMQL de ES|QL para quien viene de Prometheus. Los hechos proceden de las páginas oficiales de Elastic consultadas el 30 de octubre de 2026. Se refieren a Elasticsearch, no a Dynatrace; la relación con Dynatrace se trata más abajo.
En breve
TSes un comando de origen, cercano aFROM, que solo lee índices en modotime_series.- Según la documentación, está en disponibilidad general en Elastic Cloud Serverless y, para la Elastic Stack, en disponibilidad general desde la 9.4 (vista previa de la 9.2 a la 9.3). La entrada de octubre de 2025 va, por tanto, por detrás del estado actual.
- Una consulta tiene dos niveles: una función interna por serie (
RATE,AVG_OVER_TIME) y después una función externa (SUM,AVG) que agrupa. - Para los contadores, la documentación recomienda
TSen lugar deFROM | STATS.
Métricas ES|QL Elasticsearch: qué hace el comando TS
Una métrica es una serie de puntos con marca de tiempo. Un contador de peticiones HTTP solo crece, salvo que se reinicie a cero cuando se reinicia un proceso. Sumar sus valores brutos apenas tiene sentido. La página de referencia del comando explica que RATE() o INCREASE() calculan primero variaciones por serie, gestionando los reinicios a cero, antes de cualquier agregación.
El principio es el de los dos niveles. La función interna se ejecuta para cada serie temporal, a menudo por intervalo de tiempo. La función externa combina después los resultados por grupo. Si omite la función interna, se aplica implícitamente LAST_OVER_TIME() a los campos numéricos. La entrada de Elastic da esta equivalencia.
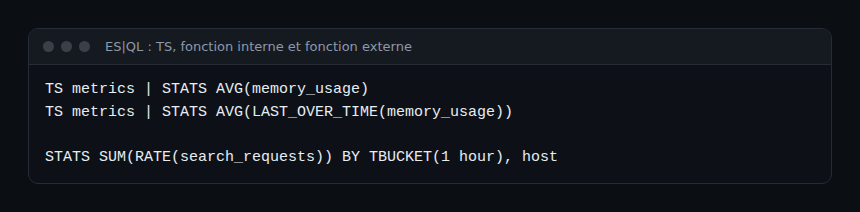
La segunda utilidad tiene que ver con las métricas publicadas a intervalos irregulares. Al reducir primero cada serie a un valor por intervalo, un host muy ruidoso deja de dominar la media, según la documentación de Elastic.
Estado y versión: en qué punto está la funcionalidad
El título de la entrada habla de «tech preview». Es de octubre de 2025 y apuntaba a la 9.2. La página de referencia actual indica otra cosa: disponibilidad general desde la 9.4 para la Elastic Stack, vista previa de la 9.2 a la 9.3 y disponibilidad general en Serverless. Compruebe, por tanto, su versión antes de construir un runbook sobre este comando.
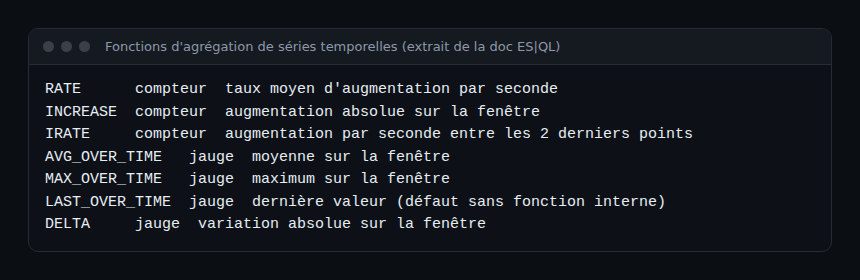
El detalle varía según las funciones. Según la página de las funciones de agregación de series temporales, RATE, INCREASE, AVG_OVER_TIME o LAST_OVER_TIME están en disponibilidad general desde la 9.4. PERCENTILE_OVER_TIME, STDDEV_OVER_TIME y DERIV aparecen en vista previa en la 9.3, y CHANGES figura como planificada. Relea esa tabla en cada actualización de versión.
Escribir una primera consulta con TS
Requisitos: un índice o data stream en modo time_series (TSDS), en una versión de Elasticsearch que ofrezca TS. Los nombres de campo siguientes son ejemplos que debe sustituir por los suyos.
- Apunte a los índices de métricas. Según la documentación, los comodines solo coinciden con índices de series temporales e ignoran en silencio los demás.
- Acote el tiempo. La documentación aconseja un filtro sobre
@timestamp. - Elija la función interna según el tipo de métrica:
RATEpara un contador,AVG_OVER_TIMEpara un gauge. - Elija la función externa y la agrupación, por ejemplo por intervalo de tiempo con
TBUCKETy por servicio.
TS metrics-*
| WHERE @timestamp >= NOW() - 1 hour
| STATS requetes_par_seconde = SUM(RATE(http_requests_total))
        BY TBUCKET(5 minutes), service.name
| SORT requetes_par_seconde DESC
Esta consulta es un ejemplo escrito a partir de la sintaxis de la documentación, no una captura de producción. Un punto de atención: la documentación precisa que SORT y FORK no pueden colocarse entre TS y el primer STATS. Aquí, SORT va después, lo cual está permitido.
Las trampas documentadas
- Anidar una función de series temporales dentro de otra provoca un error.
- Las funciones comprueban el
metric_typedel campo:RATEexige un contador. - Tras el primer
STATS,COUNT(*)cuenta filas por serie y no documentos. UtiliceCOUNT(campo)oCOUNT_OVER_TIME. - Por defecto, el resultado se trunca a 10 000 filas.
- Mezclar en una misma expresión métricas con cardinalidades de dimensiones distintas propaga valores nulos.
Discover y explorador de métricas
La entrada describe también una vista en cuadrícula en Discover. Parte de TS metrics-*, elige una agregación según el tipo (rate para los contadores, avg para los gauges), permite buscar una métrica por nombre y agrupar por dimensión. Cada métrica muestra su consulta ES|QL, generada automáticamente y que puede añadirse a un dashboard. Para un SRE, el interés es práctico: se parte de la consulta producida por la interfaz y se afina a mano.
La misma entrada menciona un punto de entrada OTLP nativo para métricas, orientado sobre todo a despliegues autoalojados, con mejoras de rendimiento anunciadas por Elastic (hasta un 60 % mediante _otlp y un 25 % mediante _bulk). Son cifras del proveedor, no verificadas por span.observer.
ES|QL o PromQL: el comando PROMQL
Si su equipo viene de Prometheus, ES|QL ofrece una segunda vía. Según la página del comando, PROMQL funciona como TS, pero acepta una expresión PromQL. Está en disponibilidad general desde la 9.5 y en vista previa en la 9.4.
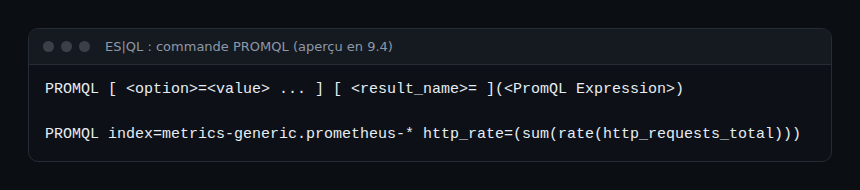
La página precisa que PROMQL «admite la mayor parte» de PromQL, pero no todo. Los operadores and y unless, los modificadores de grupo (on, ignoring, group_left), el operador @ y las subconsultas devuelven un error de cliente. Pruebe, por tanto, sus reglas existentes una a una en lugar de presumir una compatibilidad completa. Para situar PromQL frente a OpenTelemetry, vea OpenTelemetry y Prometheus: complementarios.
Qué cambia para un equipo SRE, con OpenTelemetry y Dynatrace
Para métricas almacenadas en Elasticsearch, TS acerca el cálculo de tasas a lo que hacen las herramientas orientadas a métricas. Los SLI basados en contadores (tasa de errores, peticiones por segundo) pasan a ser consultas legibles, con un presupuesto de error calculable. El coste de la operación sigue por medir: dimensione sus índices de series temporales y sus shards con sus propias pruebas.
En cuanto a OpenTelemetry, la entrada cita la ingesta OTLP de métricas; recordemos que trazas, métricas y logs son señales distintas, y que TS solo trata métricas. Para sus métricas de OpenTelemetry en Dynatrace, el equivalente conceptual está en el comando timeseries de DQL, presentado en nuestra guía de comandos DQL. Esta aproximación es una analogía, no una integración documentada. Dynatrace SaaS explota DQL sobre Grail; para Managed, compruebe las funciones disponibles. Para comparar las plataformas de forma más amplia, lea nuestra comparativa de Dynatrace y Datadog.
Cómo comprobar que funciona
- Ejecute
TS metrics-* | LIMIT 5en Discover en modo ES|QL: debería ver filas ordenadas por@timestampdescendente. Ninguna fila suele indicar índices que no están en modotime_series. - Ejecute la consulta con
RATEsobre un contador. Un error sobremetric_typeindica que el campo no está declarado como contador en el mapping. - Compare el resultado con un gráfico existente sobre el mismo periodo antes de migrar un dashboard.
Buenas prácticas
- Anote la versión de Elastic en el runbook: el estado de las funciones cambia entre la 9.2, 9.3, 9.4 y 9.5.
- Utilice
RATEoINCREASEpara los contadores, nunca una suma bruta. - Filtre siempre
@timestampantes de agregar. - Mantenga bajo control de versiones las consultas generadas por Discover si alimentan alertas.
- Evite buscar culpables: un resultado sorprendente suele venir del mapping, no del equipo.
Preguntas frecuentes
¿Sigue el comando TS en tech preview?
La entrada de octubre de 2025 lo presentaba así. La página de referencia consultada el 30 de octubre de 2026 indica disponibilidad general desde la 9.4 para la Elastic Stack y en Serverless.
¿Qué diferencia hay entre TS y FROM para las métricas?
TS solo lee índices de series temporales y activa funciones como RATE o AVG_OVER_TIME dentro de STATS. Para los contadores, Elastic lo recomienda en lugar de FROM | STATS.
¿Puedo reutilizar mis consultas PromQL?
En parte: el comando PROMQL acepta PromQL, pero no todos los operadores. Pruebe cada regla antes de migrar.
Conclusión
El comando TS da a ES|QL un vocabulario de métricas: tasas, deltas, dos niveles de agregación. Compruebe su versión, parta de una consulta sencilla y valide sobre un gráfico conocido. Para profundizar en el lado de Prometheus, vea Prometheus y Dynatrace en Kubernetes.
Este artículo procede de un blog independiente, no afiliado a Dynatrace LLC ni a Elastic N.V. Elasticsearch y Elastic son marcas de Elastic N.V. Dynatrace es una marca de Dynatrace LLC. Cifras y estados citados proceden de la documentación y del blog de Elastic, no de mediciones de span.observer. Compruebe siempre los valores en la documentación oficial correspondiente a su versión.