Module 1 de la Formation SLO SLA : le trio SLI SLO SLA défini simplement, ce qui les distingue, et les deux confusions qui faussent la plupart des premiers objectifs de fiabilité.
Parcours : Formation SLO SLA · Module 1/6 · Durée : ~30 min · Niveau : Débutant
Objectifs :
- Définir un SLI, un SLO et un SLA sans les confondre
- Exprimer un SLI comme un ratio d’événements bons sur événements valides
- Relier un SLO à son budget d’erreur
- Repérer les erreurs fréquentes : SLO égal au SLA, objectif à 100 %
Prérequis : aucun. Un service en production que vous connaissez aide pour l’exercice.
Une équipe annonce « 99,9 % de disponibilité » dans une réunion. Le service commercial comprend une promesse au client, l’équipe produit un objectif interne, l’équipe d’exploitation une moyenne de ping. Trois personnes, trois chiffres différents derrière le même pourcentage. Ce flou coûte cher le jour où un client réclame un avoir.
Ce module fixe le vocabulaire utilisé dans tout le parcours. Les définitions suivent celles du livre Site Reliability Engineering de Google, devenues la référence du métier. Elles sont indépendantes de l’outil : elles valent pour Dynatrace SaaS comme pour Dynatrace Managed, dont la mise en œuvre est traitée aux modules 3 et 4.
SLI SLO SLA : trois niveaux, trois rôles
| Terme | Ce que c’est | Qui le possède | Exemple |
|---|---|---|---|
| SLI (Service Level Indicator) | Une mesure de la qualité du service vue par l’utilisateur | L’équipe technique | Part des requêtes HTTP servies sans erreur 5xx |
| SLO (Service Level Objective) | Une cible pour ce SLI, sur une fenêtre de temps | L’équipe produit et l’équipe technique | 99,9 % de requêtes réussies sur 30 jours glissants |
| SLA (Service Level Agreement) | Un engagement contractuel, avec des conséquences s’il n’est pas tenu | Le juridique et le commercial | 99,5 % par mois civil, sinon avoir de 10 % sur la facture |
Retenez l’ordre : on mesure (SLI), on se fixe un objectif (SLO), on s’engage auprès d’un tiers (SLA). Un SLA sans SLI fiable derrière est une promesse que personne ne sait vérifier.
Le SLI : un ratio, pas une métrique brute
Un bon SLI s’écrit comme un rapport entre événements « bons » et événements « valides », multiplié par 100 :
SLI = (événements bons / événements valides) × 100Cette forme a trois avantages : elle reste entre 0 et 100 %, elle se compare d’un service à l’autre et elle se transforme directement en budget d’erreur. Les familles de SLI les plus courantes :
- Disponibilité : requêtes sans erreur serveur / requêtes reçues ;
- Latence : requêtes servies en moins de 300 ms / requêtes reçues ;
- Fraîcheur : lectures renvoyant une donnée de moins de 10 minutes / lectures ;
- Exactitude : traitements au résultat correct / traitements.
Le mot « valides » compte : on exclut souvent les requêtes de santé des sondes ou les erreurs 4xx provoquées par le client. Le choix des SLI pour un service donné est détaillé dans l’article choisir ses SLI avec DQL.
Dans Dynatrace SaaS, un SLI se calcule en DQL. La documentation de l’app Service-Level Objectives donne cet exemple de taux de succès d’un service :
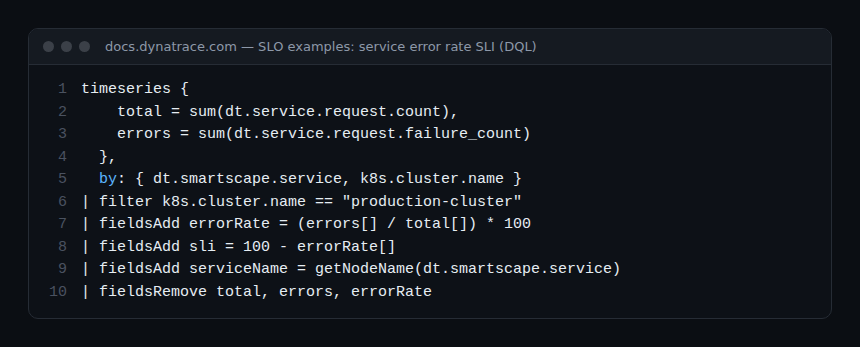
On y retrouve la forme ratio : errorRate = errors / total × 100, puis sli = 100 - errorRate. Dans Dynatrace Managed, le même calcul passe par une metric expression dans les SLO classiques (module 4).
Le SLO : une cible sur une fenêtre
Un SLO combine trois éléments : un SLI, une cible en pourcentage et une fenêtre de temps. « 99,9 % » seul n’est pas un SLO. « 99,9 % des requêtes de l’API de paiement réussissent, mesuré sur 30 jours glissants » en est un.
La cible se choisit d’après ce que les utilisateurs remarquent et ce que l’historique montre, pas d’après ce qui sonne bien. Partir de la performance réelle des 4 dernières semaines puis ajuster est la méthode la plus sûre.
Le SLA : un contrat
Le SLA reprend un indicateur, souvent plus grossier (disponibilité mensuelle), et y attache des conséquences : avoirs, pénalités, droit de résiliation. Il se négocie avec un client et se rédige avec le juridique. Le module 6 décrit ses clauses usuelles.
Le budget d’erreur en une phrase
Le budget d’erreur est la part d’échec que le SLO autorise : budget = 100 % − cible. Avec un SLO de 99,9 %, vous avez le droit d’échouer sur 0,1 % des événements de la fenêtre. Tant qu’il reste du budget, l’équipe peut livrer et prendre des risques ; quand il est épuisé, la fiabilité passe en priorité. Le module 2 transforme ce pourcentage en minutes et en requêtes ; le module 5 en fait une politique.
Erreurs fréquentes
Confondre SLO et SLA
Si le SLO interne vaut le SLA, l’équipe découvre la violation au moment où elle coûte de l’argent. Le SLO doit être plus strict que le SLA : par exemple SLO à 99,9 % pour un SLA à 99,5 %. L’écart laisse le temps de réagir avant la pénalité.
Viser 100 %
Un objectif de 100 % donne un budget nul : la moindre erreur viole le SLO, chaque livraison devient un risque inacceptable et l’équipe arrête de livrer. C’est aussi un objectif invisible pour l’utilisateur, dont le réseau mobile ou le Wi-Fi échoue bien plus souvent que votre service. Chaque « 9 » supplémentaire divise le budget par dix et coûte beaucoup plus cher à tenir.
Mesurer ce qui est facile au lieu de ce qui compte
Le CPU d’un hôte ou le résultat d’un ping ne disent pas si l’utilisateur a pu payer. Préférez une mesure au plus près de l’utilisateur : requêtes au point d’entrée, transactions synthétiques ou parcours réels, comme dans l’article sur les SLO de parcours utilisateur.
Trop de SLO
Vingt SLO par service, personne ne les regarde. Commencez par un ou deux SLO par parcours critique : disponibilité et latence.
Bonnes pratiques
- Écrivez chaque SLI sous forme de ratio bons / valides, avec la liste des exclusions.
- Notez toujours la fenêtre avec la cible.
- Gardez un écart entre SLO interne et SLA externe.
- Faites valider la cible par l’équipe produit, pas seulement par l’exploitation.
Exercice pratique
Étape 1 — Choisir un parcours
Prenez un parcours critique de votre service (connexion, paiement, recherche). Résultat attendu : une phrase qui décrit ce que l’utilisateur veut accomplir.
Étape 2 — Écrire deux SLI
Rédigez un SLI de disponibilité et un SLI de latence sous forme de ratio, avec les événements exclus. Résultat attendu : deux formules du type « requêtes POST /payment sans 5xx / requêtes POST /payment hors sondes ».
Étape 3 — Fixer un SLO
Choisissez une cible et une fenêtre pour chaque SLI. Résultat attendu : deux SLO complets, cible et fenêtre comprises, sans 100 %.
Étape 4 — Vérifier l’écart avec le SLA
Si votre service a un SLA, comparez sa cible à votre SLO. Résultat attendu : un SLO plus strict que le SLA ou une note à remonter.
Quiz
- Lequel est un engagement contractuel ? a) SLI b) SLO c) SLA
- Quel budget d’erreur donne un SLO de 99,5 % ? a) 0,05 % b) 0,5 % c) 5 %
- Quelle forme donner à un SLI ? a) Une valeur brute de CPU b) Un ratio événements bons / valides c) Un nombre d’incidents
- Pourquoi éviter un SLO à 100 % ? a) L’outil le refuse b) Le budget est nul et bloque toute livraison c) Il est trop facile à atteindre
Corrigé
- c) Le SLA engage vis-à-vis d’un client.
- b) 100 − 99,5 = 0,5 %.
- b) Le ratio se compare et se convertit en budget.
- b) Aucune erreur n’est permise.
Pour aller plus loin
- Choisir ses SLI avec DQL
- Un tableau de bord SLO pour la direction
- SLO : Dynatrace, Grafana et Prometheus comparés
- Documentation Dynatrace — exemples de SLO
- Google SRE Book — Service Level Objectives
Sommaire du parcours · Module 2 : calcul du budget d’erreur →
Questions fréquentes
Un SLO peut-il exister sans SLA ?
Oui, c’est même le cas le plus courant. La plupart des services internes ont des SLO mais aucun contrat. Le SLO sert à piloter l’équipe ; le SLA n’existe que face à un client.
La disponibilité doit-elle se mesurer en temps ou en requêtes ?
Les deux existent. Le ratio de requêtes reflète mieux ce que vivent les utilisateurs ; le ratio de minutes « bonnes » est plus simple à expliquer dans un contrat. Le module 2 compare les deux.
Combien de SLO par service ?
Un ou deux par parcours critique suffisent pour commencer. Ajoutez-en seulement si une décision en dépend.
Vous avez le vocabulaire : un SLI mesure, un SLO vise, un SLA engage, et le budget d’erreur est l’écart entre la cible et 100 %. Le module suivant fait les calculs : minutes, fenêtres et burn rate.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Ce parcours ne remplace pas les formations officielles de Dynatrace University. Vérifiez les fonctionnalités dans la documentation officielle de votre version.