« On passe sur la nouvelle plateforme, qu’est-ce qui casse ? » C’est la question que pose toute équipe qui a construit des années de configuration Dynatrace Classic : règles d’auto-tagging, Management zones, tokens d’API, dashboards. Comparer Grail vs Classic, c’est surtout comprendre trois changements de fond : l’architecture des données, les permissions et les tags.
Ces changements ne sont pas cosmétiques. Une Management zone qui servait à la fois de filtre et de contrôle d’accès n’a pas d’équivalent unique : elle se décompose en buckets, en policies IAM et en segments. Mal anticipée, la migration laisse des équipes sans accès à leurs logs, ou au contraire avec trop d’accès, en plein incident.
Cet article fait le point, sources officielles à l’appui. Il concerne Dynatrace SaaS en cours de passage vers la plateforme récente (« Latest Dynatrace »). Dynatrace Managed reste sur le modèle Classic : Management zones, auto-tagging et tokens classiques y restent la norme, et notre article migrer de Managed vers SaaS traite le passage complet.
Grail vs Classic : l’architecture en un tableau
Dans Classic, on part d’une entité (un hôte, un service) trouvée par son tag, puis on regarde ses données. La documentation qualifie ce modèle d’« entity-first ». Avec Grail, le modèle devient « data-first » : les champs et tags sont posés sur chaque signal (log, métrique, span, événement), et on interroge directement la donnée en DQL.
| Sujet | Dynatrace Classic | Latest Dynatrace (Grail) |
|---|---|---|
| Stockage et requête | APIs et requêtes par type de donnée (metric selector, USQL) | Grail, data lakehouse unique, interrogé en DQL |
| Partitionnement | Management zones (logique) | Buckets : rétention, performance, licence, conformité |
| Contrôle d’accès | Permissions par Management zone | IAM à base d’attributs (ABAC), appliqué à la requête |
| Filtrage global | Management zones | Segments, construits par dimensions |
| Contexte organisationnel | Règles d’auto-tagging sur les entités | Primary Grail fields et primary Grail tags posés à la source |
| Exploration | Data Explorer, Multidimensional analysis | Notebooks (DQL) |
| Tokens d’API | Access tokens, en-tête Api-Token |
Platform tokens, en-tête Bearer |
La documentation résume la fin des Management zones ainsi : elles sont remplacées par trois concepts, le partitionnement des données (buckets), le contrôle d’accès (IAM) et la segmentation (segments). Pour les bases de Grail, voyez le module 1 de la formation SaaS.
Ce qui change pour les tags : primary Grail tags et primary Grail fields
Ce qui ne passe pas dans les apps récentes
Trois mécanismes Classic ne sont pas repris par les apps de la plateforme récente :
- Règles d’auto-tagging basées sur les entités : sans effet sur Smartscape on Grail, utilisées par aucune app récente ; elles restent sur les pages Classic pour compatibilité.
- Management zones : prises en charge par aucune fonctionnalité de plateforme ; elles aussi ne restent que sur les pages Classic.
- Naming rules de services, hôtes et process groups (
builtin:naming.services) : elles seront retirées ; les dashboards, SLO et alertes existants continuent de fonctionner pendant la transition.
Ce qui les remplace
Beaucoup de valeurs que l’on extrayait par auto-tagging sont déjà des primary Grail fields, ajoutés à chaque signal sans configuration : dt.host_group.id, k8s.namespace.name, k8s.cluster.name, aws.account.id, azure.subscription. Pour le reste (équipe, application, centre de coût), on pose des primary Grail tags primary_tags.<clé> au déploiement. Selon la documentation, la configuration centrale des primary Grail tags couvre environ 80 % des cas d’usage d’auto-tagging et de Management zones Classic.
La propagation devient automatique : un primary_tags.* défini au niveau de l’hôte se retrouve dans les logs, métriques, spans et événements des nœuds Smartscape concernés, et dans les problèmes qu’ils déclenchent. Au niveau processus, on le pose avec la variable DT_TAGS. Les règles de propagation Classic, sujettes à erreur, disparaissent. Si votre organisation repose aujourd’hui sur des Management zones et l’auto-tagging, c’est ce chantier qui prend le plus de temps.
Ce qui change pour les permissions
Dans Classic, les permissions d’un groupe se donnent par environnement et par Management zone, comme décrit dans notre article sur les utilisateurs, groupes et permissions. Avec Grail, l’accès se décrit dans des policies IAM créées dans Account Management, à plusieurs niveaux :
- Bucket : toute permission commence par
storage:buckets:read, éventuellement restreinte parWHERE storage:bucket-name. - Table : une permission par type de donnée, par exemple
storage:logs:read,storage:spans:read,storage:metrics:read,storage:events:read,storage:entities:read,storage:smartscape:read. - Enregistrement : une condition sur un champ, comme
storage:k8s.namespace.name,storage:dt.host_group.idoustorage:dt.security_context.
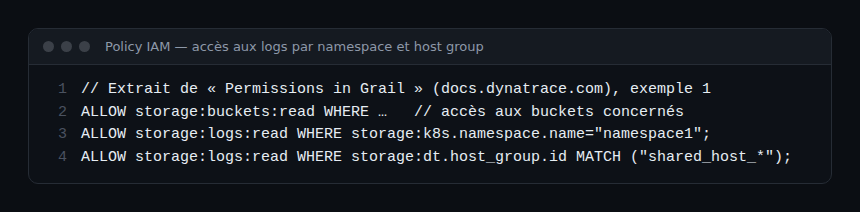
Point d’attention : si le champ peut contenir un tableau (plusieurs contextes de sécurité), seule la condition MATCH fonctionne ; =, IN ou STARTSWITH renvoient alors toujours faux. Et les segments ne remplacent pas la partie contrôle d’accès des Management zones : la documentation le signale comme un changement cassant. Le filtrage et la sécurité sont désormais deux sujets séparés.
Le cas des tokens d’API
Les access tokens Classic laissent place aux platform tokens, liés à un utilisateur ou à un service user et gérés dans Account Management. Trois conséquences pratiques : l’en-tête passe de Authorization: Api-Token <token> à Authorization: Bearer <platform-token> ; l’endpoint v2/apiTokens n’existe plus dans un environnement entièrement « latest » ; les limites sont de 50 tokens par utilisateur et 100 par service user, par compte. Rattachez les intégrations à des service users.
En pratique : préparer la bascule
Étape 1 — Décomposer les Management zones
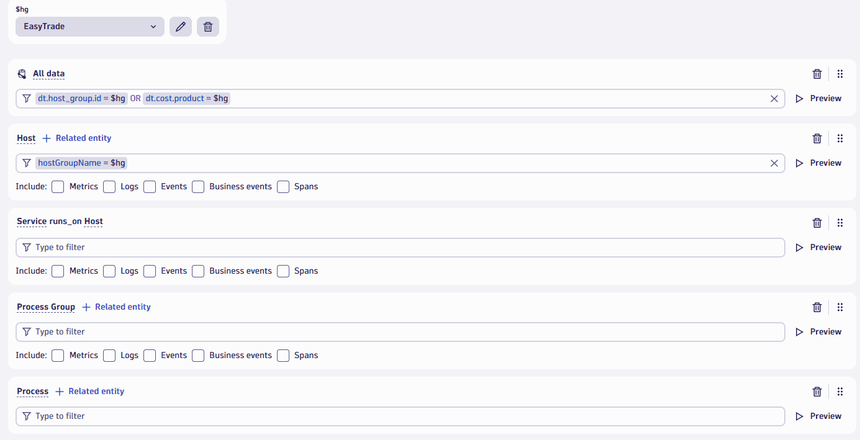
Une zone easytrade_prod encode deux dimensions, app et stage. Listez vos zones et extrayez ces dimensions : chacune deviendra une dimension de segment et, si besoin, une condition de policy.
Étape 2 — Enrichir à la source
Sur un hôte dédié à une application, le host group suffit souvent, complété par des propriétés d’hôte comme dt.security_context, dt.cost.costcenter, dt.cost.product ou primary_tags.<clé>. On les pose en masse depuis Deployment Status > OneAgents, action modify host properties, ou hôte par hôte :
sudo /opt/dynatrace/oneagent/agent/tools/oneagentctl \
  --set-host-tag=dt.security_context=team-payments
Les logs sont enrichis après le redémarrage du module de logs de OneAgent ; les spans demandent un redémarrage de l’application monitorée. Sur un hôte partagé par plusieurs applications, posez les mêmes champs par processus avec DT_TAGS et OTEL_RESOURCE_ATTRIBUTES.
Étape 3 — Écrire les policies, puis les segments
Créez une policy par équipe (buckets, tables, enregistrements), puis les segments dans Settings > Environment segmentation > Segments.
Étape 4 — Migrer les usages
La documentation fournit une table de correspondance : Data Explorer et Multidimensional analysis vers Notebooks, Logs vers l’app Logs sur Grail, Problems vers Problems sur Grail, SLO Classic vers Service-Level Objectives sur Grail (voir migrer ses SLO sur Grail). Certaines capacités n’ont pas encore de remplaçant direct, comme Method Hotspots ou Profiling & Optimization : vérifiez-les avant de couper l’accès Classic.
Comment vérifier que la bascule fonctionne
- Pour chaque équipe, connectez-vous avec un utilisateur de test et lancez
fetch logs | summarize count(), by: { k8s.namespace.name }: seuls les namespaces autorisés doivent apparaître. - Vérifiez qu’un champ posé à la source est bien présent :
fetch logs | filter isNotNull(dt.security_context) | limit 10. - Appliquez chaque segment dans un Notebook et comparez le volume avec l’ancienne Management zone.
Bonnes pratiques
- Séparez clairement filtrage (segments) et sécurité (policies) ; ne comptez pas sur un segment pour cacher des données.
- Utilisez
MATCHdans les policies dès qu’un champ peut porter plusieurs valeurs. - Enrichissez à la source plutôt qu’avec des règles a posteriori : moins de toil, moins de règles fragiles liées aux conventions de nommage.
- Inventoriez les tokens Classic par identifiant, pas par nom : les noms ne sont pas uniques.
Questions fréquentes
Les Management zones disparaissent-elles du jour au lendemain ?
Non. Elles restent disponibles sur les pages Classic pour compatibilité, mais aucune app de la plateforme récente ne les utilise. Les nouveaux usages doivent passer par les segments et l’IAM.
Faut-il réécrire toutes les règles d’auto-tagging ?
Pas toutes. Les valeurs d’infrastructure (host group, namespace, cluster, compte cloud) sont déjà des primary Grail fields. Ne recréez que le contexte organisationnel, sous forme de primary Grail tags.
Ces changements concernent-ils Dynatrace Managed ?
Non. Managed n’a pas Grail : Management zones, auto-tagging, permissions par zone et access tokens restent le modèle en vigueur.
Conclusion
Grail vs Classic, ce n’est pas un changement d’écran : on passe d’un modèle centré sur les entités à un modèle centré sur la donnée, où l’accès se décrit dans l’IAM, le filtrage dans les segments, et le contexte dans les tags posés à la source. Commencez par décomposer vos Management zones et enrichir vos signaux. La documentation Things to know before upgrading et la page Permissions in Grail détaillent chaque étape.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Dynatrace est une marque de son propriétaire. Les fonctionnalités SaaS évoluent vite : vérifiez leur disponibilité dans votre environnement et dans la documentation officielle.