Error Inspector Dynatrace est souvent cité comme « l’outil des erreurs », mais il ne couvre qu’une partie du sujet. Selon la documentation, c’est une application de la plateforme Dynatrace (SaaS, dernière génération) qui sert à découvrir, suivre et analyser les erreurs front-end des applications web et mobiles. Les erreurs côté services (HTTP 5xx, exceptions) relèvent d’un autre mécanisme : la détection de défaillance des services.
Confondre les deux mène à des discussions sans fin en incident : « Dynatrace dit 2 % d’échecs, le navigateur en voit 8 % ». Les deux chiffres peuvent être justes, parce qu’ils ne comptent pas la même chose. Comprendre quels codes d’erreur sont comptés, de quel côté et par quel réglage, c’est la condition pour bâtir un SLI de disponibilité qui tienne.
Ce guide clarifie trois couches : la détection de défaillance des services (Managed et SaaS), les erreurs de requête en RUM Classic avec ses codes spéciaux 970–979 (Managed et SaaS), et l’application Error Inspector (SaaS uniquement).
Error Inspector Dynatrace : ce que fait réellement l’application
Error Inspector est une app de la plateforme, qui demande que le RUM soit activé pour les frontends web et mobiles. Elle comporte deux pages :
- Overview : nombre d’erreurs dans le temps, découpé par frontend (les 10 premiers) ou par type d’erreur (erreur de requête, exception, erreur CSP), puis répartitions par
error.type,os.name,url.provider(première ou tierce partie),browser.nameetdt.rum.user_type(real_user, robot, synthetic) pour le web,app.short_versionpour le mobile. Chaque graphique s’ouvre dans un Notebook (Edit in Notebook), s’épingle sur un dashboard ou exporte sa requête DQL (Open With). - Explorer : les erreurs regroupées sur tous les frontends, triées par nombre d’utilisateurs touchés. Les filtres sont conservés dans l’URL, ce qui permet de partager une analyse avec un collègue autorisé.
Dans le détail d’une erreur, on trouve la pile d’appels (lisible seulement si les source maps ou fichiers de symboles ont été envoyés, par API ou par l’interface classique), le tableau Affected pages, et un tableau Occurrences qui ouvre la session dans Users & Sessions et, si elles existent, les traces dans Distributed Tracing. Le bouton Send transmet un résumé structuré à Jira, Microsoft Teams ou par e-mail via les connecteurs Workflows.
Ce qu’Error Inspector n’est pas : un outil d’analyse des erreurs de services back-end, ni une fonctionnalité de Dynatrace Managed.
Côté services : quels codes HTTP sont des erreurs ?
Par défaut, la détection de défaillance des services compte :
- les exceptions (Java, .NET, Node.js, PHP) qui interrompent l’appel de service ;
- les pages d’erreur des conteneurs web pour les exceptions gérées ;
- les codes 500–599 comme erreurs côté serveur ;
- les codes 400–599 comme erreurs côté client.
Pourquoi le côté client inclut-il les 5xx ? Question de perspective : pour le serveur, un 4xx est une faute du client ; pour le client, un 5xx reste une erreur même si ce n’est pas sa faute. Deux cas particuliers sont désactivés par défaut : l’absence de code de réponse (appel « fire and forget », timeout) et le 404, classé comme lien cassé côté client.
Ces règles alimentent les métriques que vous utilisez dans les SLO et les alertes. Dans Managed, par exemple : builtin:service.errors.server.rate, builtin:service.errors.client.rate, builtin:service.errors.fivexx.count et builtin:service.errors.fourxx.count. Changer la détection, c’est donc changer la valeur de vos SLI : à faire en connaissance de cause.
En pratique : ajuster la détection de défaillance
Étape 1 — Choisir le niveau
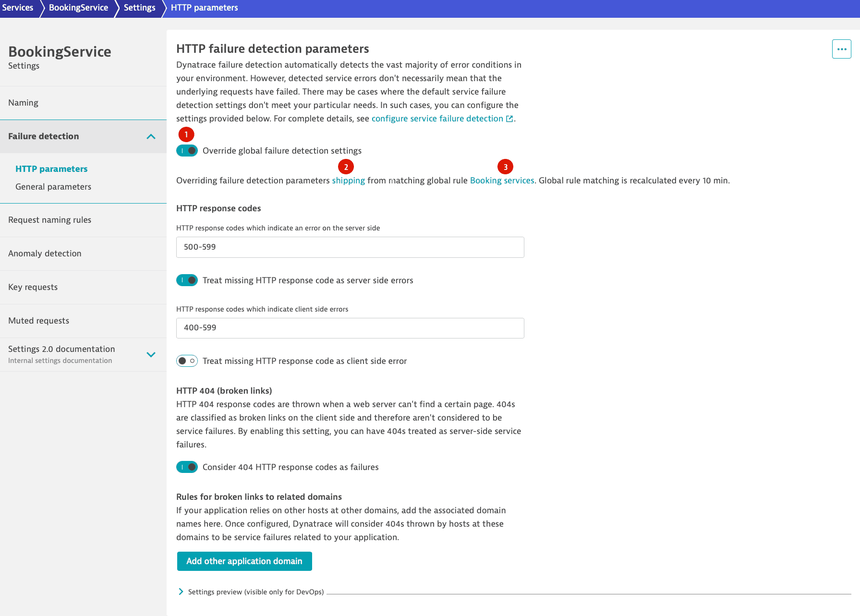
La configuration se fait globalement (Settings > Server-side service monitoring > Failure detection rules et Failure detection parameters) ou par service. Les réglages d’un service priment sur le global. Les règles globales sont évaluées de haut en bas, la première qui correspond s’applique, et la correspondance est recalculée toutes les 10 minutes. Elles ne s’appliquent pas aux services de type span ni aux unified services.
Étape 2 — Régler un service
- Ouvrez Services, sélectionnez le service, puis More (…) > Settings.
- Allez dans Failure detection > HTTP parameters (ou General parameters pour les exceptions).
- Activez Override global failure detection settings, puis ajustez les plages de codes (plusieurs plages séparées par des virgules, par exemple
400-402, 405-417), le traitement des codes absents et l’option Consider 404 HTTP response codes as failures.
Étape 3 — Traiter les exceptions métier
Dans General parameters : les Success forcing exceptions rendent la requête réussie quoi qu’il arrive (client qui abandonne), les Ignored exceptions ne marquent pas l’échec mais laissent le code HTTP décider, et les Custom handled exceptions forcent l’échec d’une exception gérée silencieusement par le code. Pour une erreur métier sans exception ni code HTTP, une custom error rule s’appuie sur un request attribute.
Étape 4 — Versionner par l’API Settings
Deux schémas : builtin:failure-detection.environment.parameters (jeux de paramètres) et builtin:failure-detection.environment.rules (règles qui les affectent aux services), avec les scopes settings.read et settings.write. Extrait d’un jeu de paramètres :
[{
  "schemaId": "builtin:failure-detection.environment.parameters",
  "scope": "environment",
  "value": {
    "name": "API publique",
    "httpResponseCodes": {
      "serverSideErrors": "500-599",
      "failOnMissingResponseCodeServerSide": false,
      "clientSideErrors": "401-402,405-499",
      "failOnMissingResponseCodeClientSide": false
    },
    "brokenLinks": { "http404NotFoundFailures": false },
    ...
  }
}]
Le corps complet comporte aussi un bloc exceptionRules ; partez de l’exemple de la documentation et de la table du schéma plutôt que d’écrire l’objet à la main.
Côté navigateur : erreurs de requête et codes 970–979 en RUM Classic
En RUM Classic (Managed, et SaaS pour les applications classiques), trois types d’erreurs existent : erreurs de requête, erreurs custom envoyées par l’API JavaScript RUM, et erreurs JavaScript. Par défaut, tous les codes 4xx et 5xx sont des erreurs de requête, ainsi que les violations CSP et les échecs de chargement d’image. C’est l’une des raisons des écarts avec les métriques de services, qui ne comptent que les 5xx côté serveur.
Pour les applications créées à partir de la version 1.238, le JavaScript RUM signale aussi des codes qui ne sont pas des codes HTTP quand le vrai code est inaccessible :
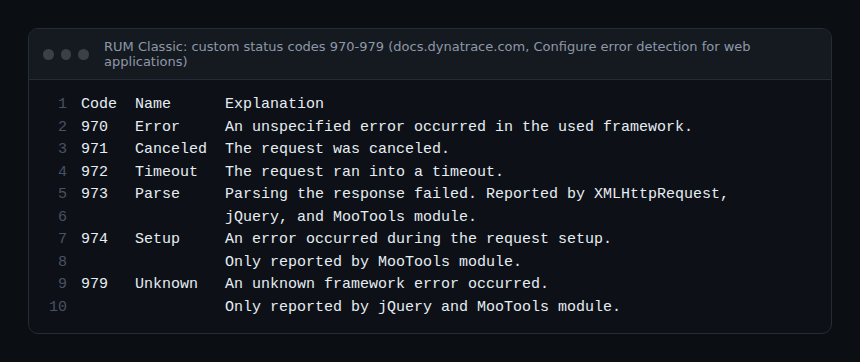
Ces codes comptent dans l’Apdex mais pas dans l’analyse Davis. Un 971 sur un appel de suivi publicitaire annulé n’a pas d’impact ; un 972 sur le paiement en a un. Pour les ignorer, désactivez ou supprimez la règle HTTP 970-979. Pour le reste, une request error rule (Web > application > More (…) > Edit > Errors > Request errors) décide pour un code ou une plage, éventuellement limitée à des URL, s’il faut capturer l’erreur, l’inclure dans l’Apdex et la soumettre à Davis. Les règles s’appliquent dans l’ordre de la liste.
Bonnes pratiques
- Basez le SLI de disponibilité d’un service sur les erreurs côté serveur ; gardez le côté client et le RUM pour l’expérience utilisateur.
- Ne passez pas les 404 en échec globalement : réservez-le aux services où un 404 signale vraiment un défaut.
- Documentez chaque exception ignorée avec la raison et la date ; c’est du bruit en moins, mais aussi un angle mort en plus.
- Envoyez les source maps à chaque déploiement front-end, sinon Error Inspector affiche des piles illisibles.
Comment vérifier que ça fonctionne
- Après un changement de détection, le taux
builtin:service.errors.server.ratedu service évolue dans le Data Explorer à partir de l’heure du changement (le global se recalcule toutes les 10 minutes). - Avec une custom error rule, la requête concernée est marquée en échec et Dynatrace indique que la règle en est la raison.
- En SaaS, la page Overview d’Error Inspector montre la répartition par
error.type; ouvrez le graphique avec Edit in Notebook pour récupérer la requête DQL exacte plutôt que de la réécrire.
Pour relier ces erreurs aux parcours, voir les métriques RUM et Core Web Vitals ; pour remonter d’un échec de service à sa cause, les Distributed traces dans Managed ; pour en faire un objectif, choisir ses SLI. Références officielles : Error Inspector et Configure service failure detection.
Questions fréquentes
Error Inspector est-il disponible dans Dynatrace Managed ?
Non. C’est une app de la plateforme Dynatrace SaaS de dernière génération. Dans Managed, on s’appuie sur la détection de défaillance des services et sur la configuration des erreurs RUM Classic.
Pourquoi le RUM compte-t-il plus d’erreurs que les métriques de service ?
Le RUM Classic compte par défaut tous les 4xx et 5xx, les violations CSP, les images en échec et les codes 970–979, alors que l’erreur côté serveur d’un service ne retient que les 5xx et les exceptions.
Un code 971 signifie-t-il une panne ?
Pas forcément. C’est un code propre au JavaScript RUM (requête annulée), pas un code HTTP. Son impact dépend de la requête : regardez l’URL concernée avant d’alerter.
Conclusion
Error Inspector répond à une question précise : quelles erreurs front-end touchent le plus d’utilisateurs, et pourquoi. Les codes d’erreur des services et du RUM Classic, eux, se règlent dans la détection de défaillance et les request error rules. Alignez ces trois couches, documentez chaque exception, et vos SLI de disponibilité diront enfin la même chose que vos utilisateurs.
span.observer est un blog indépendant de la communauté, non affilié à Dynatrace LLC. Dynatrace est une marque de son propriétaire. Les applications, réglages et valeurs par défaut évoluent selon la version et la plateforme (SaaS ou Managed) : vérifiez-les dans la documentation officielle.