L’ingestion APM Datadog décide quelles traces entrent dans la plateforme ; la rétention décide lesquelles restent consultables. Ces deux réglages sont distincts, et les confondre coûte cher : on pense réduire sa facture en filtrant à un endroit alors que le volume se joue ailleurs. Cet article sépare les étapes du pipeline de traces, d’après la documentation officielle de Datadog.
Il s’adresse aux équipes SRE et plateforme qui exploitent déjà Datadog APM et veulent garder les traces utiles (erreurs, latence élevée) sans payer pour tout le reste. Les valeurs citées viennent des pages de la documentation Datadog consultées le 30 octobre 2026 ; elles peuvent évoluer, vérifiez la page avant de les figer dans un runbook.
En bref
- Ingestion : les spans envoyées par les SDK et l’Agent vers Datadog. Elle se règle avec les contrôles d’ingestion et l’échantillonnage.
- Indexation : parmi les spans ingérées, les filtres de rétention choisissent celles qui sont stockées et recherchables, 15 jours pour les filtres personnalisés.
- Métriques : elles sont calculées à partir des spans ingérées, que ces spans soient indexées ou non.
- Un filtre de rétention ne réduit pas l’ingestion : la documentation le dit explicitement.
Ingestion APM Datadog : trois étapes à ne pas confondre
La page Trace pipeline décrit la chaîne complète : ingestion, pipelines de traitement, indexation et rétention, métriques générées, suivi de l’usage. Pour un SRE, trois questions suffisent à s’y repérer.
- Qu’est-ce qui est envoyé ? C’est l’ingestion. Le SDK et l’Agent décident, trace par trace, de garder ou de rejeter.
- Qu’est-ce qui est stocké et interrogeable ? C’est l’indexation, pilotée par les filtres de rétention.
- Qu’est-ce qui est agrégé en courbes ? Ce sont les métriques, calculées sur ce qui a été ingéré.
Une span rejetée à l’ingestion n’existe plus pour les deux étapes suivantes. D’après la documentation des métriques basées sur les spans, une span écartée par échantillonnage ne peut pas produire de métrique. À l’inverse, une span ingérée mais non indexée alimente quand même ces métriques. Pour la partie RED, voyez notre article sur les métriques de trace Datadog.
Les contrôles d’ingestion : échantillonnage en tête de trace
La page Ingestion Control affiche l’ingestion du mois en cours, la projection de fin de mois par rapport à votre quota, et un tableau par service (traces par seconde et octets par seconde sur la dernière heure). Un graphique par « raison d’ingestion » relie chaque volume à un mécanisme précis.
Par défaut, l’échantillonnage est head-based : la décision est prise sur la span racine et vaut pour toute la trace. Selon la documentation, sans règle définie pour un service, l’Agent vise 10 traces par seconde et calcule lui-même les taux. Vous pouvez changer cette cible dans Datadog ou avec DD_APM_TARGET_TPS (clé target_traces_per_second dans datadog.yaml).
Deux échantillonneurs complètent ce mécanisme pour les traces que l’échantillonnage en tête n’a pas retenues : l’échantillonneur d’erreurs (10 traces d’erreur par seconde et par Agent par défaut, DD_APM_ERROR_TPS) et l’échantillonneur de traces rares (désactivé par défaut, DD_APM_ENABLE_RARE_SAMPLER, Agent 7.41 ou plus récent).
Écrire des règles dans le SDK
Les règles se posent côté application avec DD_TRACE_SAMPLING_RULES, un tableau JSON où sample_rate va de 0 à 1. L’exemple ci-dessous est celui de la documentation : toutes les traces de GET /checkout sont gardées, 20 % des autres traces du service.
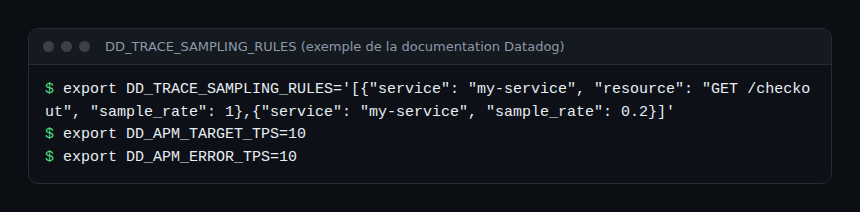
Précédence : d’après la documentation, les réglages du traceur l’emportent sur ceux de l’Agent, et la configuration distante l’emporte sur la configuration locale. Quand un taux ne se comporte pas comme prévu, vérifiez d’abord qui, de l’Agent, du traceur ou de la configuration distante, a le dernier mot.
Lire les raisons d’ingestion
Chaque trace ingérée porte une raison. La page Ingestion Mechanisms en liste plusieurs : auto, rule et manual relèvent de l’échantillonnage en tête ; error et rare viennent des échantillonneurs de l’Agent ; single_span garde des spans isolées ; otel signale des données OpenTelemetry.
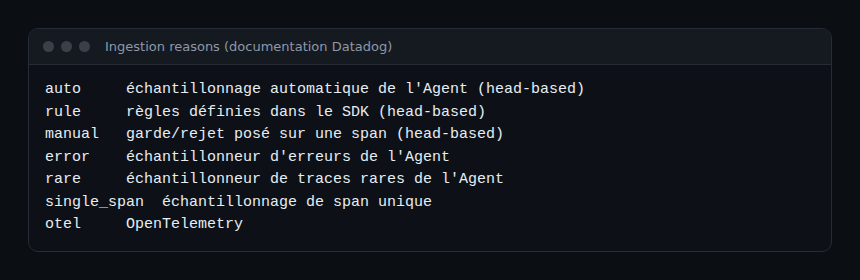
L’échantillonnage de span unique (single_span) garde des spans que l’échantillonnage en tête a écartées, sans conserver la trace entière. Il ne peut pas supprimer des spans déjà retenues. C’est utile pour compter un appel précis sans payer pour les traces complètes.
Filtres de rétention et spans indexées
Une fois la span ingérée, la page Trace retention explique ce qui la rend consultable. Deux familles de filtres coexistent.
Le filtre de rétention intelligent
Il est toujours actif et tourne en parallèle de vos filtres. Il combine deux mécanismes :
- Diversity sampling : au plus toutes les 15 minutes, au moins une trace par combinaison d’environnement, de service, d’opération et de ressource ; les traces aux percentiles p75, p90 et p95 de latence ; une sélection variée d’erreurs (400, 500). Il est orienté vers les erreurs et les latences élevées, ce n’est donc pas un échantillon proportionnel du trafic.
- 1 % flat sampling : environ 1 % des spans ingérées, décidé sur le
trace_idpour qu’une trace reste entière, et les traces liées à 1 % des sessions RUM ingérées.
Selon la documentation, les spans qu’il indexe ne comptent pas dans l’usage de spans indexées et n’affectent donc pas la facture. La page indique une conservation de 30 jours. Le « 1 % » n’est donc pas un taux de conservation global, c’est une part uniforme, complétée par la diversité : un service à faible trafic peut manquer sur de courtes plages.
Les filtres personnalisés
Ils conservent 15 jours. Chaque filtre a une requête de rétention (n’importe quelle étiquette ou attribut de span, comme env:prod ou @duration:>2s), un taux de spans de 0 à 100 % et, en option, un taux de traces qui indexe la trace entière, y compris les spans qui ne correspondent pas à la requête.
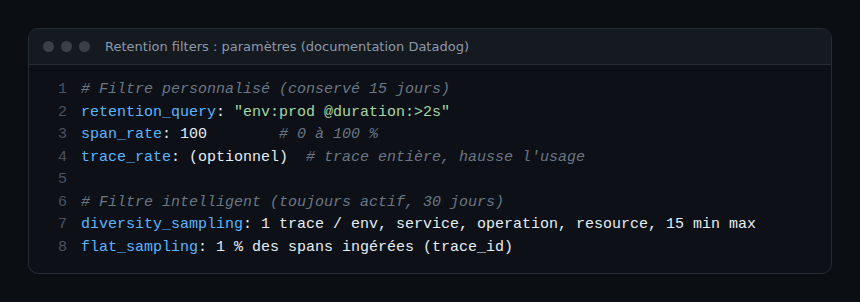
Le taux de spans est évalué en premier ; le taux de traces ne s’applique qu’aux traces qu’il a sélectionnées. La documentation précise qu’il peut augmenter nettement l’usage de spans indexées. Les filtres sont évalués dans l’ordre de la liste : une span retenue par un filtre n’est pas reconsidérée par les suivants.
Surveiller les coûts et l’usage
La métrique datadog.estimated_usage.apm.indexed_spans suit les spans indexées par les filtres personnalisés et par défaut. Les tableaux de bord APM Estimated Usage et Ingestion Reasons montrent les volumes ingérés et indexés. Les tarifs ne sont pas repris ici : consultez la page officielle de tarification de Datadog pour les montants en vigueur.
Cette mesure fait un bon indicateur de santé de la plateforme d’observabilité : suivez-la comme n’importe quel SLI interne, avec une alerte avant que le quota mensuel ne soit épuisé. Une alerte combinant plusieurs conditions se construit avec un composite monitor Datadog.
Étapes pour cadrer votre pipeline de traces
- Ouvrez la page Ingestion Control et repérez les services dont le volume domine, ainsi que la raison d’ingestion principale.
- Décidez, service par service, ce qui doit être gardé à 100 % (chemins critiques, paiement) et ce qui peut descendre, avec des règles
DD_TRACE_SAMPLING_RULES. - Créez des filtres de rétention ciblés (
env:prod, durée élevée, statut d’erreur) plutôt qu’un taux global. - Gardez le filtre intelligent comme filet de sécurité, sans le compter comme un échantillon représentatif.
- Créez des métriques à partir des spans ingérées pour les SLO de long terme, au lieu d’indexer des traces pour compter.
- Revérifiez après chaque changement les raisons d’ingestion et la métrique d’usage indexé.
Comment vérifier que ça fonctionne
Après un changement de règle, regardez le graphique par raison d’ingestion de la page Ingestion Control : le volume attendu doit se déplacer vers la raison rule. Dans le Trace Explorer, cherchez un cas connu (une erreur récente sur le service modifié) et confirmez que sa trace est bien indexée. Si la trace n’apparaît pas, la décision s’est jouée à l’ingestion, pas à la rétention.
Lien avec OpenTelemetry et Dynatrace
Les données OpenTelemetry envoyées à Datadog portent la raison otel dans la liste ci-dessus. Pour comprendre la différence entre échantillonnage en tête et en queue côté OpenTelemetry, voyez notre article sur le tail sampling OpenTelemetry : la logique de décision est différente, puisqu’elle attend la fin de la trace. Pour une vue d’ensemble des deux plateformes, voyez le comparatif Dynatrace et Datadog. Ce texte décrit Datadog ; il ne prétend à aucune équivalence de fonctionnalités avec Dynatrace.
Bonnes pratiques
- Séparez mentalement ingestion, indexation et métriques avant de toucher un réglage.
- Gardez 100 % des traces d’erreur et de forte latence sur les parcours critiques.
- Évitez les taux de traces élevés dans les filtres personnalisés sans mesurer l’impact sur l’usage.
- Documentez les règles dans le dépôt de l’application, pas seulement dans l’interface.
- Révisez les règles à chaque changement de trafic ou de quota.
Questions fréquentes
Quelle est la différence entre ingestion et indexation dans Datadog APM ?
L’ingestion est l’envoi des spans vers Datadog, réglé par l’échantillonnage. L’indexation est le stockage consultable d’une partie des spans ingérées, piloté par les filtres de rétention. Un filtre de rétention ne réduit pas l’ingestion.
Le filtre intelligent garde-t-il vraiment 1 % des traces ?
Non, pas seulement. Il combine un échantillon de diversité, orienté erreurs et latences, et un échantillon uniforme d’environ 1 % des spans ingérées. Ce n’est pas un échantillon proportionnel du trafic.
Peut-on garder des métriques sans indexer les traces ?
Oui. Les métriques basées sur les spans sont calculées sur les spans ingérées, indexées ou non. Elles sont facturées comme des métriques personnalisées, donc évitez les attributs à forte cardinalité.
Conclusion
Pour maîtriser Datadog APM, on règle d’abord l’ingestion, puis on indexe avec des filtres ciblés, et on s’appuie sur les métriques pour le long terme. Vérifiez chaque valeur sur la documentation de votre site Datadog, car les défauts peuvent changer.
- Trace pipeline, documentation Datadog
- Trace retention, documentation Datadog
- Ingestion Control, documentation Datadog
span.observer est un blog indépendant, non affilié à Dynatrace LLC ni à Datadog Inc. Les noms de produits cités appartiennent à leurs propriétaires respectifs ; les valeurs viennent de la documentation Datadog consultée le 30 octobre 2026 et les exemples sont ceux de cette documentation.